[논문리뷰] OracleZoom: On-Policy Self-Distillation Inspired Reference-Constrained Recursive Image Super Resolution
링크: 논문 PDF로 바로 열기
메타데이터
저자: Shubhashis Roy Dipta, Sourajit Saha, Shaswati Saha, Nobin Sarwar
1. Key Terms & Definitions (핵심 용어 및 정의)
- Recursive SR: 고해상도 이미지를 얻기 위해 동일한 SR 모델을 반복적으로 적용하여 이미지의 배율을 점진적으로 높이는 기술입니다.
- On-Policy Self-Distillation (OPSD): 모델이 자신의 예측값을 다음 단계의 입력으로 사용하는 훈련 방식입니다. 본 논문에서는 훈련 중 생성된 recursive 예측값을 활용하여 학습을 수행합니다.
- Supervision Gap: 재귀적 SR 과정에서 배율이 높아질수록 실측값(Ground Truth) 확보가 현실적으로 불가능해져, 심층 단계에서 직접적인 시각적 감독이 결여되는 현상을 의미합니다.
- KL-Constrained Latent Prior: 모델이 과도하게 왜곡된 고주파 디테일을 생성하지 않도록, 사전 학습된 SR 모델의 잠재 공간(Latent Space) 분포와 학습 중인 모델의 분포 사이의 차이를 KL Divergence로 제어하는 기법입니다.
- EMA (Exponential Moving Average): 학습 과정에서 모델의 파라미터를 점진적으로 업데이트하여 안정적인 일관성을 유지하기 위한 기법으로, 학습 시 모델의 안정성을 향상시킵니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 재귀적 SR에서 배율이 커짐에 따라 발생하는 Supervision Gap 문제를 해결하고자 합니다. 기존의 재귀적 SR 연구는 고배율로 갈수록 필요한 고해상도 데이터의 크기가 기하급수적으로 커져 실측값 확보가 불가능하며, 이로 인해 심층 단계에서 모델이 시각적 근거 없이 디테일을 생성하여 할루시네이션(Hallucination)이 발생하는 한계가 있습니다 [Figure 1]. 저자들은 단순히 텍스트 안내(Prompt)에만 의존하는 기존 방식으로는 복잡한 질감이나 구조적 일관성을 검증할 수 없다고 지적합니다. 따라서 실측값의 한계를 넘어서서도 모델이 시각적 증거를 유지하며 안정적으로 고해상도 출력을 생성할 수 있는 새로운 학습 프레임워크가 필요합니다.
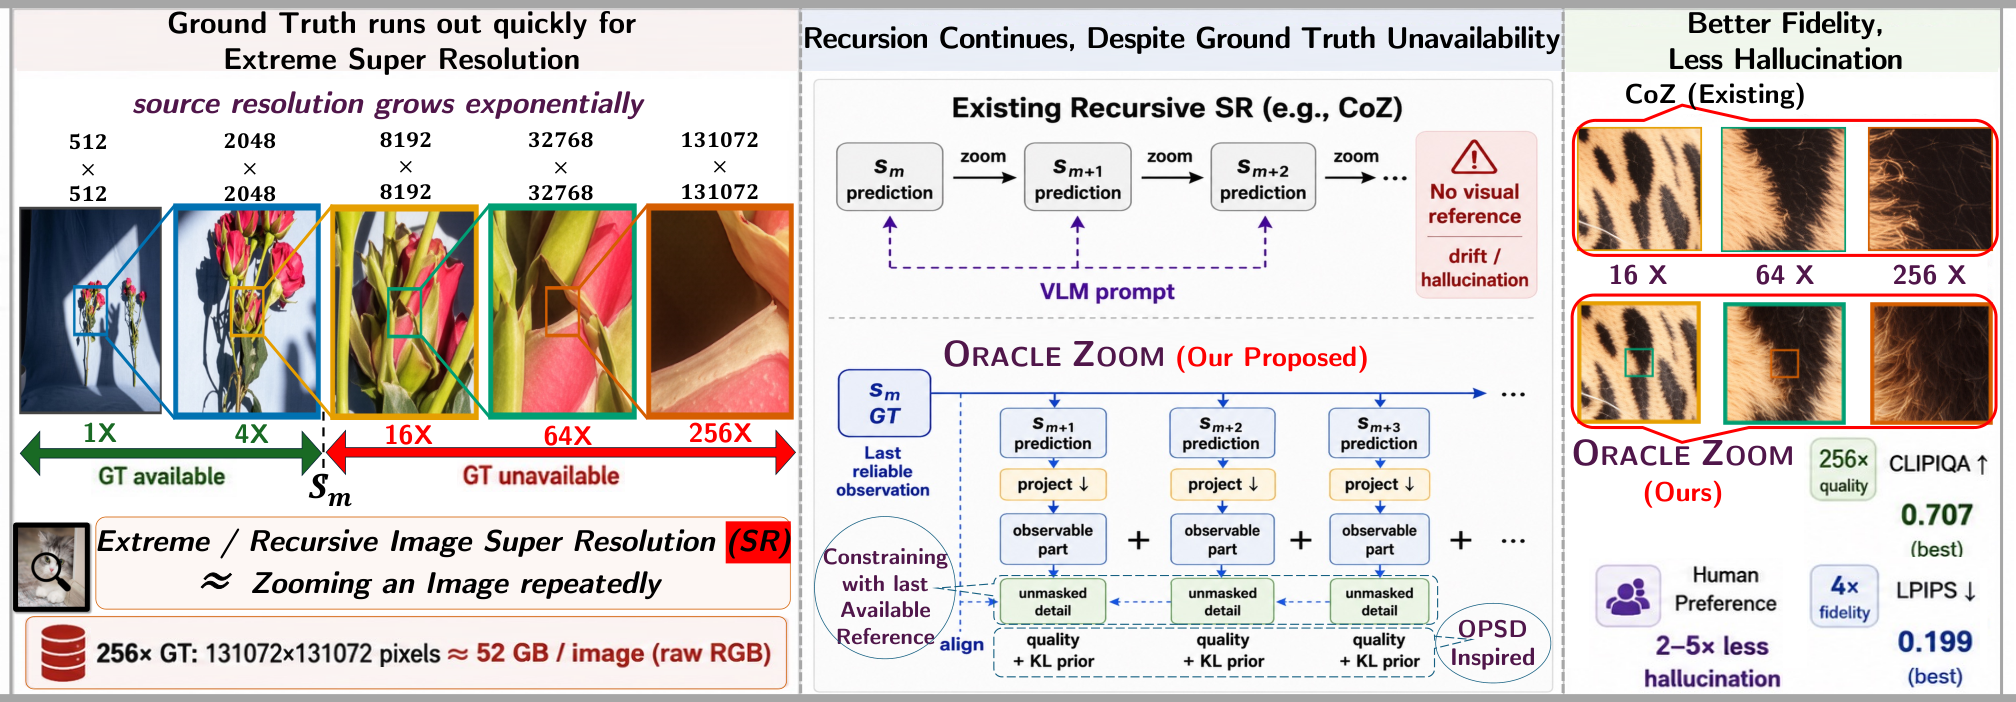
Figure 1 — 재귀적 SR의 감독 한계 및 Oracle Zoom의 해결책
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 마지막 가용 실측값을 고배율 단계까지 참조하는 Oracle Zoom 프레임워크를 제안합니다 [Figure 2]. 이 방법론은 크게 다섯 가지 목적 함수를 통해 타겟이 없는 구간에서도 일관된 고품질 출력을 보장합니다: 1) 가용 실측값을 활용한 Direct Supervision, 2) 심층 예측을 저배율로 투영하여 실측값과 일치시키는 Cross-Scale Consistency, 3) 해상도 향상을 위한 No-reference Quality Guidance, 4) KL-constrained Latent Prior를 통한 잠재 공간 정규화, 5) EMA Consistency를 통한 학습 안정화입니다 [Figure 2]. 실험 결과, Oracle Zoom은 7개의 데이터셋에서 평균 0.713 CLIPIQA를 기록하며 SOTA 성능을 달성했습니다 [Table 2]. 특히 기존 CoZ 모델 대비 심층 단계에서의 할루시네이션을 22-5배 감소시켰으며 [Figure 3], 정성적 평가에서도 동물 털이나 피부 구조와 같은 세밀한 디테일을 더욱 정교하게 복원하는 성능을 입증했습니다 [Figure 3]. 이는 복잡한 질감 복원 시 모델의 안정성을 나타내는 LPIPS 0.199 및 DISTS 0.160 지표에서도 확인됩니다 [Table 2].
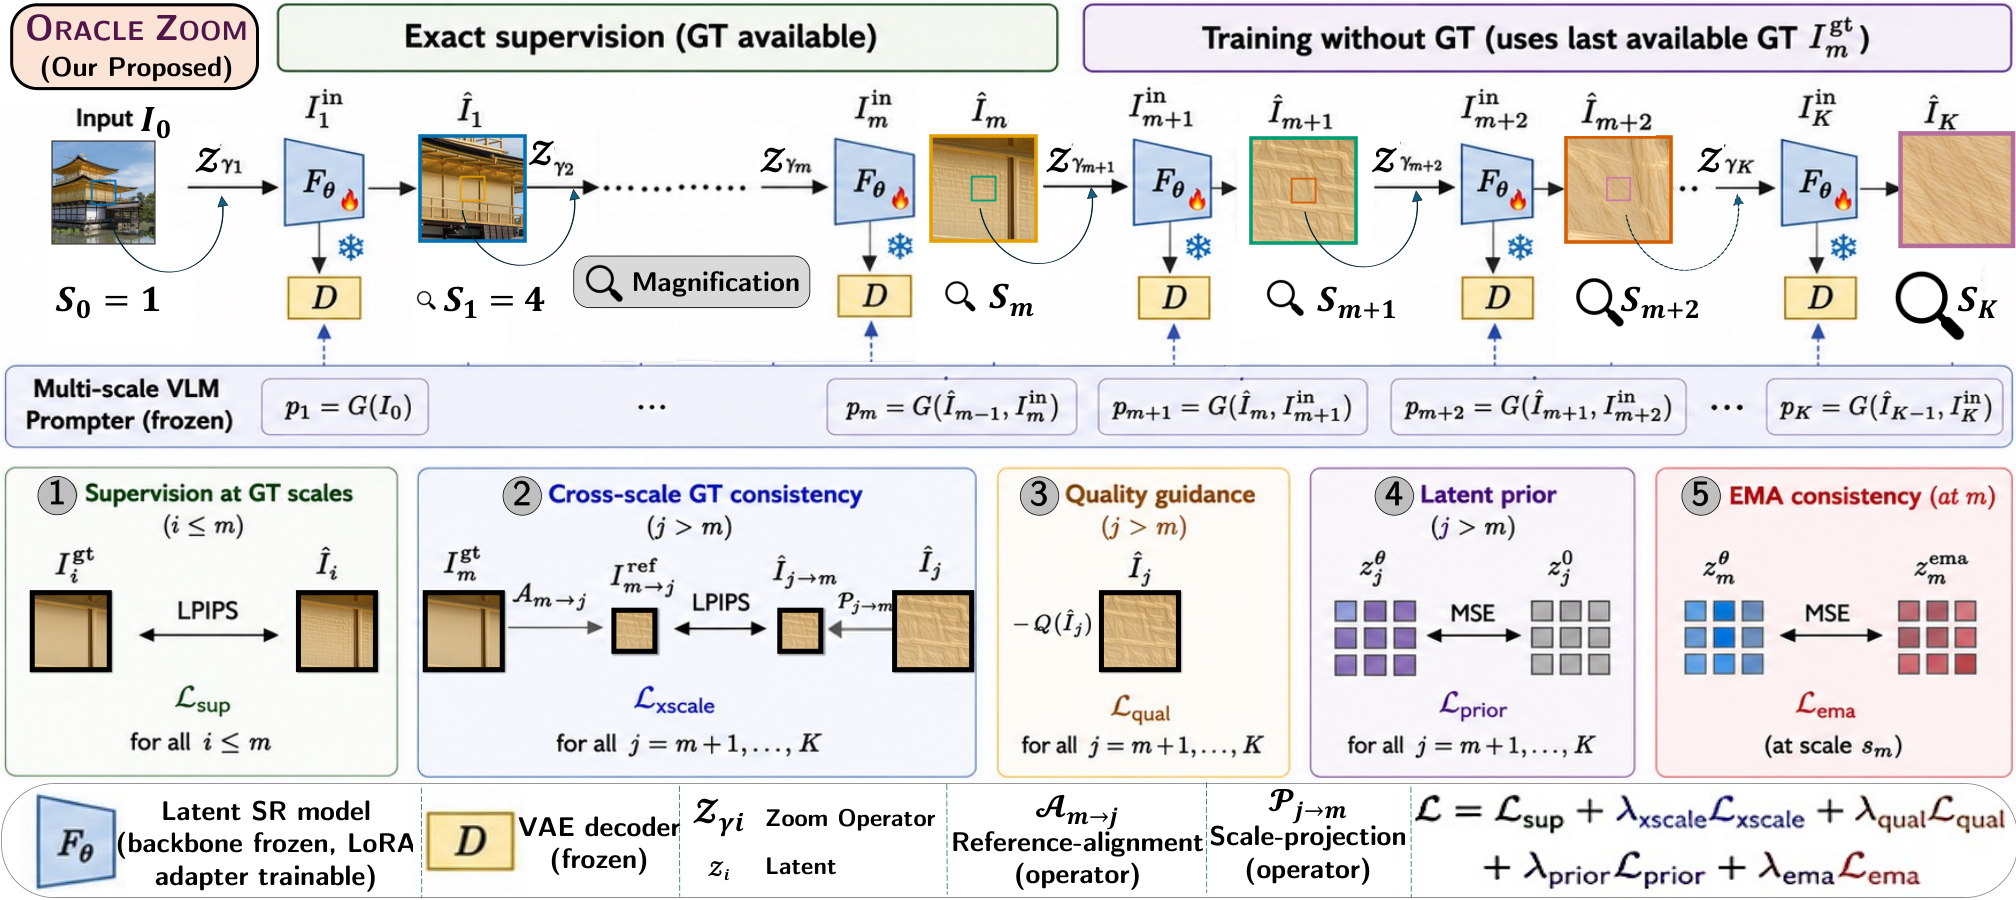
Figure 2 — Oracle Zoom 전체 아키텍처
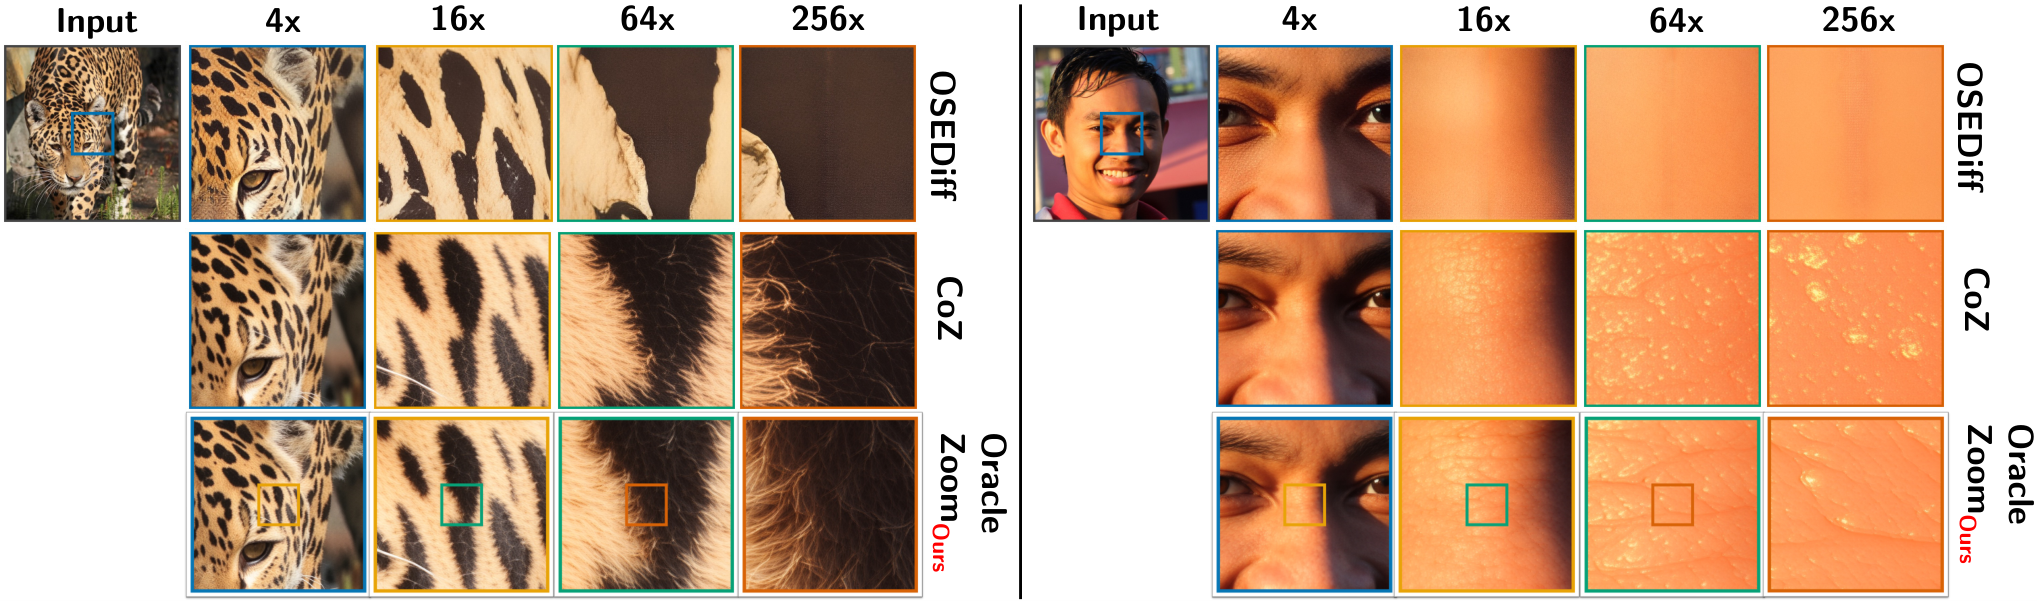
Figure 3 — 모델별 정성적 비교 결과
4. Conclusion & Impact (결론 및 시사점)
본 논문은 재귀적 SR에서 발생하는 심층 단계의 감독 부재 문제를 실측값 기반의 제약과 잠재적 분포 제약을 통해 해결하였습니다. Oracle Zoom은 실측값이 없는 고배율 영역에서도 학습된 지식과 관찰 가능한 증거를 적절히 결합함으로써, 신뢰성 높은 초해상도 영상을 생성할 수 있음을 보여주었습니다. 이 연구는 안전이 중요한 응용 분야에서 재귀적 이미지 확대의 신뢰성을 높이는 데 크게 기여할 것으로 기대됩니다. 또한 본 프레임워크는 대규모 데이터셋에 의존하지 않고도 기존 모델의 잠재력을 최대한 끌어내는 효과적인 학습 전략을 제시함으로써, 추후 초고해상도 복원 연구의 새로운 방향을 제시합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] One Symptom, Three Levers: A Critical Review of On-Policy Self-Distillation
- [논문리뷰] TTPO: Test-Time Policy Optimization
- [논문리뷰] Latent On-Policy Self-Distillation
- [논문리뷰] OPD-V: Visual On-Policy Self-Distillation with Modality Balance
- [논문리뷰] PCSD: Persistent Consistency for Self-Distillation in Agentic Reinforcement Learning
Review 의 다른글
- 이전글 [논문리뷰] From Reweighting to Rewriting: Unlocking the Intervention Effects of Influential Samples in Training Data Attribution
- 현재글 : [논문리뷰] OracleZoom: On-Policy Self-Distillation Inspired Reference-Constrained Recursive Image Super Resolution
- 다음글 [논문리뷰] PlannerForge: LLM Agents for Scenario-Based Testing of Motion Planners in Autonomous Driving
댓글