[논문리뷰] From Reweighting to Rewriting: Unlocking the Intervention Effects of Influential Samples in Training Data Attribution
링크: 논문 PDF로 바로 열기
저자: Yuzhang Luo, Chenpeng Wang, Jianhui Chen, Liangming Pan, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 다루는 핵심 기술 용어 및 개념은 다음과 같습니다:
- Training Data Attribution (TDA): 모델의 특정 동작을 형성하는 데 기여하는 학습 데이터를 식별하는 프로세스를 의미합니다.
- Influence Functions (IF): 특정 학습 예제의 가중치를 미세하게 변경했을 때 학습된 모델 파라미터가 어떻게 변하는지 추정하여, LLM의 예측 및 행동에 대한 기여도를 정량화하는 방법론입니다.
- Supervised Fine-tuning (SFT): 인스트럭션-응답 쌍 데이터를 사용하여 사전 학습된 Large Language Models (LLMs)의 특정 작업 수행 능력을 최적화하는 학습 기법입니다.
- Response Rewriting: IF를 통해 선정된 학습 예제의 Instruction은 유지하되, 해당 예제의 Response를 목표 행동에 부합하거나 반대되도록 수정하는 데이터 개입 전략입니다.
- Reweighting: 선정된 학습 예제의 원본 Supervision 콘텐츠는 변경하지 않고, 훈련 중 해당 예제의 기여도를 조절하기 위해 가중치를 변경(Upweighting 또는 Deletion)하는 기존의 데이터 개입 방식입니다.
- Epistemic Abstention: LLM이 질문에 대한 신뢰할 수 있는 답변을 제공할 수 없을 때(예: 정보 부족, 잘못된 전제) 답변을 유보하는 행동 능력을 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
Large Language Models (LLMs)의 다양한 Capabilities와 Behaviors는 학습 데이터로부터 형성되지만, 어떤 학습 예제가 이러한 Behaviors를 야기하는지에 대한 이해는 부족한 상태입니다. Training Data Attribution (TDA)은 이 질문에 답하기 위해 모델 행동에 영향을 미치는 학습 예제를 식별하는 데 초점을 맞춥니다. 특히, Influence Functions (IF)는 특정 학습 예제의 가중치를 미세하게 변경했을 때 모델의 Behavior가 어떻게 변하는지 추정하는 유용한 도구로 활용되어 왔습니다.
그러나 TDA의 핵심적인 목표인 실행 가능한 데이터 개입(Data Intervention) 측면에서, 기존의 IF 기반 접근 방식(Weight-based Interventions)은 한계를 보였습니다. 즉, IF로 선별된 '영향력 있는(Influential)' 예제들을 Upweighting하거나 Deletion하는 Weight-based Intervention은 종종 무작위 선택(Random Selection) 대비 미미하거나 일관성 없는 Behavioral Changes를 보여주었습니다. 이러한 결과는 IF가 실제로 중요한 예제를 제대로 식별하지 못하는 것인지, 아니면 Weight-based Intervention 자체가 영향력 있는 예제의 잠재적인 Behavioral Leverage를 충분히 활용하지 못하는 것인지에 대한 의문을 제기합니다.
본 연구는 이러한 문제점을 해결하기 위해, IF의 예제 선택 능력과 개입 전략의 효과를 분리하여 평가함으로써, 영향력 있는 예제의 숨겨진 Intervention Leverage를 밝히고자 합니다. [Figure 1]
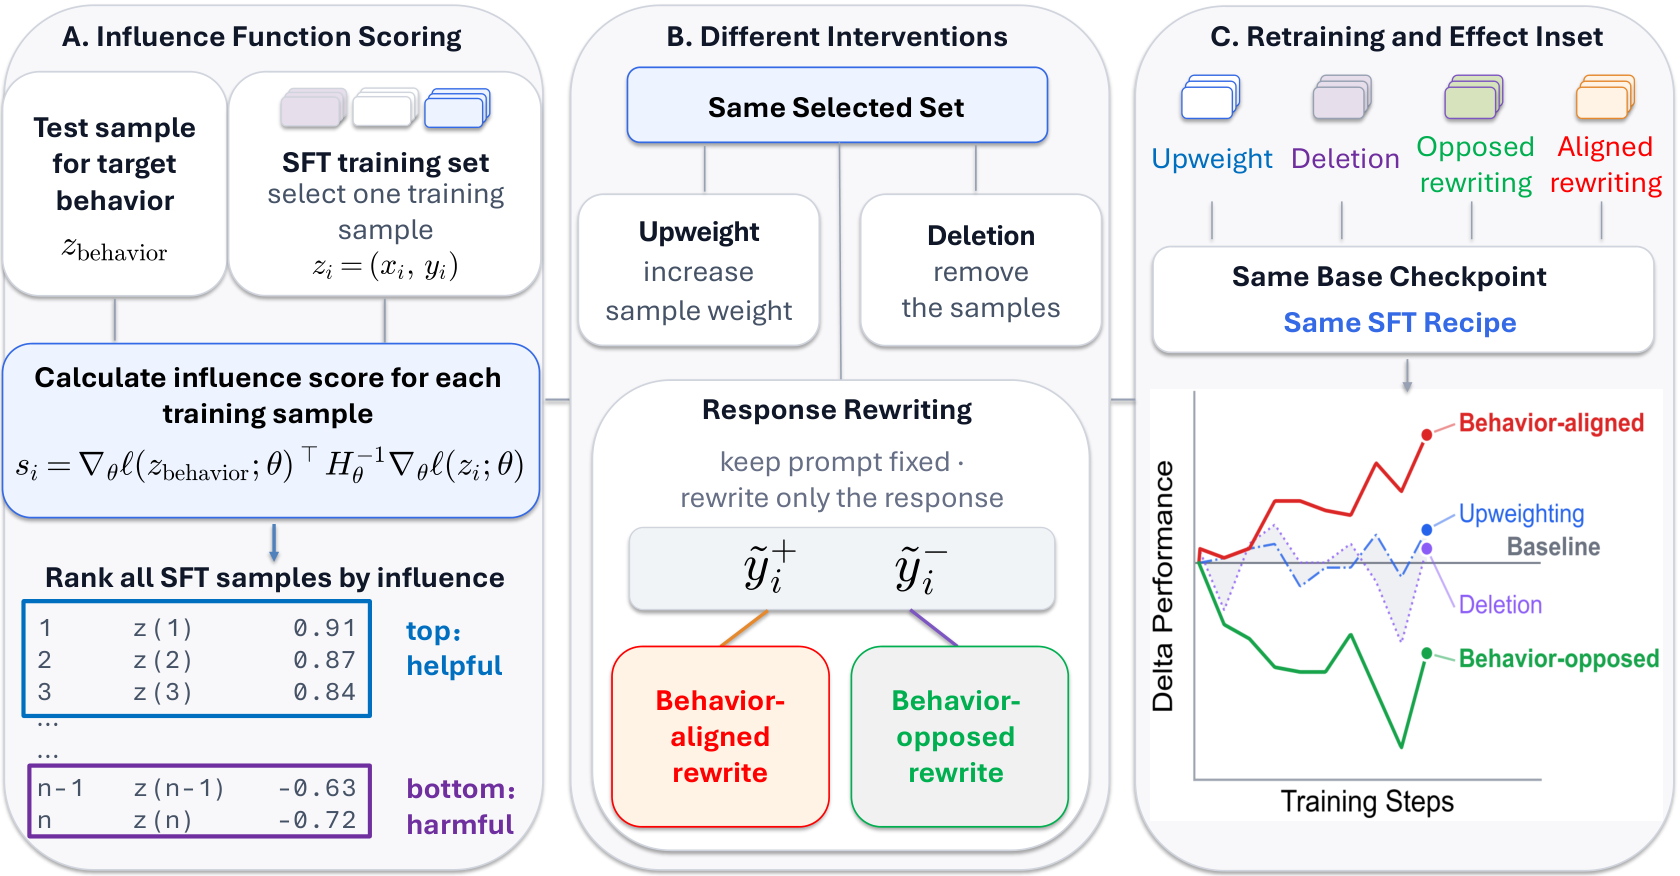
Figure 1 — 제안 프레임워크 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Influence-guided Response Rewriting이라는 새로운 Supervised Fine-tuning (SFT) 개입 프레임워크를 제안합니다. 이 방법론은 Influence Functions (IF)를 사용하여 어떤 학습 예제에 개입할지(Where to intervene)를 식별하고, 해당 예제의 Instruction은 유지한 채 Response를 목표 행동에 부합하거나 반대되도록 수정(What behavioral signal to provide)합니다 [Figure 1]. 이를 통해 기존의 Weight-based Intervention(Reweighting)과 Response Rewriting의 효과를 비교하며, 영향력 있는 예제가 실제로 숨겨진 Behavioral Leverage를 가지고 있는지를 검증했습니다.
실험은 네 가지 Open-weight LLMs (OLMo2-1B, Qwen3.5-2B, Gemma3-4B, OLMo2-7B)를 대상으로 주로 Language Model Abstention Behavior에 대해 수행되었습니다. 주요 실험 결과는 다음과 같습니다:
- Reweighting의 한계: 기존의 Weight-based Intervention(Upweighting 또는 Deletion)은 Influence-selected Examples에 대해 약하고 일관성 없는(weak and inconsistent) 효과를 보였습니다. 이 개입 방식들은 Abstention Recall 변화에서 무작위 선택 대비 신뢰할 만한 이점을 제공하지 못했으며, 때로는 예상과 반대되는 방향으로 Behavioral Changes를 야기하기도 했습니다 [Figure 2, 3]. 이는 Weighting Coefficient
α를 변경해도 일관된 패턴이 나타나지 않았습니다 [Figure 3]. - Response Rewriting의 효과: 반면, Response Rewriting은 동일한 Influence-selected Examples에 대해 훨씬 강력하고, 지속적이며, 양방향적인(stronger, more persistent, and bidirectional) Behavioral Shifts를 일관되게 발생시켰습니다 [Figure 2]. Behavior-aligned Rewriting은 Abstention Recall을 지속적으로 증가시켰고, Behavior-opposed Rewriting은 Recall을 감소시켰으며, 그 효과는 Randomly Selected Examples에 대한 Rewriting보다 훨씬 크고 안정적이었습니다.
- 선택의 우위: Influence-selected Examples는 다른 대안적인 데이터 선택 방법론(예: Projection-based Selection, TRAK, Grad Inner Product)에 비해 더 큰 Rewriting Leverage를 제공했습니다 [Figure 5, 8]. 이는 IF가 단순히 Target Representation과 가장 강하게 일치하는 예제를 선택하는 것이 아니라, Supervision 변경 시 Behavioral Leverage를 발휘할 수 있는 학습 위치를 더 효과적으로 식별함을 시사합니다.
- Rewriting의 메커니즘: Response Rewriting은 Influence-selected Examples의 Local Training Signal을 재지정(Redirect)하며, 이는 Rewriting 후 예측된 Influence Score의 상당한 양의 변화로 확인되었습니다 [Figure 6].
- Targeted Behavioral Change: Rewriting에 의한 Behavior Changes는 Attribution Target과 밀접하게 관련된 시나리오(Answer Unknown, False Premise)에 집중되었고, Non-target 시나리오(Underspecified Context)에는 상대적으로 적은 영향을 미쳐, 전반적인 모델의 Capability Degradation 없이 Target Specificity를 유지함을 보여주었습니다 [Figure 7, 9, 10].
이러한 결과는 Influence-guided Response Rewriting이 기존 Weight-based Intervention의 한계를 극복하고, Influence-selected Examples의 잠재적 Behavioral Leverage를 성공적으로 활용할 수 있음을 입증합니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 기존 Weight-based Interventions에서 Influence-selected Examples가 보여주었던 미미한 효과가 이들 예제의 내재적 가치 부족 때문이 아니라, 개입 방식 자체의 한계 때문이었음을 명확히 밝혔습니다. Influence-guided Response Rewriting이라는 새로운 프레임워크를 통해, IF로 식별된 영향력 있는 학습 예제들이 강력하고 지속적인 Behavioral Shifts를 유도할 수 있는 상당한 Behavioral Leverage를 가지고 있음을 입증했습니다.
이러한 발견은 Training Data Attribution (TDA) 분야에 중대한 시사점을 제공합니다. 기존에는 영향력 점수(Influence Score)가 포착하는 Local Reweighting Effects에 초점을 맞추었지만, 본 연구는 Influence Estimates가 식별하는 예제들이 훨씬 더 광범위한 Intervention Leverage를 가진다는 점을 구분했습니다. 이는 TDA 방법론의 평가가 단순히 예제 선택의 정확성뿐만 아니라, 선택된 예제를 어떻게 개입할 것인가(Intervention-aware Evaluation)에 대한 고려를 포함해야 함을 시사합니다.
또한, 이 프레임워크는 Safety Refusal과 같은 다른 행동 영역에도 성공적으로 일반화될 수 있음을 보여주었으나, 더 강력한 Safety는 Over-Refusal Trade-off를 수반할 수 있음을 지적하며, 향후 더욱 세밀한 연구의 필요성을 제시했습니다. 궁극적으로 본 연구는 LLM의 Behavior를 보다 효과적이고 정밀하게 제어하기 위한 데이터 개입 전략 개발의 토대를 마련했습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Recognition-Refusal Misalignment in LLMs: Why Models Answer Structurally Unanswerable Questions
- [논문리뷰] Terminal-Universe: Turning Agent Trajectories into Scalable Terminal Environments
- [논문리뷰] Dockerless: Environment-Free Program Verifier for Coding Agents
- [논문리뷰] Compress-Distill: Reasoning Trace Compression for Efficient Knowledge Distillation
- [논문리뷰] STRIDE: Training Data Attribution via Sparse Recovery from Subset Perturbations
Review 의 다른글
- 이전글 [논문리뷰] Diffs vs. Whole Files: An Empirical Comparison of Iterative Edit-Based and Direct Generation for Flutter/Dart Code Models
- 현재글 : [논문리뷰] From Reweighting to Rewriting: Unlocking the Intervention Effects of Influential Samples in Training Data Attribution
- 다음글 [논문리뷰] OracleZoom: On-Policy Self-Distillation Inspired Reference-Constrained Recursive Image Super Resolution
댓글