[논문리뷰] World in World: Explore the World with World Models
링크: 논문 PDF로 바로 열기
메타데이터
저자: Chenxi Song, Yanming Yang, Chi Zhang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- World in World (WiW): 사전 학습된 비디오 모델을 재학습 없이 제어하기 위해, 다양한 시각적 근거(Evidence)를 인터페이스로 변환하여 모델의
self-attention을 통해 활용하는 프레임워크입니다. - CGAR (Correspondence-guided Attention Routing): 쿼리(Query) 토큰과 소스 비디오 토큰 간의 기하학적 대응 관계를 추적하여, 모델이 올바른 시각적 정보를 참조하도록 라우팅하는 기술입니다.
- EWA (Evidence-wise Attention CFG): 서로 다른 시각적 근거들이 생성 과정에 미치는 영향을 독립적으로 조절하여, 모델의 생성 능력을 저해하지 않으면서 제어력을 최적화하는 기법입니다.
- Clean K/V: 외부에서 입력된 제어 신호를 비디오 모델이 이해할 수 있도록 변환한 뒤, 모델의 내부 구조에 맞게 캐싱(Caching)한 키와 값의 쌍입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 사전 학습된(frozen) Causal Video World Models를 재학습 없이도 자유롭고 정교하게 제어할 수 있는 통합 인터페이스를 제공하고자 합니다 [Figure 1]. 기존 연구들은 카메라 제어, 소스 비디오 리렌더링, 혹은 긴 시점의 일관성을 유지하기 위해 특정 작업에 맞춘 모듈이나 별도의 학습 과정을 필요로 했습니다. 이러한 방식은 새로운 제어 유형을 지원할 때마다 모델 구조를 수정해야 하는 한계가 있습니다. 저자들은 모델의 파라미터를 수정하는 대신, 다양한 제어 입력을 모델의 native self-attention이 이미 이해하고 있는 '청정 시각 상태(clean visual states)'로 변환하는 시각적 인터페이스를 설계하는 것이 효율적이라고 판단하였습니다.
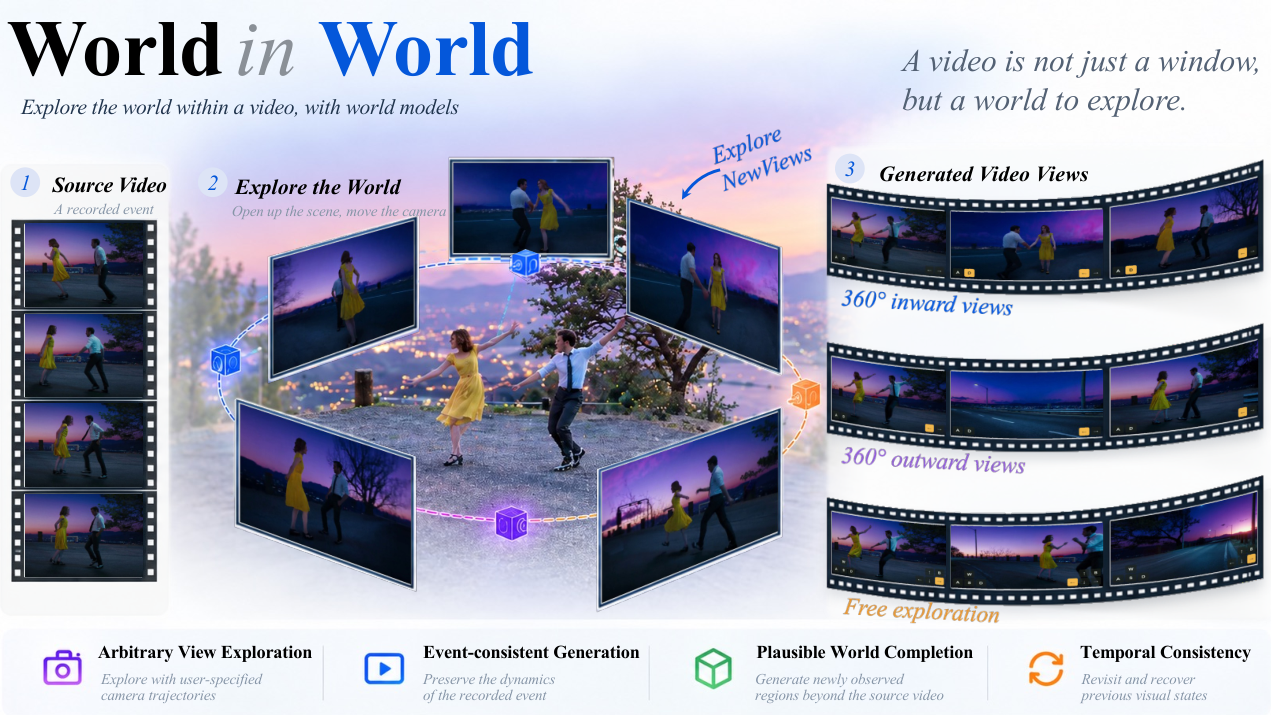
Figure 1 — WiW 제안 컨셉
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 소스 비디오 관측치, 타겟 시점 투영(Target-view projection), 렌더링된 기하학적 정보, 과거 생성 이력을 동일한 인터페이스인 WiW를 통해 처리합니다 [Figure 2]. 각 정보는 카메라 포즈와 시간 정보가 라벨링된 형태로 모델에 입력되며, CGAR를 통해 기하학적으로 일치하는 토큰을 효과적으로 참조합니다. 또한, EWA를 도입하여 여러 보조 채널(auxiliary channels)이 생성 과정에 기여하는 강도를 독립적으로 제어함으로써, 모델의 원본 생성 품질을 유지하면서 정밀한 제어를 가능하게 합니다.
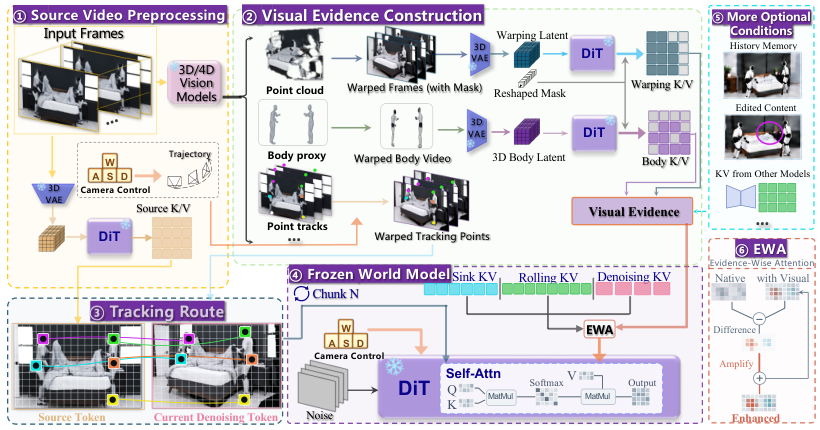
Figure 2 — 전체 파이프라인 구조
실험 결과, 제안 모델은 DAVIS 및 OpenVid-1M 데이터셋에서 기존의 ReCamMaster, WorldForge, InSpatio-World 등과 비교하여 우수한 성능을 입증했습니다 [Table 1]. 정량적 지표에서 VBench Overall 점수 85.192를 달성하여 비교 대상 중 가장 높은 수치를 기록하였으며, 카메라 경로 오류(TransError, RotError) 측면에서도 각각 0.068622와 2.8326으로 가장 낮은 오차를 보여주었습니다. 특히, 재학습 없이도 카메라 제어 리렌더링뿐만 아니라 비디오 안정화, K/V 공유, 인간 동작 전이(Human-motion transfer) 등 다양한 어플리케이션에서 견고한 성능을 보였습니다 [Figure 4].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 사전 학습된 비디오 세계 모델에 재학습 없이 제어력을 부여하는 통합 프레임워크인 WiW를 성공적으로 제시하였습니다. CGAR와 EWA를 통해 이질적인 시각적 근거를 성공적으로 결합함으로써, 모델은 가려진 영역의 완성, 긴 시점의 일관성 유지, 기하학적 정렬 등 복잡한 제어 요구사항을 효과적으로 해결합니다. 이 연구는 대규모 생성 모델의 파라미터를 건드리지 않고도 외부 시각 정보를 통해 모델을 제어할 수 있는 가능성을 확장하였으며, 향후 대화형 콘텐츠 생성이나 가상 환경 시뮬레이션 분야에 큰 기여를 할 것으로 기대됩니다.
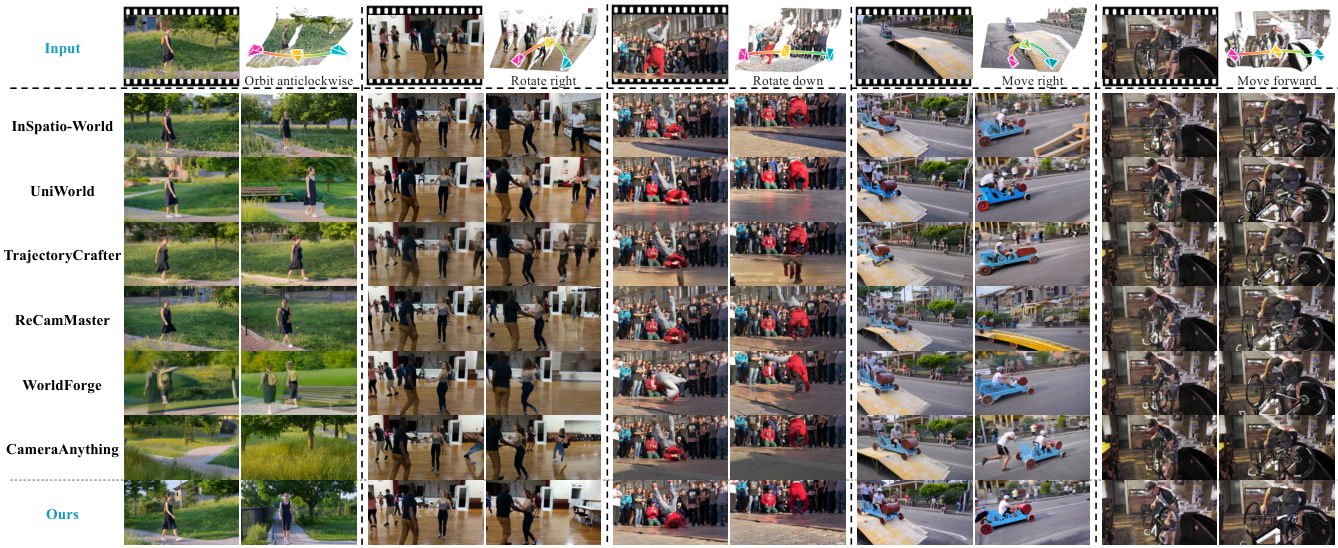
Figure 3 — 정성적 비교 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] FlashRender: Few-Step Generative Rendering via Camera-Controlled Video MeanFlow
- [논문리뷰] H3-World: Turning Language Understanding into World Control
- [논문리뷰] HarnessEval-W: Agentifying the Evaluation of Visual Worlds
- [논문리뷰] H2R-Bench: Benchmarking Human-to-Robot Manipulation Video Generation in World Models
- [논문리뷰] WorldExam: Benchmarking World Models from Apparent Appearance to Inherent Reactivity
Review 의 다른글
- 이전글 [논문리뷰] UniH^3: Unifying Hierarchical Homogeneity and Heterogeneity for All-in-One Medical Image Restoration
- 현재글 : [논문리뷰] World in World: Explore the World with World Models
- 다음글 [논문리뷰] X-AuT: Progressive Audio-Encoder Compression for Speech LLMs with Cross-Scale Distillation
댓글