[논문리뷰] DataFlex-RL: An Evaluation Platform for RLVR Data Policies
링크: 논문 PDF로 바로 열기
메타데이터
저자: Hao Liang, Mingrui Chen, Hengyi Feng, Meiyi Qiang, Wentao Zhang
1. Key Terms & Definitions (핵심 용어 및 정의)
- RLVR (Reinforcement Learning with Verifiable Rewards): 수학, 논리, 코딩 등 정답 확인이 가능한 환경에서, 검증 가능한 보상 신호를 사용하여 LLM을 강화학습시키는 프레임워크입니다.
- GRPO (Group Relative Policy Optimization): 데이터의 효율성을 높이기 위해 하나의 프롬프트에 대해 여러 출력을 생성하고, 그룹 내에서 상대적인 이득(advantage)을 계산하여 정책을 업데이트하는 알고리즘입니다.
- Data Policy (Data-Centric Training): RLVR 학습 과정에서 어떤 프롬프트를 선택하고, 응답의 손실 가중치를 어떻게 조절하며, 어떤 데이터 도메인을 우선순위에 둘지 결정하는 일련의 전략을 의미합니다.
- DataFlex-RL: RLVR 정책 간의 공정한 비교를 위해 고정된 훈련 파이프라인, 교차 도메인 평가 지표, 재현 가능한 실험 설계를 제공하는 통합 평가 플랫폼입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 다양한 RLVR 데이터 정책들이 실제로는 일관된 성능 향상을 보장하지 않으며, 기존 연구의 성과들이 과도하게 특정 실험 환경이나 훈련 설정에 의존하고 있다는 문제를 제기합니다. 현재의 데이터 처리 기법(선택, 재가중치 부여, 도메인 혼합 등)은 각기 다른 훈련 루프와 평가 프로토콜 하에서 평가되기에 직접적인 비교가 어렵습니다. 저자들은 동일한 GRPO 레시피를 유지한 상태에서 13가지 데이터 정책을 12개의 matched seed 환경에서 엄격하게 비교하고자 합니다. 이를 통해 데이터 정책이 훈련 과정을 변화시키는 것은 사실이나, 그것이 무작위적 변동 이상의 재현 가능한 성능 개선을 가져오는지 검증합니다 [Figure 1].
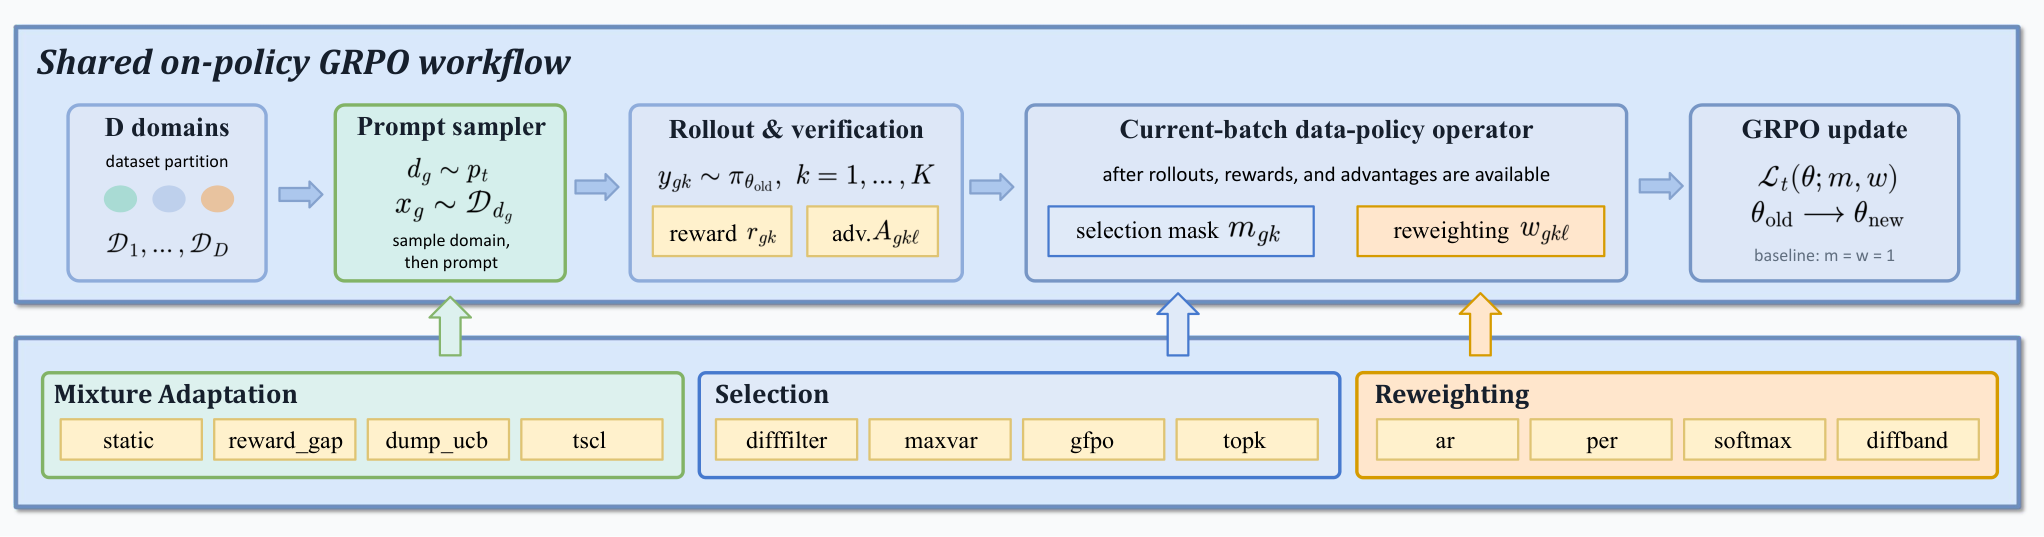
Figure 1 — GRPO 워크플로우와 데이터 정책 개입 지점
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 DataFlex-RL 플랫폼을 통해 데이터 정책을 세 가지 intervention point(선택, 재가중치 부여, 혼합 최적화)로 추상화하고, 동일한 모델 및 훈련 스택 하에서 대규모 비교를 수행합니다. Qwen2.5-7B-base 모델을 대상으로 12개의 matched seed를 사용하여 실험한 결과, uniform GRPO 자체는 미학습 체크포인트 대비 7.76점의 Overall 정확도 향상을 보였습니다. 그러나 데이터 정책을 적용한 8가지 선택 및 재가중치 기법 중 통계적으로 유의미한 성능 향상을 보인 사례는 전무했습니다. 특히, 3가지 adaptive mixture 정책 또한 고정된 혼합(fixed mixture) 대비 일관된 우위를 점하지 못했습니다. 평가 도메인 구성에 따른 민감도 분석 결과, 특정 도메인(예: logic)을 제외하면 순위가 역전되는 현상($\rho=-0.33$)을 확인하여 평가 지표의 선택이 결과에 미치는 영향이 매우 큼을 정량적으로 증명했습니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 통제된 실험 환경에서 데이터 정책들이 무작위적 변동 이상의 reproducible gain을 제공하지 못함을 보여주며, RLVR 연구의 재현성 확보를 위한 평가 플랫폼의 중요성을 강조합니다. 이 결과는 데이터 중심의 학습 기법이 단순히 훈련 과정을 다르게 만드는 것일 뿐, 반드시 모델의 최종 성능을 개선하는 것은 아닐 수 있다는 점을 시사합니다. 향후 학계는 단일 모델이나 특정 벤치마크에 국한된 성과 발표에서 벗어나, 본 논문이 제시한 DataFlex-RL과 같은 표준화된 비교 체계를 통해 기술의 실질적인 기여도를 엄격히 검증해야 할 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Group Adaptive Clipping Policy Optimization
- [논문리뷰] Parameter Exploration for RLVR via Variational Learning
- [논문리뷰] Not All Tokens Deserve Equal Credit: Counterfactual Sensitivity Credit Reallocation for Long-CoT Reasoning
- [논문리뷰] Look Before You Leap: Autonomous Exploration for LLM Agents
- [논문리뷰] Unifying Group-Relative and Self-Distillation Policy Optimization via Sample Routing
Review 의 다른글
- 이전글 [논문리뷰] COBRA-Skills: Contextual Bandit-Guided Evolution for Agent Skill Optimization
- 현재글 : [논문리뷰] DataFlex-RL: An Evaluation Platform for RLVR Data Policies
- 다음글 [논문리뷰] Feyospace-v1: How the Cyber Mercury Seven Trained Frontier Cyber Models
댓글