[논문리뷰] StepAudio 3 Gen Technical Report
링크: 논문 PDF로 바로 열기
저자: Bin Lin, Bo Zhao, Boyang Wang, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Residual Vector Quantization (RVQ): 오디오를 16개의 코드북 ID로 양자화하여 각 프레임을 표현하는 방식이며, 각 코드 레이어가 의미론적(semantic) 및 파형 수준의 음향적(waveform-level acoustic) 정보를 모두 보존하도록 설계된 기술입니다.
- StepAudio Tokenizer: 음성, 음악 및 일반 오디오를 단일 공유 multi-codebook 공간으로 이산화하고 24kHz 파형을 재구성하는 12.5 Hz 오디오 토크나이저입니다.
- RVQ Adaptor: multi-codebook 오디오 임베딩을 사전 학습된 LLM의 토큰 임베딩 공간과 조정하기 위해 제안된 token-wise, zero-initialized residual adaptor입니다.
- Interference-aware Progressive Pretraining: LLM의 기존 텍스트 능력을 보존하면서 오디오 능력을 점진적으로 도입하기 위한 4단계 사전 학습 레시피입니다.
- Discrete Autoregressive Modeling: 확산(diffusion) 또는 flow-matching 기반의 연속적인 생성 패러다임 대신, RVQ 토큰을 직접 모델링하여 오디오를 생성하는 방식입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 오디오 생성 연구는 Text-to-Speech (TTS), Text-to-Audio, Text-to-Music 등 개별 도메인에 특화되어 발전해 왔으며, 이는 다양한 종류의 오디오를 필요로 하는 애플리케이션에서 호환되지 않는 표현, 컨디셔닝 형식, 및 생성 파이프라인 문제를 야기했습니다. 최근 연구들은 통합 오디오 생성으로 전환하고 있으나, 연속적인 latent space 모델과 discrete unit 모델 간의 trade-off가 존재합니다. 특히, LLM 기반 모델에 오디오 토큰을 추가할 때 발생하는 새로운 RVQ 임베딩이 기존 텍스트 임베딩의 통계와 일치하지 않거나, 잔여 코드북(residual codebook) objective가 많은 음향 예측을 제공하여 기존 LLM의 언어 지능을 저해하고 오디오 기능과 상충되는 "간섭(interference)" 위험이 있었습니다. 저자들은 이러한 한계를 극복하고 범용 오디오 생성을 위한 단일화된 프레임워크를 구축하는 것을 목표로 합니다.
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 StepAudio 3 Gen을 제안하며, 이는 StepAudio Tokenizer, LLM Backbone, 그리고 RVQ Adaptor로 구성된 discrete autoregressive generator입니다 [Figure 1]. StepAudio Tokenizer는 오디오를 12.5 Hz의 shared 16×2048 RVQ 코드 공간으로 이산화하며, 각 코드 레이어가 semantic 및 waveform-level acoustic feature를 모두 보존하도록 jointly quantize합니다. LLM Backbone은 가장 coarse한 0번째 RVQ 코드북을 메인 언어 모델 어휘에 포함시켜 텍스트와 오디오를 단일 autoregressive stream으로 모델링하며, 나머지 15개 residual codebook은 LLM hidden state와 0번째 codebook에 conditioning되는 lightweight causal Transformer인 RVQ Code Predictor에 의해 생성됩니다 [Figure 1].
제안된 접근 방식은 특히 두 가지 핵심 요소에서 기존 모델 대비 우수성을 보였습니다. 첫째, RVQ Adaptor는 multi-codebook 오디오 임베딩을 사전 학습된 LLM의 토큰 임베딩 공간에 효과적으로 정렬합니다. 실험 결과, RVQ Adaptor를 적용한 시스템은 AISHELL-1 ASR에서 3.00% CER (w/o RVQ Adaptor: 5.25%), LibriSpeech ASR에서 3.41% WER (w/o RVQ Adaptor: 6.00%), MMAU Audio Understanding에서 51.70% Acc. (w/o RVQ Adaptor: 40.70%), CoVoST English-Chinese ST에서 30.56% BLEU (w/o RVQ Adaptor: 12.05%)를 달성하며 모든 오디오-언어 벤치마크에서 크게 향상된 성능을 보였습니다 [Table 2]. 둘째, Interference-aware Progressive Pretraining 전략은 LLM의 기존 텍스트 도메인 능력을 효과적으로 보존합니다. 이는 4단계 사전 학습 레시피를 통해 오디오 정렬, 이해, 생성 능력을 점진적으로 도입하며, frozen-backbone alignment, 50% text replay, 그리고 residual code predictor에서의 temporary gradient detachment를 포함합니다. 이 전략을 통해 StepAudio 3 Gen은 FinEval에서 71.68% Acc. (Baseline: 65.86%), C-Eval에서 71.92% Acc. (Baseline: 66.34%), MMLU에서 69.20% Acc. (Baseline: 64.99%) 등 주요 텍스트 벤치마크에서 Baseline 대비 일관적으로 우수한 성능을 나타냈습니다 [Table 3]. 또한, TTS Human-likeness 평가에서 1755.33의 Elo Rating을 기록하며 5개의 상업용 TTS 시스템을 능가했으며 [Figure 2(a)], Voice Design task에서도 InstructTTSEval 벤치마크에서 중국어 평균 85.2%, 영어 평균 77.7%의 style-consistency score를 달성하며 SOTA를 기록했습니다 [Table 4].
## 4. Conclusion & Impact (결론 및 시사점)
StepAudio 3 Gen은 discrete autoregressive framework 내에서 범용 오디오 생성을 위한 통합된 접근 방식을 제시합니다. 이 연구는 shared semantic–acoustic representation이 단일 LLM 기반 아키텍처 내에서 다양한 오디오 생성 작업을 지원할 수 있음을 입증했습니다. 특히, 오디오 기능은 사전 학습된 LLM과의 간섭을 완화하기 위해 점진적으로 도입되어야 하며, multi-codebook acoustic representation은 경량의 RVQ Adaptor를 통해 효과적으로 통합될 수 있고, discrete autoregressive modeling은 연속적인 acoustic renderer 없이도 음성을 넘어 일반 오디오로 확장될 수 있다는 세 가지 실용적인 교훈을 제공합니다. StepAudio 3 Gen은 TTS 및 Voice Design에서 SOTA 결과를 달성했으며, vocal, 음악, 사운드, vibe speech에서도 강력한 생성 능력을 보여, discrete autoregressive modeling이 통합 오디오 모델 구축을 위한 실용적이고 확장 가능한 대안임을 시사합니다.
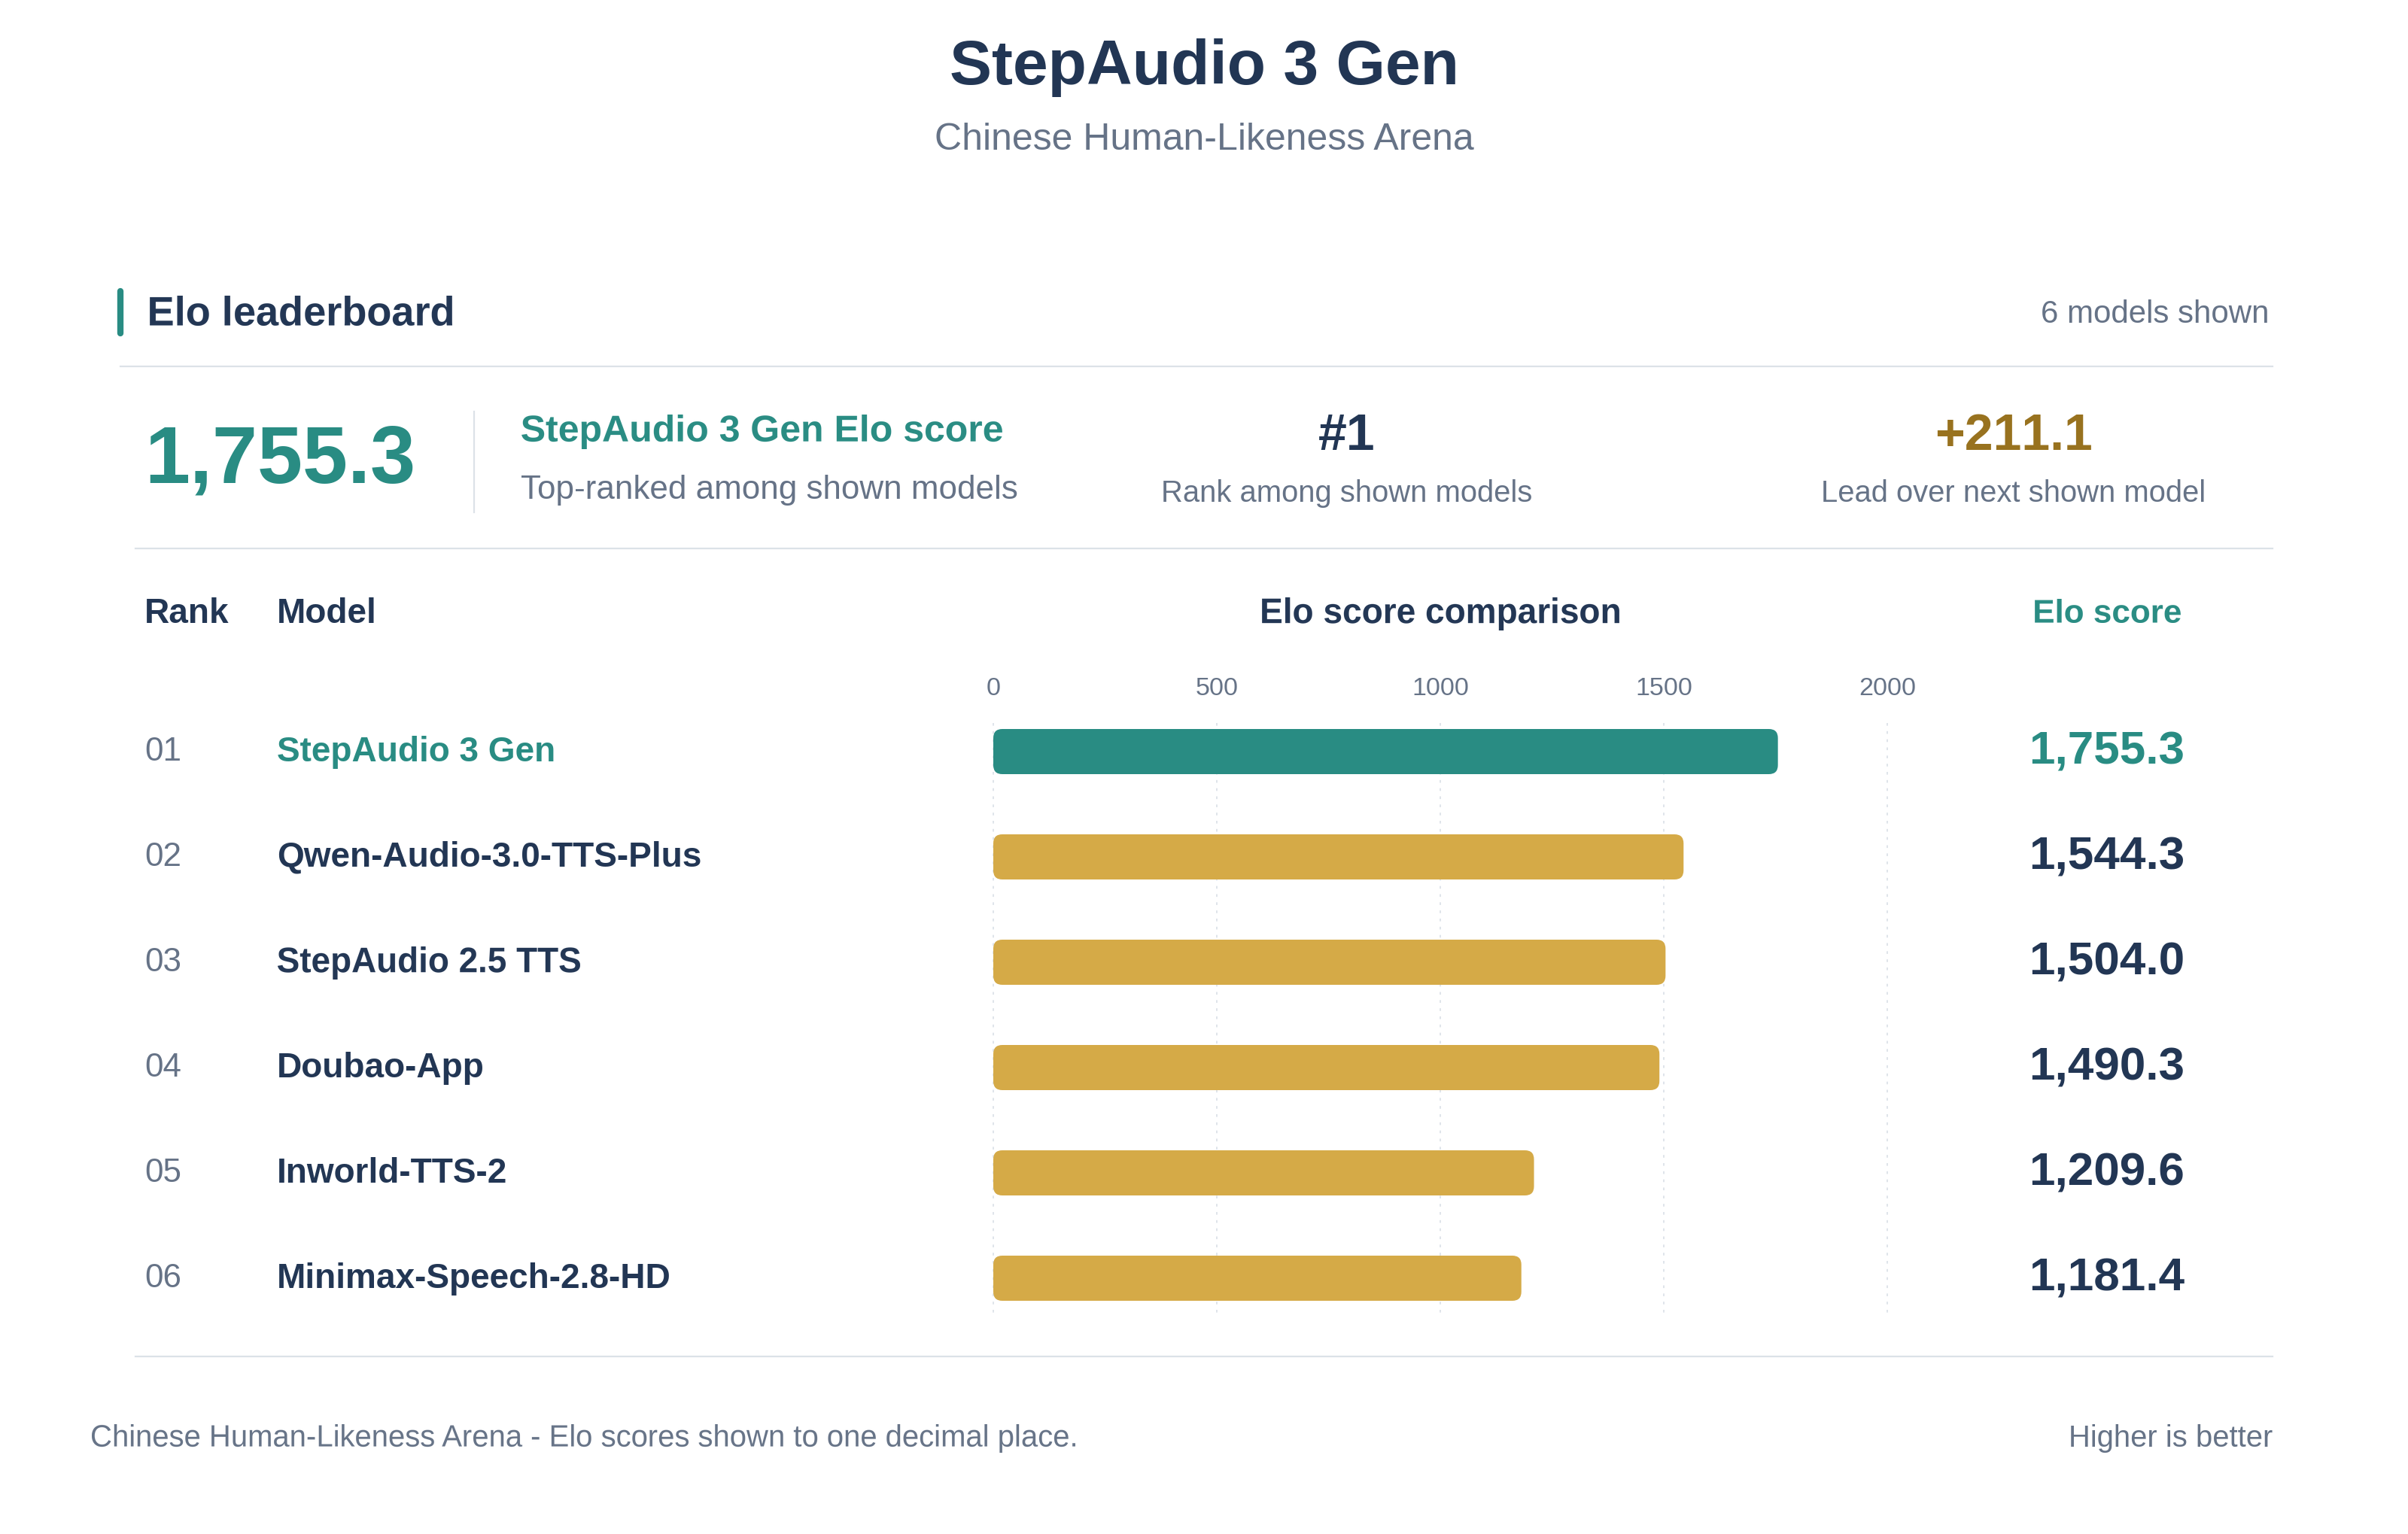
Figure 2 — TTS 인간 유사성 평가 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] SNAP3D: Physically Grounded 3D Parts for Assembly from a Single Image
- 현재글 : [논문리뷰] StepAudio 3 Gen Technical Report
- 다음글 [논문리뷰] Studying Without a Syllabus: Task-Agnostic Environment Preprocessing
댓글