[논문리뷰] ZooWork-ShopRanker: An Open, Preference-Aligned E-Commerce Reranker
링크: 논문 PDF로 바로 열기
저자: Siqiao Xue, Shuxuan Liu, Ning Hu, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- ZOOWORK-SHOPRANKER: 이커머스 검색 최적화를 위해 쇼핑 선호도(shopping preference)에 맞춰 학습된 reranker 모델 패밀리(0.6B, 4B, 8B).
- SHOPRANK-BENCH: 이커머스 검색 트래픽에서 추출된 ~10,000개의 고품질 선호도 쌍(preference pairs)으로 구성된 contamination-limited 벤치마크.
- Cross-family LLM Judges: 다양한 LLM 패밀리를 preference oracle로 사용하여 학습 데이터에 라벨을 부여하고 position bias를 줄이는 평가 프로토콜.
- Distillation: 8B 모델의 지식을 0.6B 및 4B 학생 모델로 전이하여 효율성과 성능을 동시에 확보하는 학습 기법.
- Parallel Constrained Decoding: 텍스트 생성을 최소화하고 고정된 answer vocabulary의 logit 차이를 통해 스코어를 계산하는 효율적인 추론 방식.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 기존의 범용(general) 웹 리트리버 및 리랭커 모델이 이커머스 환경의 특수성을 고려하지 못해 발생하는 성능 저하 문제를 해결하고자 한다. 단순한 topical relevance를 넘어 소비자 개인의 제약 사항(constraints), 예산, 선호도를 판단하는 능력이 부족한 점이 주요 한계이다. 특히, 기존 모델들은 명시적 제약 조건(hard constraints)이 있는 검색 쿼리에서 topical similarity에만 의존하여 부적합한 상품을 선택하는 경향이 있다. 이러한 문제를 극복하기 위해 저자들은 실제 이커머스 검색 트래픽과 LLM 기반의 정교한 선호도 데이터를 활용한 정렬(alignment) 기법의 필요성을 제기한다 [Figure 1].
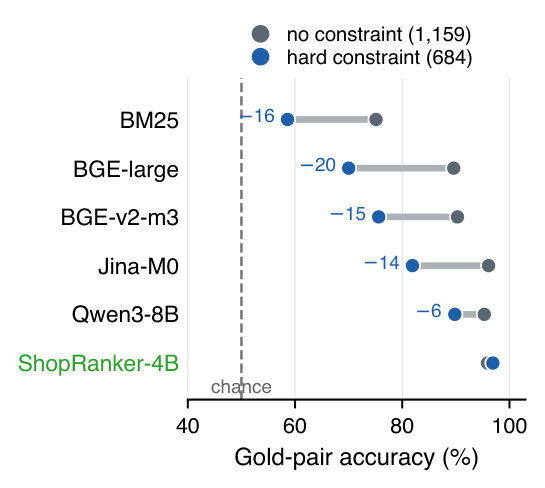
Figure 1 — 제약 조건 유무에 따른 모델별 성능 저하를 보여주는 핵심 결과
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 다양한 Reasoning LLM 패밀리를 활용해 선호도 데이터를 구축하고, 이를 기반으로 LoRA(Low-rank adaptation) 학습 및 distillation을 수행하는 프레임워크를 제안한다. 8B 모델을 distillation teacher로 활용하여 0.6B와 4B 학생 모델을 학습시켰으며, 학습된 모델들은 SHOPRANK-BENCH에서 기존의 모든 오픈 리랭커 베이스라인을 압도하는 성능을 입증했다. 주요 정량적 결과로, ZOOWORK-SHOPRANKER-8B는 가장 우수한 오픈 리랭커 대비 통계적으로 유의미한 성능 향상을 보였으며, distilled 0.6B 모델은 7배 더 큰 모델과 유사한 수준의 성능을 보이면서 2.8배 높은 throughput을 달성했다. 또한, explicit budget constraint를 가진 쿼리에서 기존 모델들이 50% 수준의 chance 성능에 머무르는 반면, 제안 모델은 90% 이상의 높은 Pairwise accuracy를 기록하며 제약 조건 준수 능력을 확인했다 [Table 6].
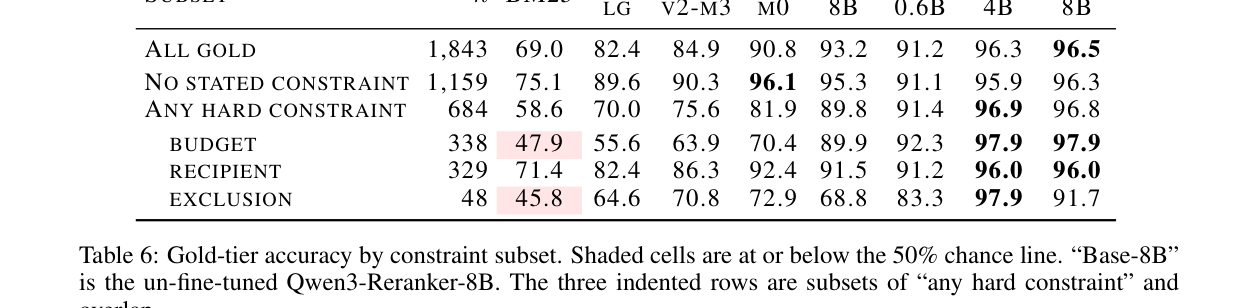
Table 6 — 제약 조건별 모델의 성능 우위를 정량적으로 보여주는 핵심 지표
## 4. Conclusion & Impact (결론 및 시사점) 본 연구는 범용 리랭커 모델을 이커머스 도메인 선호도에 맞춰 성공적으로 정렬(align)할 수 있음을 입증하며, 효율적인 distillation 경로를 통해 실무 환경에서의 서빙 가능성을 높였다. 개발된 모델 패밀리와 벤치마크 데이터셋은 이커머스 도메인 내의 정교한 검색 품질 개선을 위한 귀중한 오픈 리소스를 제공한다. 이번 성과는 LLM 기반의 정교한 평가와 데이터셋 구축이 도메인 특화 모델의 한계를 극복하는 핵심 동력임을 시사한다. 특히 벤치마크 셋을 통한 체계적인 검증과 리랭킹 품질의 실증적 향상은 향후 이커머스 검색 엔진 인프라 설계에 중요한 가이드라인이 될 것이다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Video DeltaNet: A Video-Native Hybrid Attention for Livestream Video Generation
- [논문리뷰] A Zeroth-Order Paradigm for LLM Preference Alignment
- [논문리뷰] PLC-DPO: Posterior Label Correction in Noisy and Ambiguous Preference Optimization
- [논문리뷰] DriveZero: End-to-End Driving Beyond Human Demonstrations
- [논문리뷰] TLive-Omni: An Omni-Modal Understanding Model for E-Commerce Live Streaming
Review 의 다른글
- 이전글 [논문리뷰] VLA-Precision: Asymmetric Co-Bootstrapping for Efficient Real-World Online RL of Vision-Language-Action Models
- 현재글 : [논문리뷰] ZooWork-ShopRanker: An Open, Preference-Aligned E-Commerce Reranker
- 다음글 없음
댓글