[논문리뷰] DriveZero: End-to-End Driving Beyond Human Demonstrations
링크: 논문 PDF로 바로 열기
저자: Hao He, Chengcheng Hu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- DriveZero: 인간 주행 데이터의 제약을 넘어선 주행 행동을 학습하는 End-to-End 자율주행 시스템으로, Perception 모델과 Action 모델을 분리하여 개별적으로 사전 학습한 후 Distillation을 통해 통합한다.
- DriveRL: 실제 주행 로그로부터 구축된 Mixed-Agent Interactive World에서 Privileged Teacher Policy를 Closed-Loop Reinforcement Learning 방식으로 처음부터 학습시키는 프레임워크이다.
- DriveVFM: Task-Specific Annotation 없이 Raw Image만을 사용하여 DINOv3, SigLIP2, SAM, Depth Anything V2 등 여러 Frozen Vision Foundation Models의 지식을 단일 Driving Backbone으로 통합하는 Perception 모델이다.
- Value-Guided Test-Time Action Search (TTS): DriveRL의 추론 시 사용되는 기술로, Policy의 Local Action Diversity와 Critic의 Delayed Return 추정치를 활용하여 샘플링된 Action들을 재랭킹함으로써 Action Selection 품질을 향상시킨다.
- Goal Augmentation: DriveZero의 Distillation 과정에서 사용되는 기법으로, Goal-Conditioned DriveRL Teacher에게 다양한 Driving Intent를 질의하여, Logging된 데이터가 제공할 수 없는 다양하고 Goal-Consistent한 Supervision을 생성한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
대부분의 End-to-End 자율주행 시스템은 인간의 주행 로그를 모방하여 학습하며, 이는 학습된 행동이 기록된 궤적의 품질과 커버리지에 의해 제한되는 문제점을 안고 있다. 이 패러다임은 Logged Scene마다 단일한 실현된 미래만 포함하며, 안전에 critical한 이탈 및 복구 기동이 드물고, 학습된 Policy에 의해 유도된 상태는 오프라인 데이터에 부재하여 정책이 Demonstration Distribution을 벗어날 때 오류가 누적될 수 있다. 직접적인 Visual Reinforcement Learning (RL)은 Sample-Intensive한 Exploration과 비용이 많이 드는 Visual Simulation으로 인해 Scalability의 어려움을 겪는다. 기존 연구들은 Closed-Loop Training은 수행하지만 Visual Encoder를 Off-the-shelf로 사용하기 때문에, 방대한 시각 데이터의 이점을 충분히 활용하지 못하는 한계가 있었다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 인간 Demonstration의 제약을 뛰어넘는 End-to-End 자율주행 시스템인 DriveZero를 제안하며, 이는 Perception 모델과 Action 모델을 각각의 최적 Regime에서 Pretraining하고 Distillation을 통해 Camera-Only Planner로 통합하는 방식을 채택한다. [Figure 1]
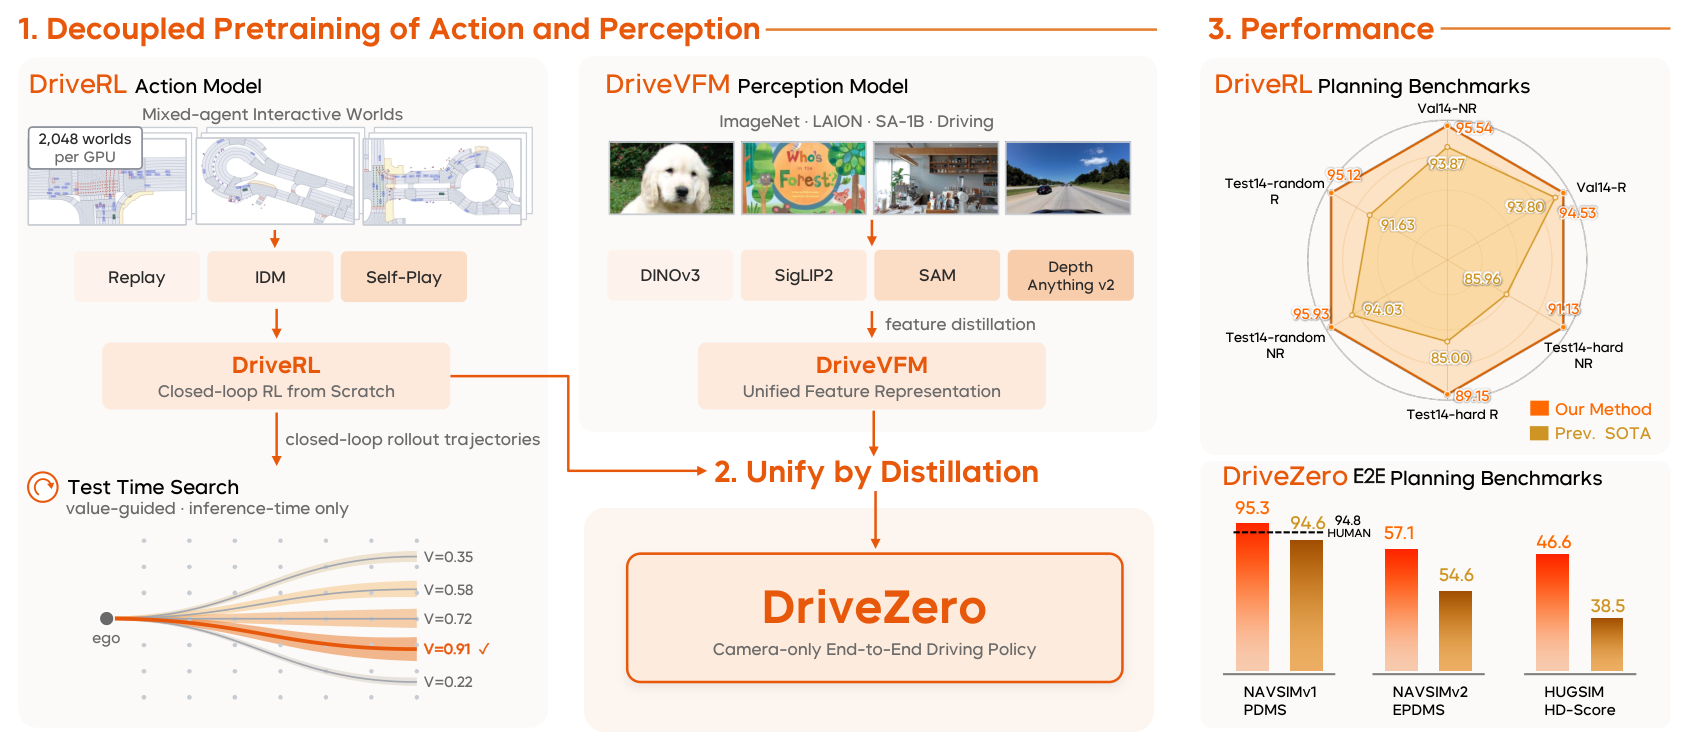
Figure 1 — End-to-End 주행 시스템 개요
Action 모델인 DriveRL은 실제 nuPlan 로그를 기반으로 한 Mixed-Agent Interactive World에서 Closed-Loop RL을 통해 Privileged Teacher Policy를 Scratch부터 학습시킨다. 이는 인간 Demonstration 없이 Explicit Objective를 최적화하여 주행 행동을 학습하며, nuPlan Val14, Test14-hard, Test14-random 세 가지 Community Split에서 93.01의 평균 CLS (Closed-Loop Score)를 달성하여 Log-Replay Expert를 모든 설정에서 능가한다. 또한, Value-Guided Test-Time Action Search (TTS)를 적용했을 때 평균 CLS는 93.57로 추가 개선되었다. [Table 2]
Perception 모델인 DriveVFM은 DINOv3, SigLIP2, SAM, Depth Anything V2와 같은 Frozen Vision Foundation Models의 Feature를 Raw Image로부터 단일 Driving Backbone으로 통합한다. 이는 Task-Specific Annotation 없이도 Driving에 관련된 Semantic, Geometry, Spatial Structure를 대규모로 학습할 수 있게 한다. Ablation Study 결과, DriveVFM ViT-S Backbone은 NAVSIMv1 navtest에서 94.41 PDMS를 달성하여 DINOv3 ViT-S Baseline (93.88 PDMS)보다 0.53 포인트 우수한 성능을 보였다. [Figure 3]
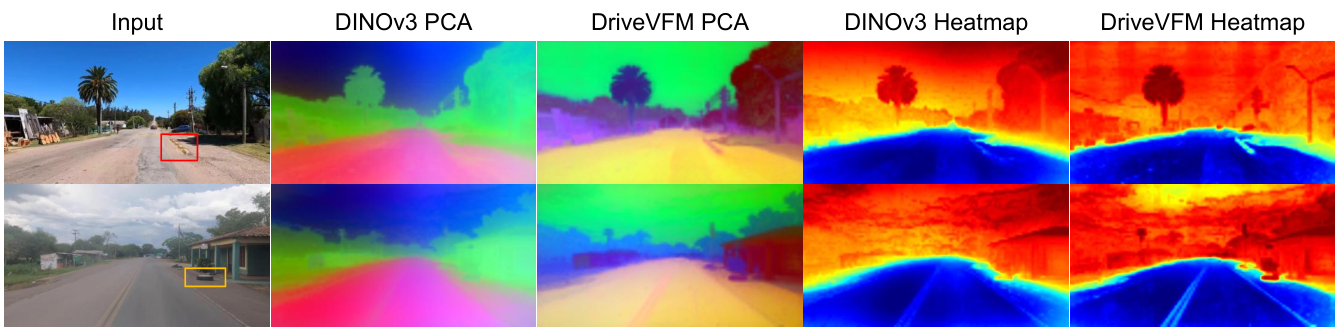
Figure 3 — Feature Representation 시각화
최종적으로 DriveZero는 Pretrained된 DriveVFM Backbone과 Command-Conditioned Transformer Planner를 활용하며, Frozen DriveRL Teacher의 Rollout Trajectory를 Winner-Takes-All Distillation 방식으로 학습한다. 특히 Goal Augmentation 기법을 통해 Teacher Policy가 다양한 Driving Intent에 대해 Goal-Consistent한 Trajectory를 생성하여 Training Data의 다양성을 크게 확장한다. [Figure 2] 이러한 접근 방식을 통해 DriveZero는 NAVSIMv1 navtest에서 인간 운전자와 동일한 94.8 PDMS를 달성하며 모든 기존 Camera-Only 및 Camera-LiDAR Fusion 방식의 SOTA 모델을 능가한다. SimScale 데이터를 추가하여 Training Set을 확장한 DriveZero-Scale은 NAVSIMv1 navtest에서 95.3 PDMS, NAVSIMv2 navhard에서 57.1 EPDMS, HUGSIM에서 Zero-Shot으로 46.6 HD-Score를 기록하며 해당 벤치마크들에서 SOTA 성능을 수립했다.
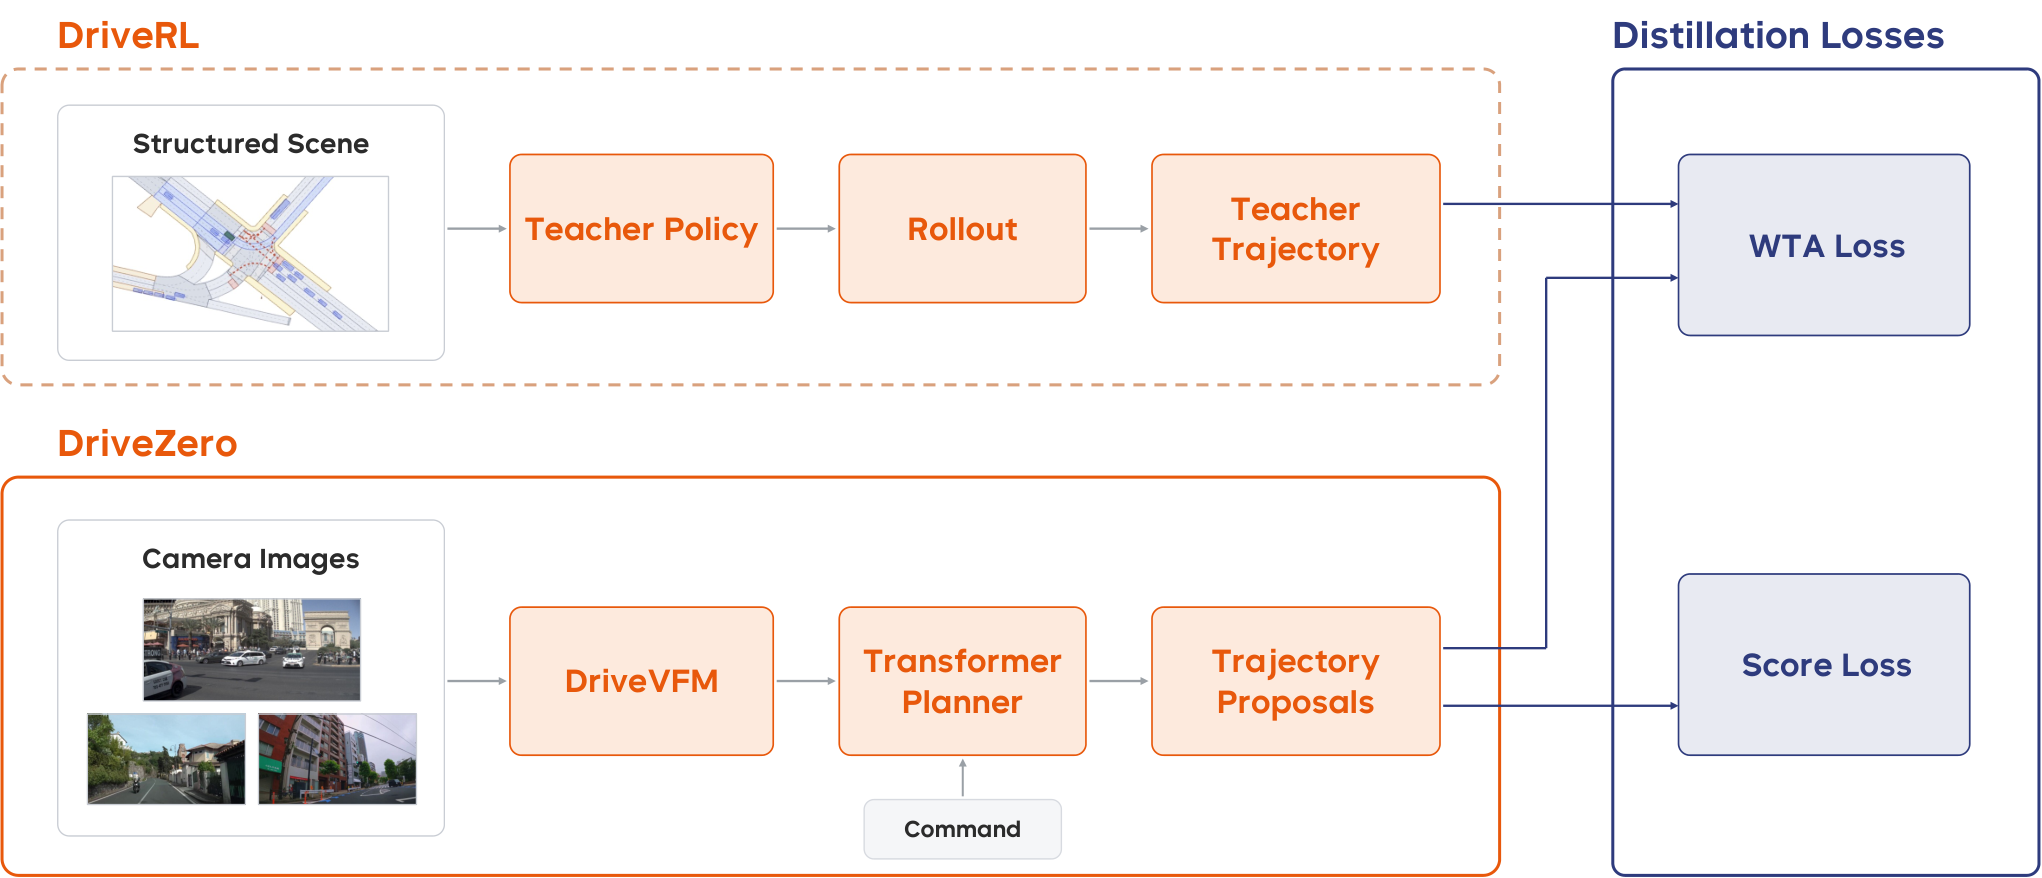
Figure 2 — Student Policy Distillation 프레임워크
4. Conclusion & Impact (결론 및 시사점)
본 논문은 인간 Demonstration의 한계를 넘어서는 End-to-End 자율주행 시스템인 DriveZero를 성공적으로 제시한다. 이 연구는 Perception과 Action 모델을 개별적으로 최적화하고, 이를 Distillation을 통해 통합하는 접근 방식이 Human Demonstration의 한계를 뛰어넘는 Scalable한 자율주행 시스템 개발에 효과적임을 입증한다. DriveRL은 Closed-Loop RL을 통해 기존 Log-Replay 전문가를 능가하는 주행 행동을 학습했으며, DriveVFM은 Task-Specific Annotation 없이도 강력한 Visual Representation을 제공한다. 최종적으로 DriveZero는 Camera-Only Planner로서 주요 자율주행 벤치마크에서 기존 SOTA 모델 및 인간 운전자의 성능을 능가하며, 실제 환경 적용 가능성도 시사한다. 이 방법론은 자율주행 분야에서 데이터 의존성을 줄이고, 안전성과 효율성을 높이는 새로운 패러다임을 제시한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] EXIMO: VLM Guided Exploration of VLA Policies
- [논문리뷰] SimWAM: A Simple World Action Model for End-to-End Autonomous Driving
- [논문리뷰] TREK: Distill to Explore, Reinforce to Refine
- [논문리뷰] Self-Evaluation Is Already There: Eliciting Latent Judge Calibration in Base LLMs with Minimal Data
- [논문리뷰] Nudging Beyond the Comfort Zone: Efficient Strategy-Guided Exploration for RLVR
Review 의 다른글
- 이전글 [논문리뷰] Counter-Swarm Doctrine: Containing Coordinated Agent Intrusions
- 현재글 : [논문리뷰] DriveZero: End-to-End Driving Beyond Human Demonstrations
- 다음글 [논문리뷰] Eliciting Weak-to-Strong Generalization with On-Policy Reverse Distillation
댓글