[논문리뷰] Eliciting Weak-to-Strong Generalization with On-Policy Reverse Distillation
링크: 논문 PDF로 바로 열기
본 논문은 강력한 Foundation Model의 post-training 과정에서 발생하는 비용 문제를 해결하기 위해, 약한 모델의 post-training 이득을 더 큰 학생 모델로 효과적으로 전이하는 On-Policy Reverse Distillation (OPRD) 프레임워크를 제안한다.
1. Key Terms & Definitions (핵심 용어 및 정의)
- RLVR (Reinforcement Learning with Verifiable Rewards): 프로그램 가능한 검증기(Verifier)를 통해 계산된 보상을 기반으로 모델의 정책(Policy)을 최적화하는 학습 기법이다.
- OPD (On-Policy Distillation): 학생 모델이 생성한 응답에 대해 교사 모델(Teacher)을 쿼리하여 토큰 수준의 분포를 매칭함으로써, 학습과 추론 시의 분포 불일치를 해소하는 방식이다.
- Weak-to-Strong Generalization: 더 약한 지도 모델(Supervisor)로부터 학습한 강력한 학생 모델이 지도 모델의 성능을 상회하는 능력을 획득하는 현상을 지칭한다.
- OPRD (On-Policy Reverse Distillation): 교사 모델의 정책 변화(Policy Shift)를 추출하여 학생 모델의 Verifier-driven Policy Gradient를 재조정(Rescaling)하는 기법이다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존의 Distillation 방식은 약한 교사 모델의 정책을 직접적인 최적화 목표(Optimization Target)로 설정함으로써, 학생 모델이 교사의 능력적 한계에 갇히게 되는 문제를 야기한다. 특히 대규모 모델의 post-training을 매번 처음부터 수행하는 것은 컴퓨팅 자원 측면에서 매우 비효율적이다. 기존 연구들인 RLVR이나 OPD는 교사 모델을 모방하거나 보상 최대화 사이에서 절충안을 찾으려 하지만, 여전히 교사 정책을 직접 따르도록 설계되어 성능 향상에 제약이 따른다 [Figure 1]. 이러한 한계를 극복하기 위해 교사 모델의 정책 변화만을 활용하여 학생 모델의 학습을 가속화할 수 있는 새로운 전이 방식이 필요하다.
Figure 1 — OPRD의 개념 및 성능 요약
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들이 제안하는 OPRD는 교사의 학습된 정책 변화($\Delta_t$)를 교사의 레퍼런스 정책으로부터 추출하여, 학생 모델의 Policy Gradient 중 해당 방향으로의 성분만을 증폭시키는 방식으로 동작한다 [Figure 2]. 학생 모델의 Gradient($g_t$)를 교사 방향($d_t$)으로 투영하고, 이를 $1+\lambda_t$만큼 증폭하여 학습 효율성을 극대화한다. 이때 수직(Orthogonal) 성분은 변화시키지 않아 Stationary Points를 보존하며, 교사 모델이 학습한 이득만을 효율적으로 전이한다 [Figure 2]. 실험 결과, OPRD는 Successive Model Transfer 설정에서 기존 GRPO 대비 33-67% 적은 업데이트로 교사 모델 성능에 도달하며, 초기 단계에서 최대 22.7%p 높은 성능을 기록하였다 [Table 1]. 또한, Multi-Teacher 설정에서도 네 명의 전문가 모델을 통합하여 모든 전문가를 능가하는 단일 학생 모델을 성공적으로 학습시켰다.
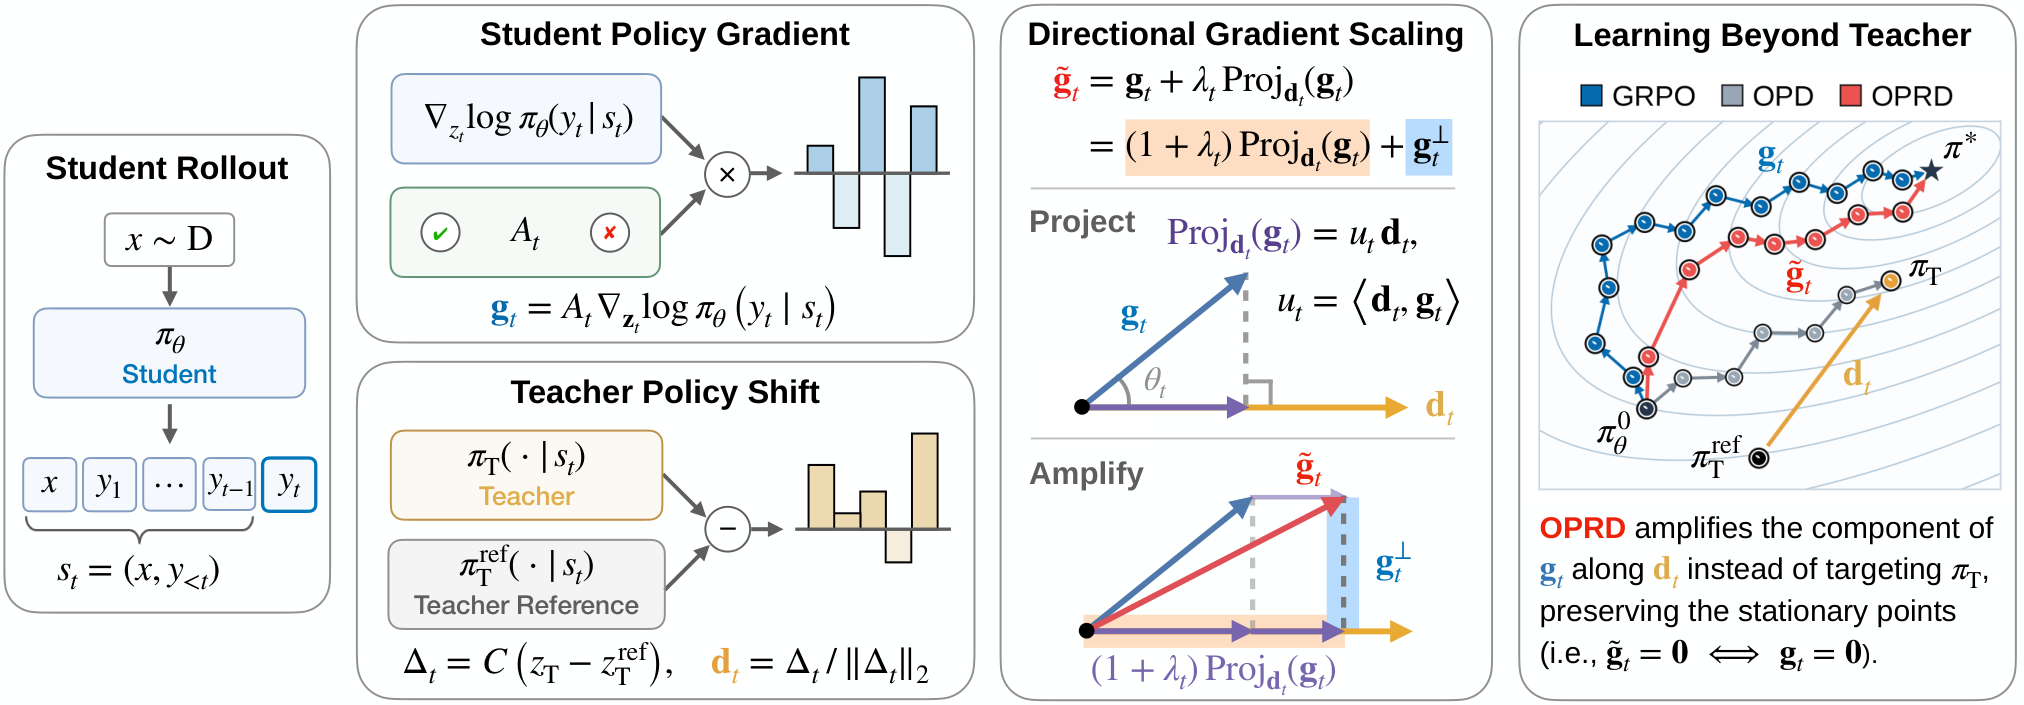
Figure 2 — OPRD의 Gradient 보정 절차
4. Conclusion & Impact (결론 및 시사점)
본 연구는 약한 교사 모델의 정책 이득을 활용하면서도 학생 모델의 최종 성능을 제한하지 않는 OPRD를 통해 Weak-to-Strong Generalization의 새로운 표준을 제시한다. 이 방식은 교사 모델의 성능을 모방하는 것을 넘어, 학생 모델이 스스로의 잠재력을 발휘하여 교사를 능가하는 reasoning path를 찾도록 돕는다. 이러한 접근법은 향후 대규모 모델의 post-training 과정에서 반복적인 비용 소모를 줄이고, 도메인 특화 모델들을 효과적으로 통합하는 시스템 설계에 중요한 학술적/실무적 지침을 제공할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] X-AuT: Progressive Audio-Encoder Compression for Speech LLMs with Cross-Scale Distillation
- [논문리뷰] World in World: Explore the World with World Models
- [논문리뷰] UniH^3: Unifying Hierarchical Homogeneity and Heterogeneity for All-in-One Medical Image Restoration
- [논문리뷰] SpatialBlock: Enhancing Spatial Intelligence in LVLMs via Synthetic Block-Stacking Problem
Review 의 다른글
- 이전글 [논문리뷰] DriveZero: End-to-End Driving Beyond Human Demonstrations
- 현재글 : [논문리뷰] Eliciting Weak-to-Strong Generalization with On-Policy Reverse Distillation
- 다음글 [논문리뷰] Encoded Early, Used Late: Where Transformers Begin to Act on an Inferred Partner's Expertise
댓글