[논문리뷰] SpatialBlock: Enhancing Spatial Intelligence in LVLMs via Synthetic Block-Stacking Problem
링크: 논문 PDF로 바로 열기
메타데이터
저자: Soohyun Ryu, Sohee Kim, Eunho Yang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Spatial Intelligence: 2D 이미지로부터 3D 구조를 정신적으로 재구성하고 이에 대해 추론하는 능력.
- SpatialBlock-15k: 3D-to-2D projection, viewpoint transformation, structural combination을 포함하는 15,000개의 합성 블록 쌓기 문제 데이터셋.
- Visual Cue: 컬러 변조를 통해 깊이 정보나 구조적 대응을 제공하여 모델이 특정 객체를 앵커(anchor)로 삼아 공간 관계를 이해하도록 돕는 보조 정보.
- SpatialBlock-direct: 데이터셋을 학습하여 복잡한 단계 없이 시각적 입력을 직접 정답으로 매핑하도록 훈련된 모델.
- SpatialBlock-reason: LoRA-based initialization 이후 GRPO(Group Relative Policy Optimization)를 사용하여 논리적 추론 과정을 먼저 거치도록 강화학습된 모델.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LVLM(Large Vision-Language Model)이 2D 이미지로부터 3D 구조를 추론하는 공간 지능이 부족하다는 점을 해결하고자 한다. 기존 연구들은 실제 장면(real-scene)에 대한 dense한 기하학적 주석(annotation)에 의존하여 확장성이 낮고 비용이 많이 드는 한계가 있다 [Figure 1]. 저자들은 인간의 공간 인지 발달 과정에서 블록 쌓기 놀이가 핵심적인 역할을 한다는 점에 주목한다. 따라서 본 연구는 복잡하고 비용이 많이 드는 실사 데이터 대신, 기초적인 공간 기술을 학습할 수 있는 체계적인 합성 데이터셋을 통해 공간 지능을 강화하는 새로운 패러다임을 제안한다.
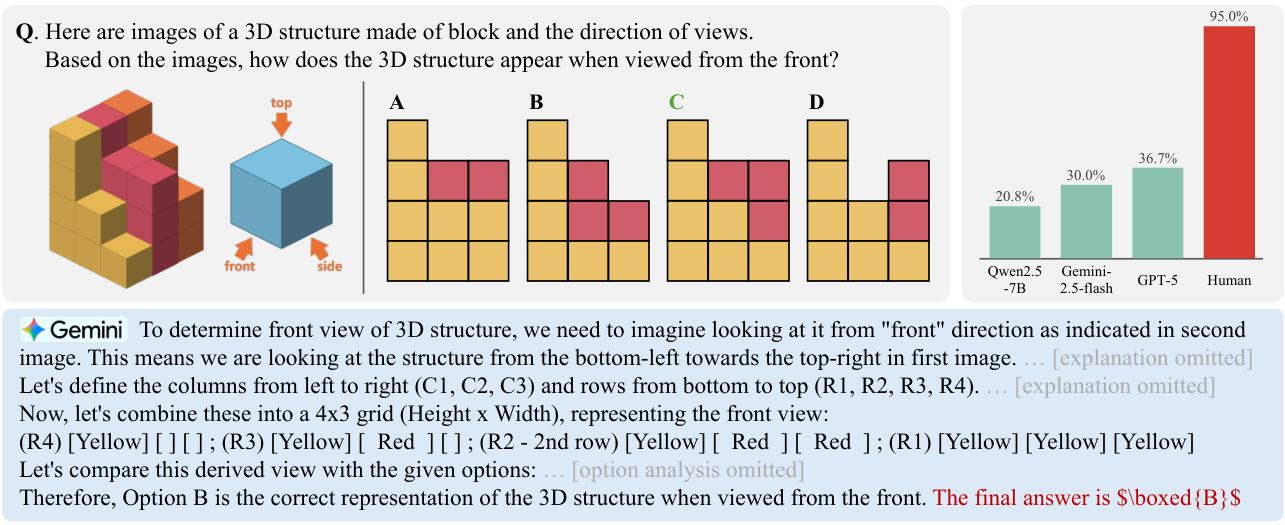
Figure 1 — 인간과 LVLM의 공간 인지 격차
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 3D-to-2D projection, viewpoint transformation, structural combination 세 가지 유형으로 구성된 SpatialBlock-15k를 구축하고, 여기에 컬러 기반 visual cue를 추가하여 모델의 앵커 기반 추론 능력을 극대화했다 [Figure 3]. 모델 학습을 위해 SpatialBlock-direct 전략으로 빠른 정답 예측 능력을 배양하고, SpatialBlock-reason 전략으로 LoRA 초기화 후 GRPO를 활용한 강화학습을 통해 단계적인 구조적 추론 능력을 강화했다. 실험 결과, SpatialBlock-3B-direct 모델은 MindCube 벤치마크에서 기존 최고 성능 모델 대비 2.7% 향상된 성능을 보였으며, SpatialBlock-4B-direct는 51.3%의 정확도로 오픈 소스 모델 중 가장 뛰어난 성능을 기록했다 [Table 1]. 또한, 추론 강화 모델은 MMSI-Bench와 같은 복잡한 논리적 추론 작업에서 Baseline 대비 우수한 성능을 입증하며, 합성 데이터만으로도 실세계 공간 추론 작업으로의 효과적인 일반화(generalization)가 가능함을 보였다 [Table 1].
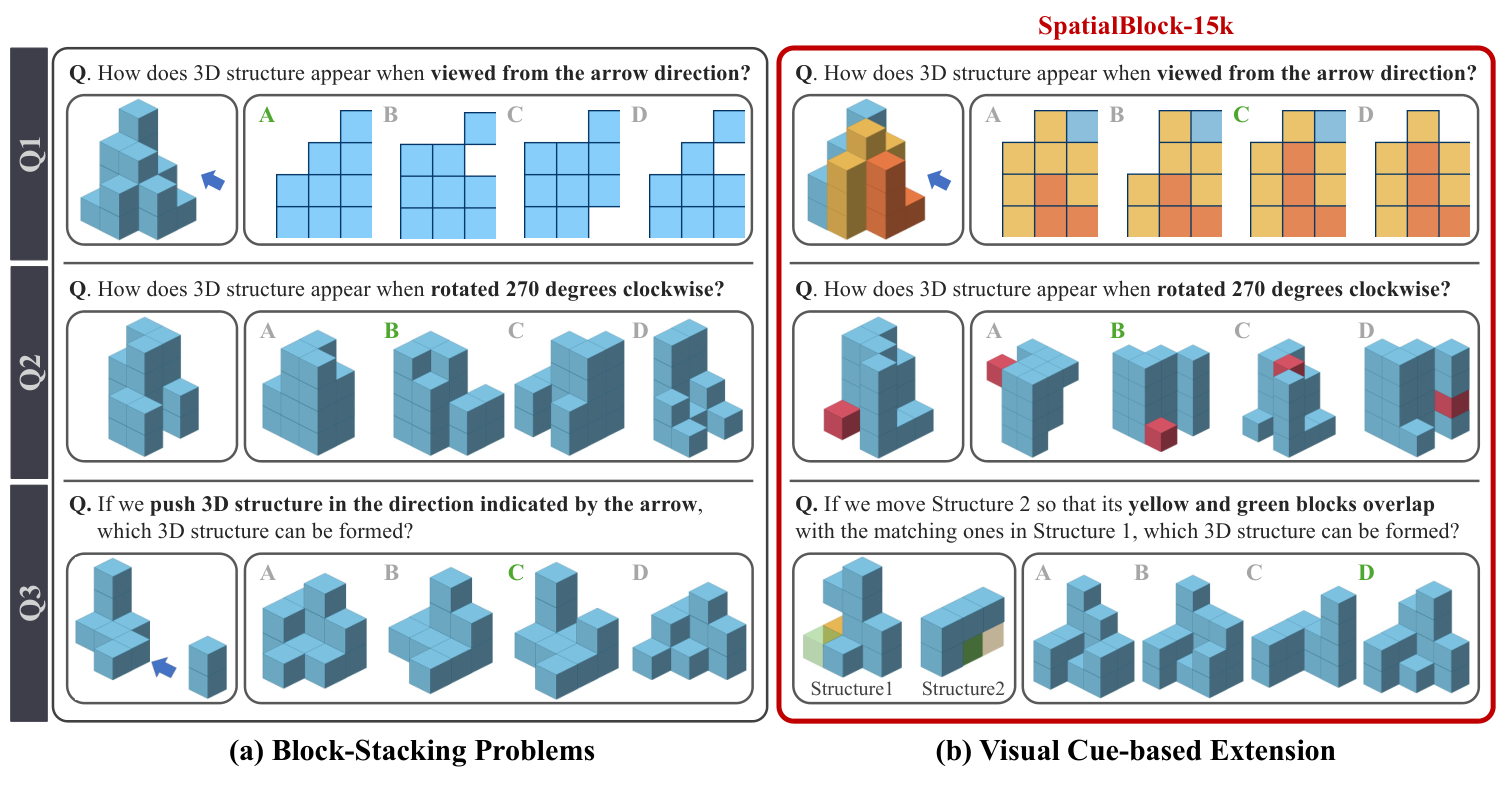
Figure 3 — SpatialBlock-15k 데이터셋 구조
4. Conclusion & Impact (결론 및 시사점)
본 논문은 주석이 많이 필요한 실사 데이터 의존에서 벗어나, 구조화된 합성 태스크를 통해 LVLM의 기초 공간 지능을 학습시키는 효율적인 대안을 제시한다. 제안된 SpatialBlock-15k 데이터셋과 두 가지 학습 전략은 모델이 실세계 환경에서도 견고한 공간 추론을 수행하게 함으로써 범용적 공간 이해 능력을 향상시켰다. 이 연구는 향후 로보틱스나 자율주행과 같이 높은 공간 지능을 요구하는 분야에서 LVLM을 적용하는 데 있어 확장 가능하고 비용 효율적인 데이터 학습 파이프라인을 구축하는 중요한 이정표가 될 것이다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SpatialTree: How Spatial Abilities Branch Out in MLLMs
- [논문리뷰] Agentic Game Development as a Verifiable Trajectory Data Engine for Scaling World Models
- [논문리뷰] MentalThink: Shaping Thoughts in Mental SVG World
- [논문리뷰] Thinking with Visual Grounding
- [논문리뷰] AlloSpatial: Agentic Harness Framework for Spatial Reasoning in Foundation Models
Review 의 다른글
- 이전글 [논문리뷰] SenseNova-U1.5: Towards Native Unified Visual Intelligence
- 현재글 : [논문리뷰] SpatialBlock: Enhancing Spatial Intelligence in LVLMs via Synthetic Block-Stacking Problem
- 다음글 [논문리뷰] UniH^3: Unifying Hierarchical Homogeneity and Heterogeneity for All-in-One Medical Image Restoration
댓글