[논문리뷰] SenseNova-U1.5: Towards Native Unified Visual Intelligence
링크: 논문 PDF로 바로 열기
메타데이터
저자: Haiwen Diao, Jiahao Wang, Chenjing Ding, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Native Unified Modeling: 별도의
Vision Encoder나VAE없이, 픽셀과 텍스트를 하나의 모델에서 직접 학습하여 이해(Understanding), 추론(Reasoning), 생성(Generation)을 수행하는 패러다임입니다. - MoT (Mixture-of-Transformers): 이해와 생성을 하나의
Transformer백본 내에 통합하되, 토큰 유형에 따라 서로 다른 파라미터를 동적으로 라우팅하여 효율적인 병렬 처리를 지원하는 아키텍처입니다. - Flow Matching: 픽셀 공간에서 노이즈로부터 이미지를 생성하는 학습 목표(Objective)로, 기존의
Diffusion기법보다 직접적으로 픽셀 값의 궤적을 학습하는 효율적인 생성 프레임워크입니다. - On-Policy Distillation (OPD): 학생 모델이 자신의 생성 궤적을 기반으로 학습하고, 전문화된 교사 모델의 지도를 받아 여러 도메인의 능력을 하나의 정책으로 통합하는 후학습(Post-training) 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 복합적 비전 생성 시스템이 가진 아키텍처 분리 문제를 해결하고자 합니다. 대부분의 모델은 Vision Encoder와 VAE를 각각 사용하여 인지 영역과 생성 영역을 분리하는데, 이는 정보의 왜곡과 효율성 저하를 초래합니다. 기존의 SenseNova-U1은 이를 극복했지만, 독립적인 패치 예측 방식으로 인해 고해상도 생성 시 경계선이 발생하거나 텍스처가 불연속적인 한계가 있었습니다. 이를 해결하기 위해 저자들은 정보 교환이 가능한 spatially joint 재구성 방식이 필요함을 강조합니다 [Figure 3].
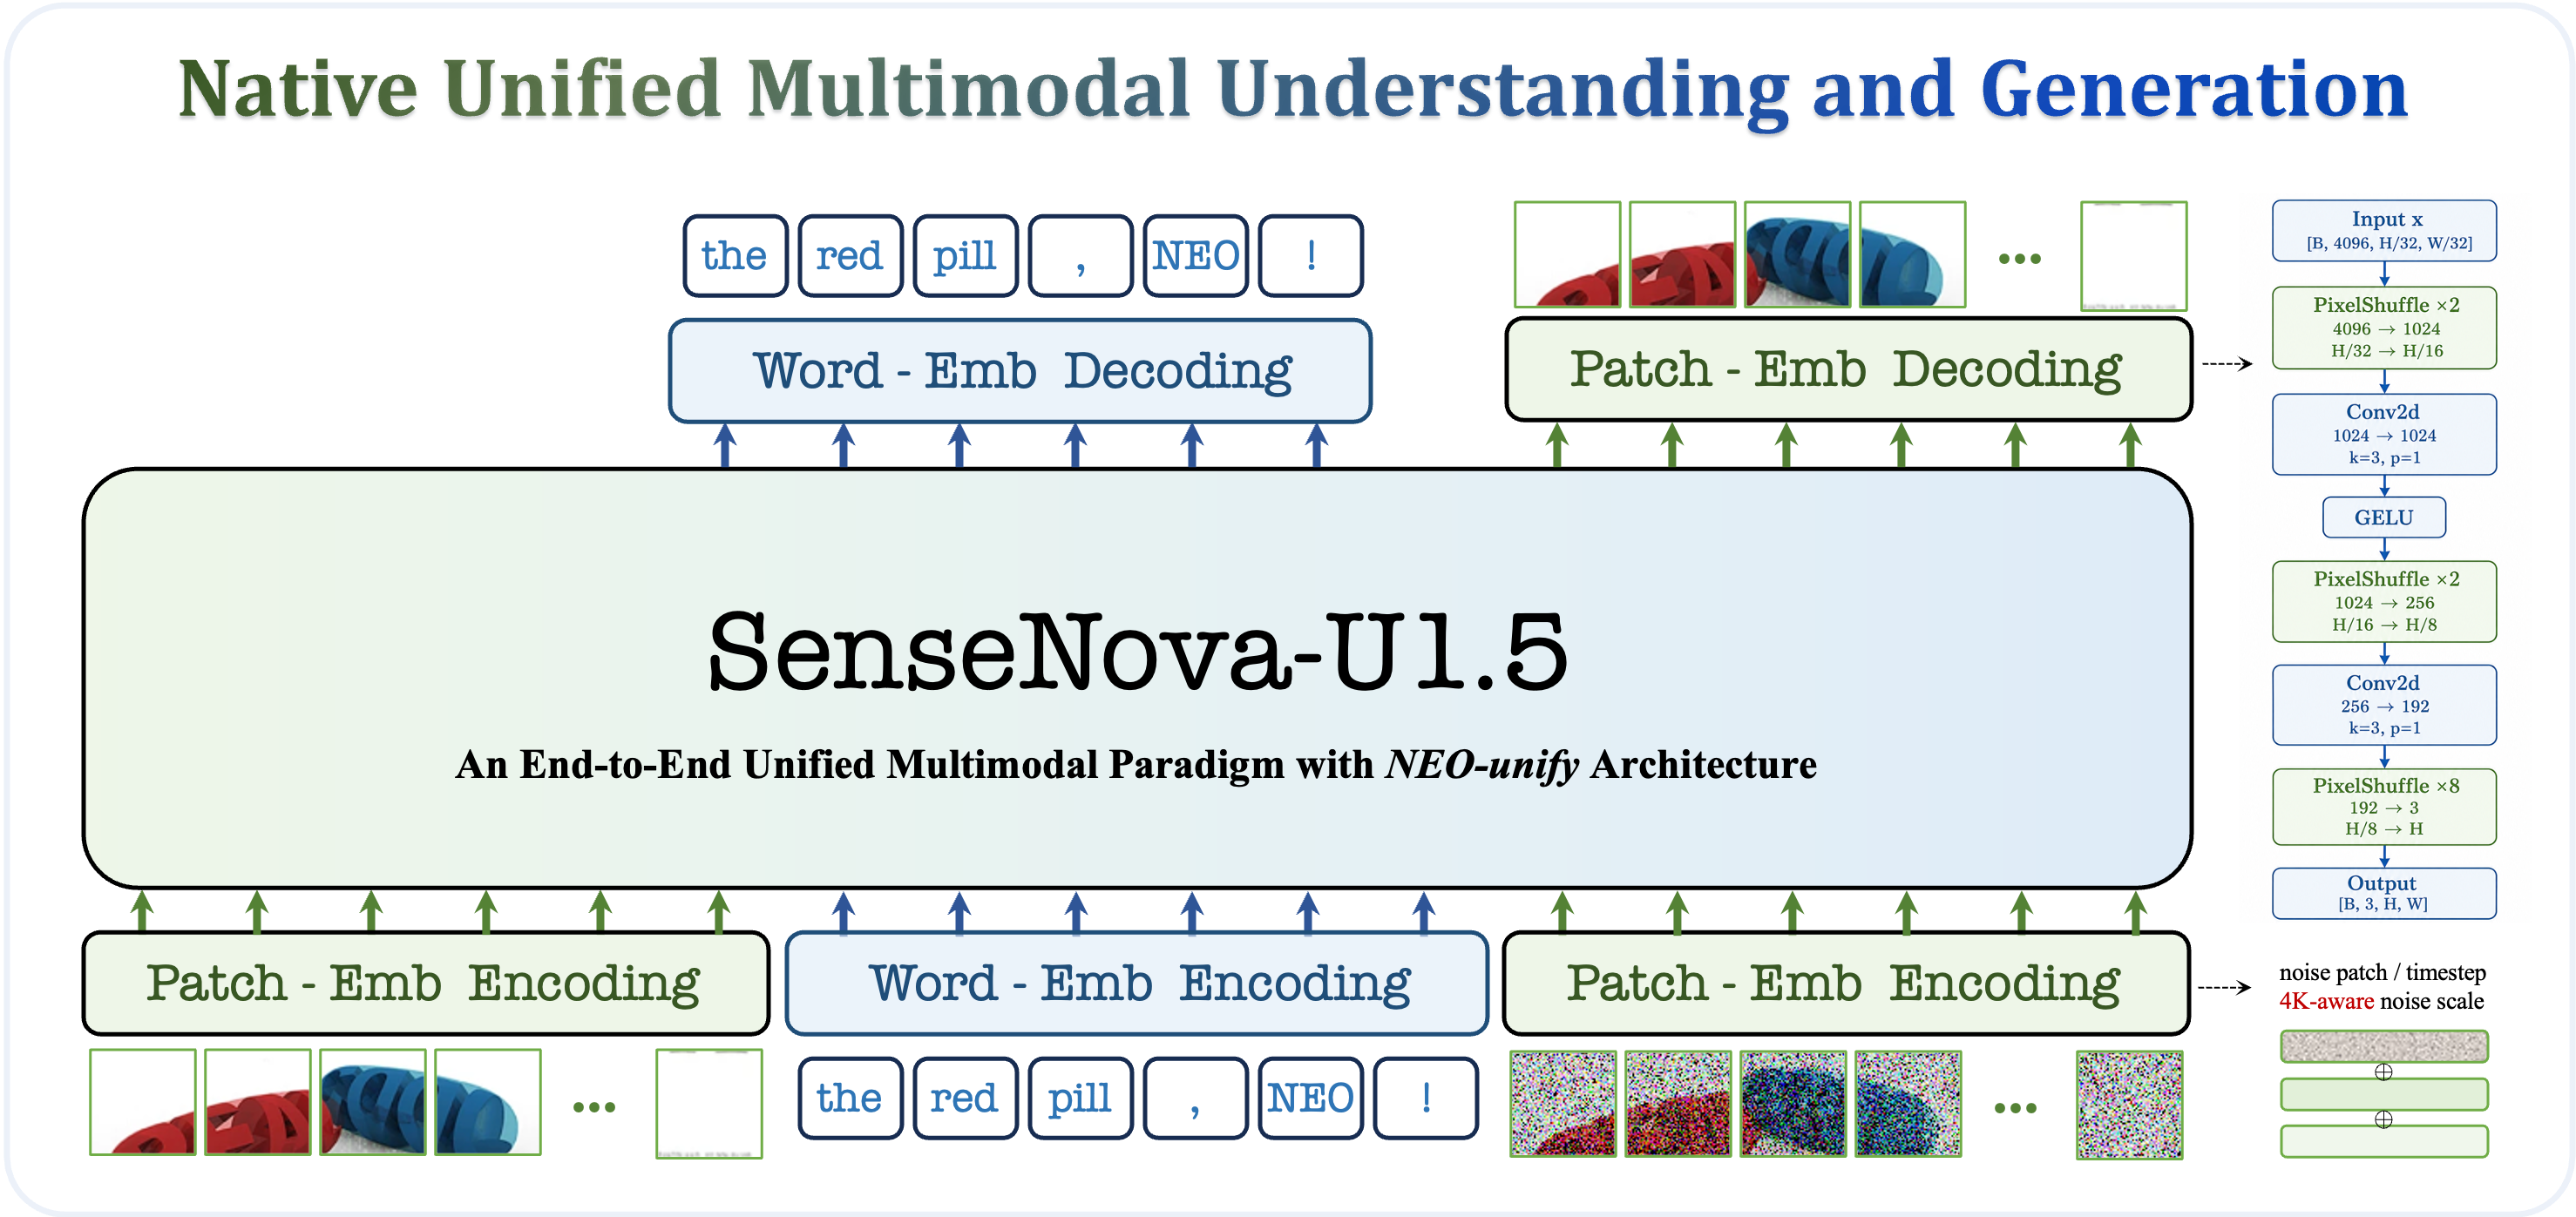
Figure 3 — SenseNova-U1.5 아키텍처
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 spatially joint 재구성과 specialize-then-unify 전략을 채택한 SenseNova-U1.5를 제안합니다. 아키텍처 측면에서는 기존의 패치 단위 MLP 대신 공간적 연속성을 보존하는 Pixel Shuffle과 3x3 컨볼루션을 갖춘 spatially coupled decoder를 도입하였습니다 [Figure 3]. 학습 단계에서는 aesthetic, OCR, infographic, image editing 분야의 전문가 모델을 각각 학습시킨 후, OPD를 통해 이들의 능력을 단일 모델로 통합하였습니다 [Figure 4].
정량적 실험 결과, SenseNova-U1.5는 고해상도(최대 4K) 생성에서 향상된 공간적 일관성과 텍스트 렌더링 성능을 입증하였습니다. 특히, 복잡한 인포그래픽 디자인과 다중 참조(multi-reference) 편집 작업에서 기존 Baseline 모델 대비 정밀한 instruction following 성능을 보였으며, 30-step trajectory 기반의 효율적인 추론 환경에서 더 나은 visual fidelity를 달성하였습니다 [Figure 1, Figure 2].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 SenseNova-U1.5를 통해 인지, 추론, 생성을 단일 비전 기반에서 통합하는 native unified modelling의 가능성을 증명했습니다. spatially joint 재구성과 다중 전문가 OPD 전략은 대형 모델의 아키텍처를 단순화하면서도 성능을 극대화할 수 있음을 보여줍니다. 이 연구는 학계 및 산업계에서 인지 지능과 생성 지능을 결합하는 차세대 멀티모달 프레임워크의 중요한 이정표가 될 것으로 기대됩니다.
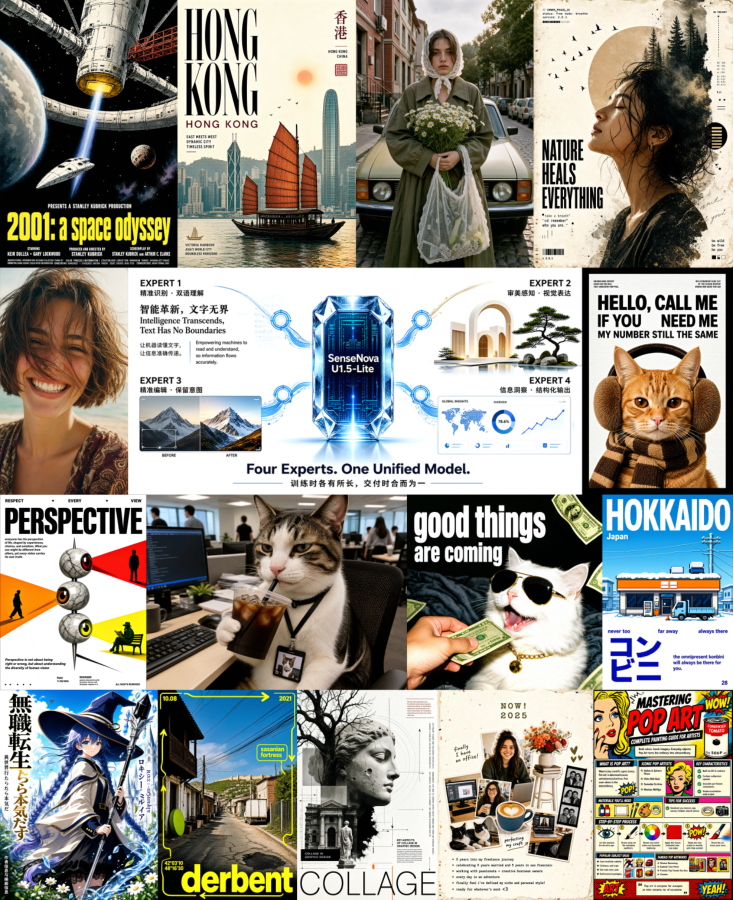
Figure 1 — 인포그래픽 및 인물 생성 예시
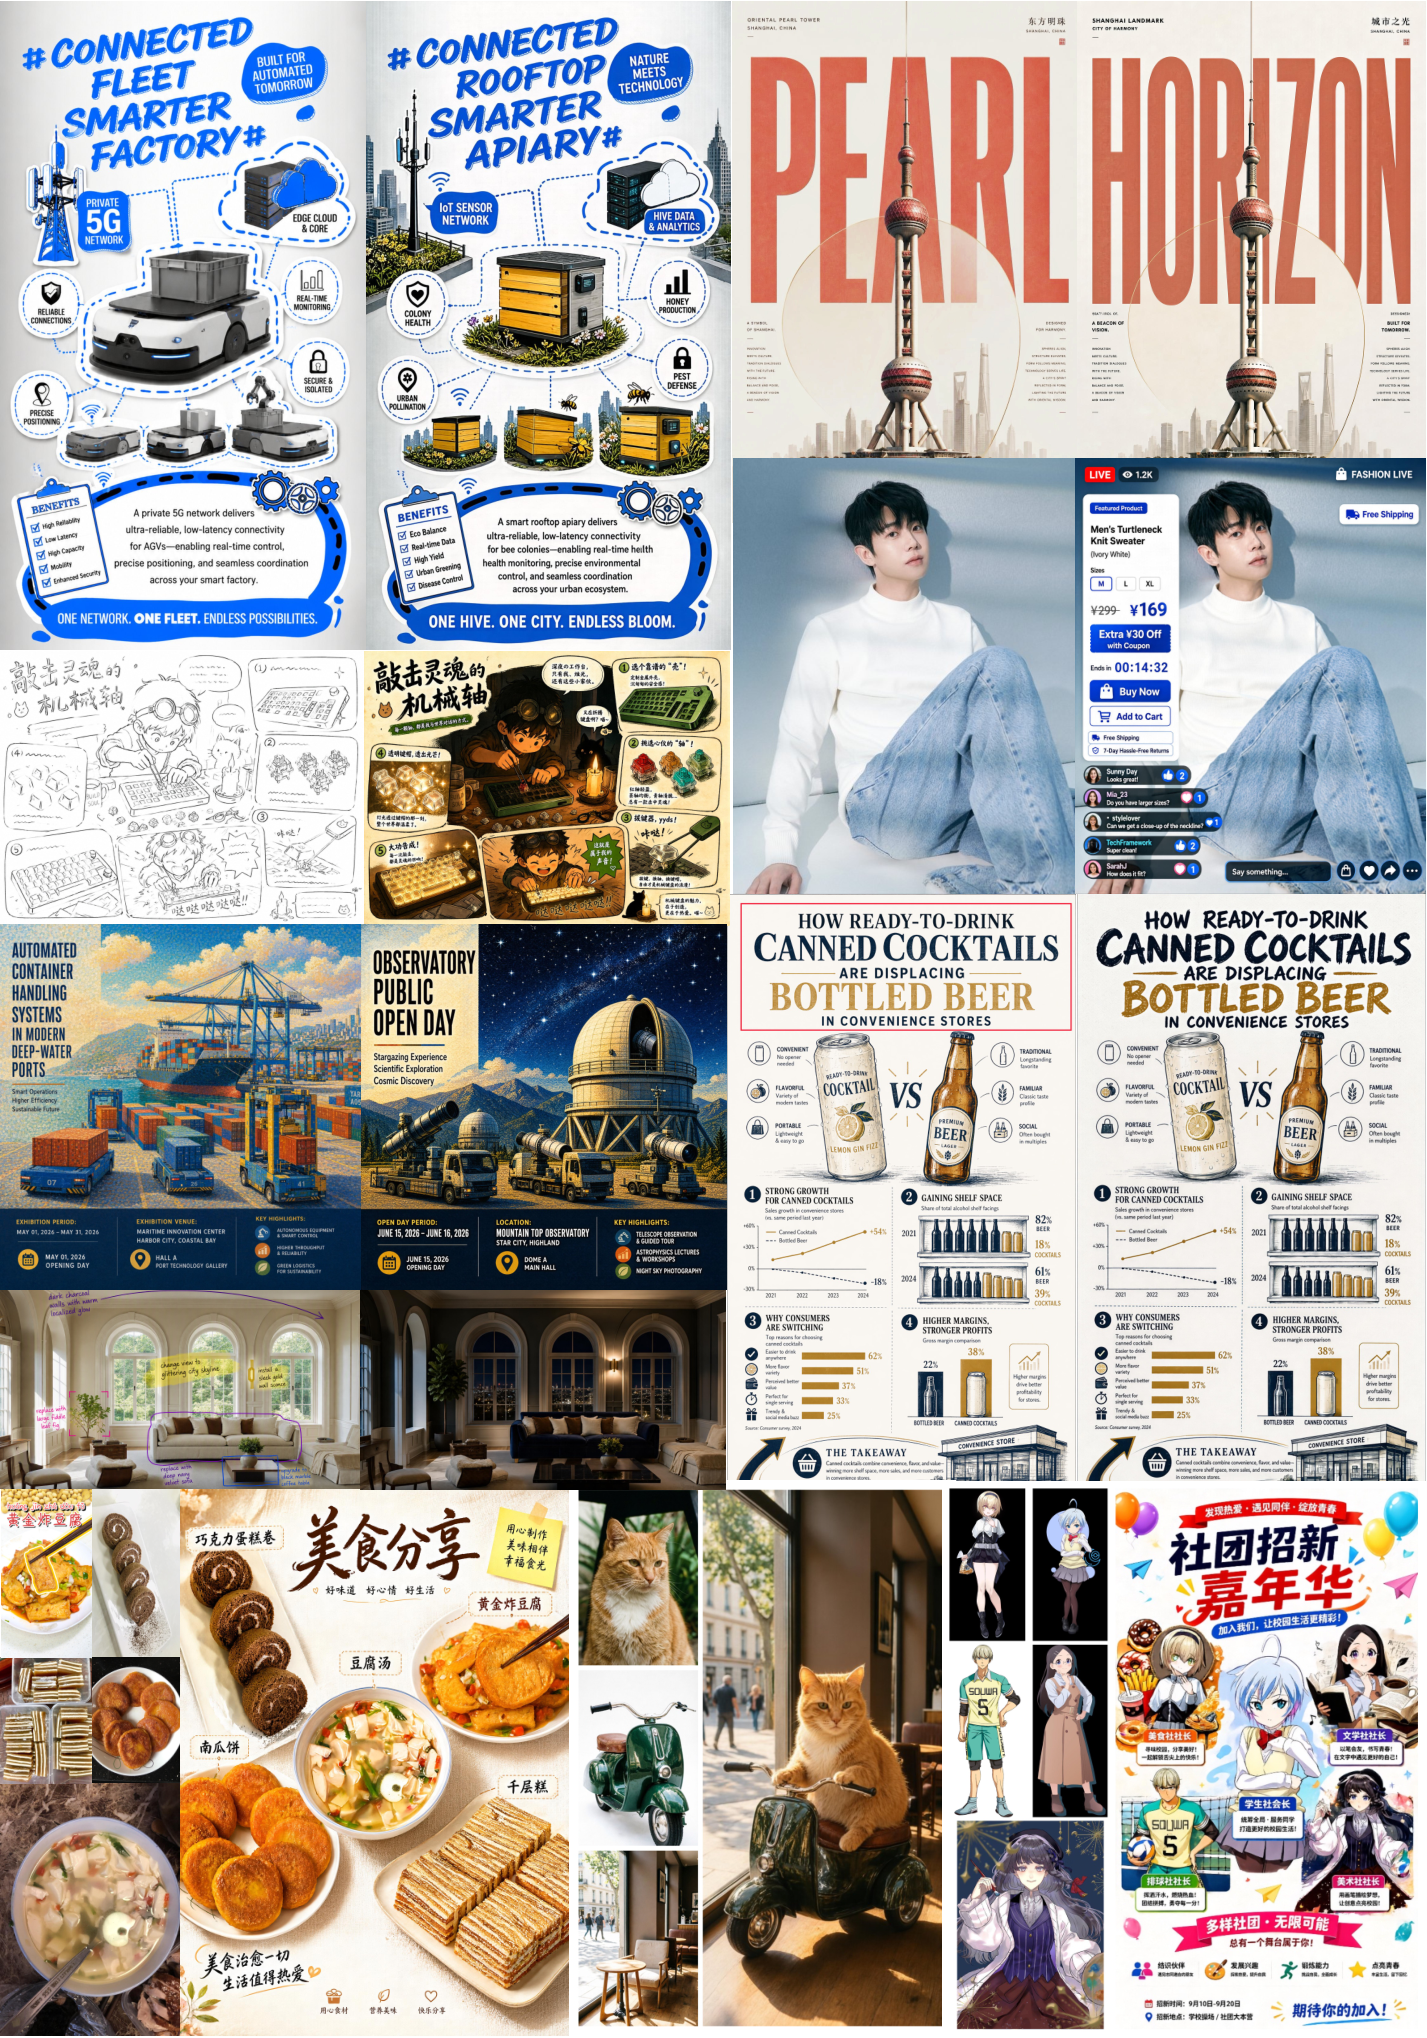
Figure 2 — 이미지 편집 및 다중 참조 생성
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Self-OPD: On-Policy Distillation for Flow Matching Models without Teacher
- [논문리뷰] Poly-OPD: Heterogeneous Multi-Teacher On-Policy Distillation for Capability-Selectable Flow Models
- [논문리뷰] StatePlay: State-Aware Game World Models for Mechanics-Consistent Generation
- [논문리뷰] GigaWorld-Policy-0.5: A Faster and Stronger WAM Empowered by AutoResearch
- [논문리뷰] DanceOPD: On-Policy Generative Field Distillation
Review 의 다른글
- 이전글 [논문리뷰] Recursive Code World Models: Building Complex Worlds through Recursive Scene Programs
- 현재글 : [논문리뷰] SenseNova-U1.5: Towards Native Unified Visual Intelligence
- 다음글 [논문리뷰] SpatialBlock: Enhancing Spatial Intelligence in LVLMs via Synthetic Block-Stacking Problem
댓글