[논문리뷰] Omni-Streaming Thinking
링크: 논문 PDF로 바로 열기
저자: Enjun Du, Siyi Liu, Ziyu Zheng, Jingyu Li, Yiwen Guo, Yongqi Zhang, Difan Zou et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Omni-Streaming Thinking (OST): 스트리밍 오디오-비주얼 모델이 상충하는 멀티모달 증거를 처리하고 시간에 따라 추론을 업데이트하도록 설계된 제안 프레임워크입니다.
- Premature Cross-Modal Commitment: 한 모달리티(예: 시각)의 초기 해석이 다른 모달리티(예: 오디오)에서 상반되는 증거가 완전히 도달하기 전에 메모리 내에서 '사실'로 굳어져 지속적인 오류로 이어지는 실패 모드입니다.
- Claim: OST 내에서 아직 해결되지 않은 해석으로, 미래 검증 구간 및 특정 검증 모달리티에 연결되어 있습니다.
- Omni-State: OST에서 현재 해석을 나타내는 6개 필드(visual_evidence, audio_state, audio_evidence, conflict, forecast, sufficiency)로 구성된 구조화된 표현입니다.
- OST-DiagBench: 모델이 시각적 단서와 일치하거나, 상충하거나, 공존하는 상황에서 청각적 증거를 어떻게 활용하는지 측정하기 위해 도입된 진단 벤치마크입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 스트리밍 오디오-비주얼 모델이 불완전하고 순차적으로 관찰되는 데이터에서 적시에 응답해야 하는 근본적인 문제에 직면하고 있음을 지적합니다. 이 모델들은 Modality-asymmetric evidence maturation이라는 현상으로 인해 어려움을 겪는데, 이는 시각적 단서가 종종 발언이나 음향 이벤트가 완료되기 전에 특정 해석을 가능하게 하는 반면, 청각적 증거는 더 긴 해석 시간을 요구하여 증거 도달 시점의 불균형을 초래하기 때문입니다. 이러한 시간적 격차는 premature cross-modal commitment라는 실패 모드로 이어지며, 이는 특정 모달리티로부터의 조기 추측이 검증에 필요한 증거가 도착하기도 전에 사실로 기록되어 이후의 추론에서 지속적인 오류를 야기하는 문제입니다 [Figure 1]. 기존 스트리밍 방법론은 메모리 관리 및 응답 타이밍에 중점을 두지만, 이러한 조기 추측이 메모리 내에서 지속되고 전파되어 최종 답변에 영향을 미치는 경로를 명시적으로 해결하지 못했습니다. 특히, 시각적 단서에 대한 편향(visual bias)이 존재하며, 이는 시청각 모델이 오디오를 적절하게 사용하지 못하게 만듭니다.
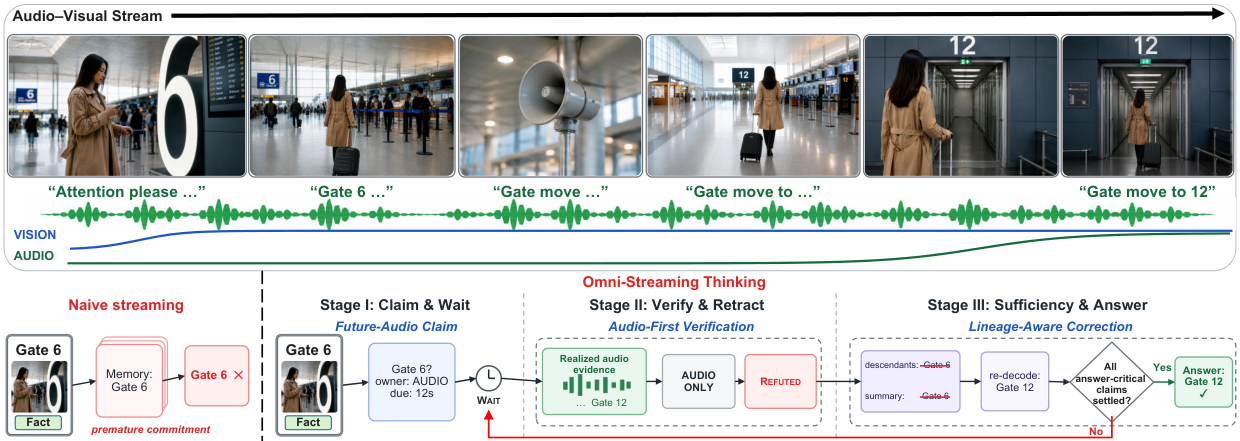
Figure 1 — 조기 교차 모달 커밋먼트
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 Omni-Streaming Thinking (OST)이라는 프레임워크를 제안하여 미해결된 해석을 검증 가능한 claims에 연결하고, 이러한 claims의 검증 결과를 기반으로 메모리를 업데이트하며, 후속 예측을 안내합니다 [Figure 2]. OST는 claim–verify–retract 루프를 핵심 메커니즘으로 사용합니다. 구체적으로, OST는 현재 Omni-State에서 claims를 생성하며, 각 claim은 미래 증거의 예측, 검증을 위한 특정 modality, 그리고 미래 검증 간격(future verification interval)을 포함합니다. modality-asymmetric evidence maturation 문제를 해결하기 위해 OST는 오디오와 시각 증거를 개별적으로 보관하는 separated audio and visual retention 전략을 사용하며, 검증이 예정된 증거 창은 고정(pinning)하여 필요시 언제든 접근 가능하도록 합니다.
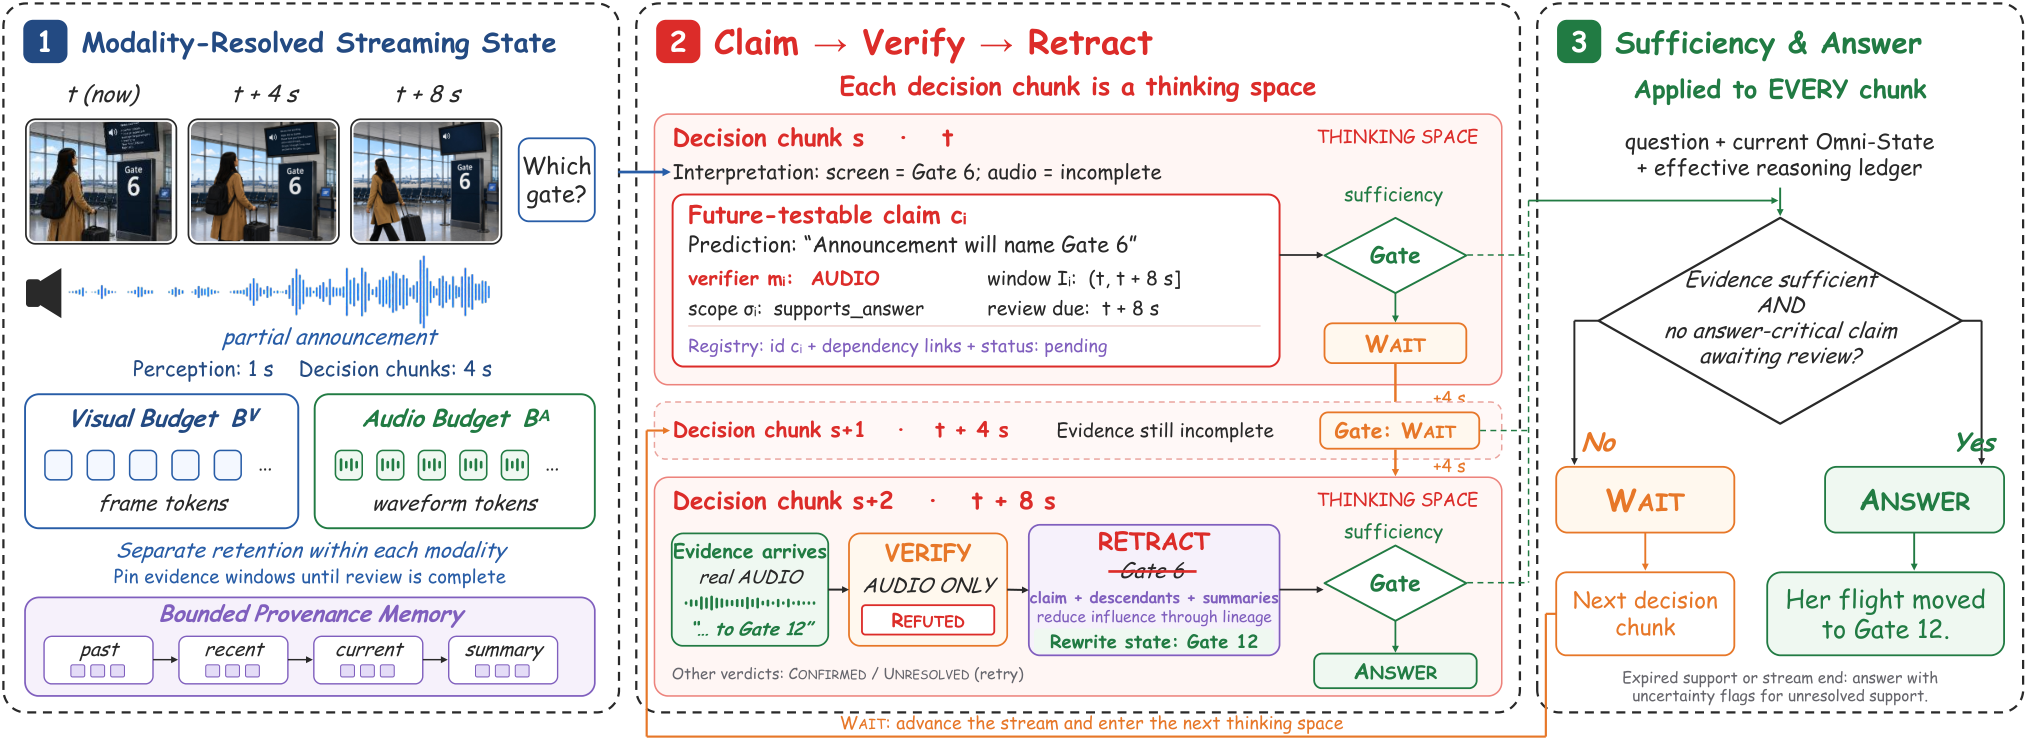
Figure 2 — OST 전체 아키텍처
Verification and causal retraction 단계에서는 claim의 증거 창이 닫히면, 검증자가 해당 claim을 보관된 증거와 비교합니다. 만약 모순되는 증거가 발견되어 Refuted 판정이 나면, refutation process가 해당 claim과 그에 의존하는 메모리 내의 모든 상태의 영향력을 reliability scores를 통해 감소시킵니다. 이어서 Verdict-conditioned continuation은 새로운 증거를 사용하여 Omni-State를 다시 작성(rewriting)하고, 수정된 해석에 따라 새로운 예측을 안내합니다. 마지막으로, answer gate는 답변에 중요한 claims가 답변 조건을 충족하는지 여부를 판단하여 Wait 또는 Answer를 결정합니다. 이 모든 과정은 Qwen3-Omni-30B-A3B-Instruct 백본에 경량의 어댑테이션을 적용하여 이루어집니다 [Figure 5].
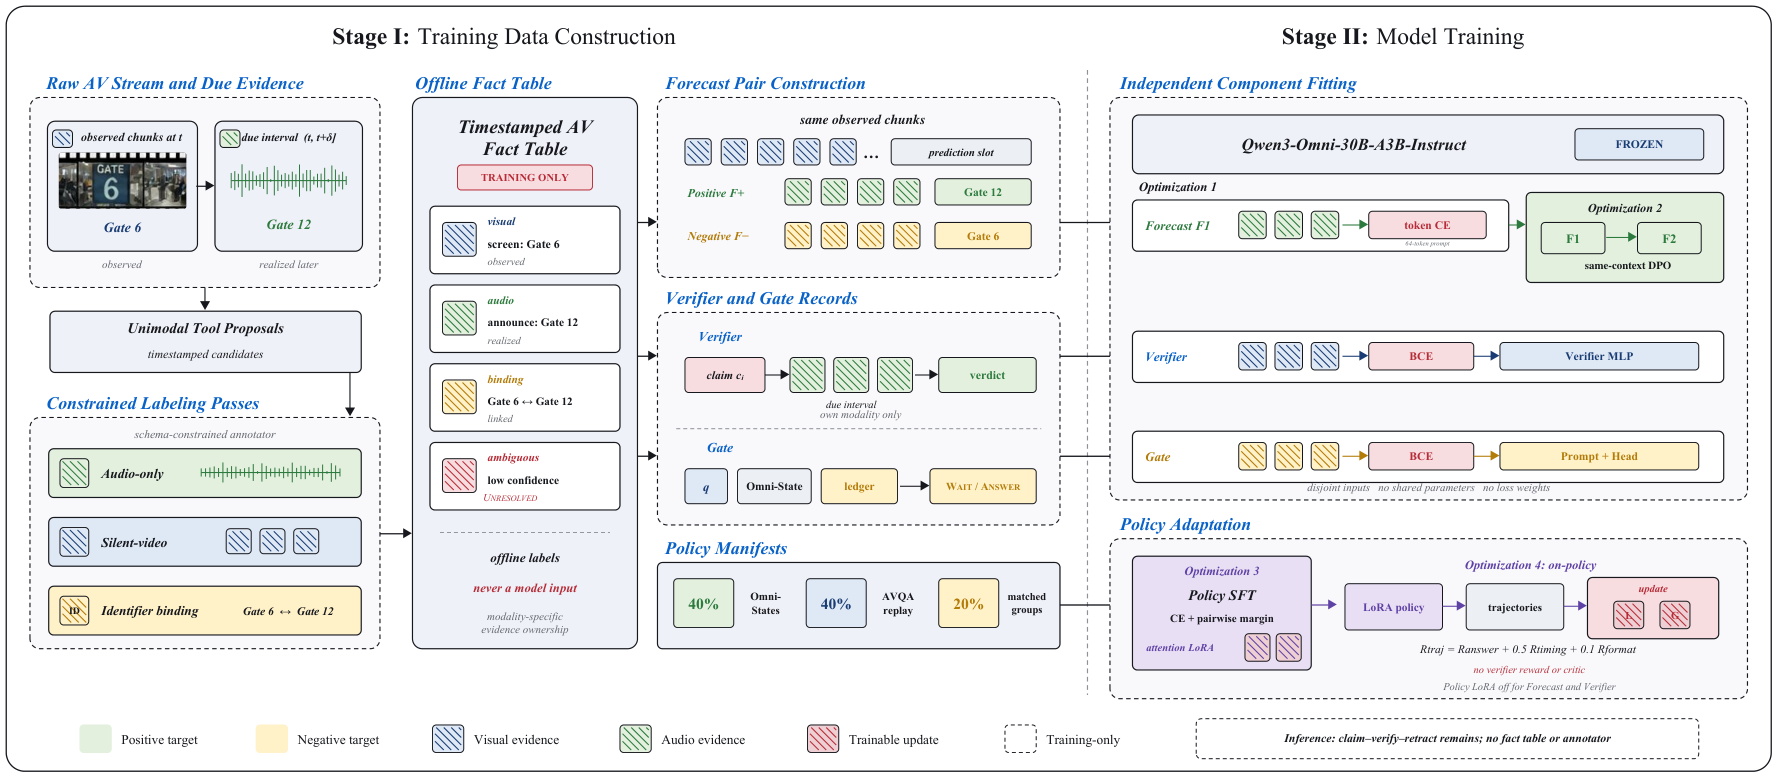
Figure 5 — OST 훈련 파이프라인
실험 결과, OST는 5가지 스트리밍 및 오디오-비주얼 벤치마크(SOVBench, StreamingBench, Video-Holmes, Daily-Omni, OmniVideoBench 포함)에서 가장 강력한 오픈 소스 베이스라인 대비 평균 10% 이상의 상대적 성능 향상을 달성했습니다. 특히, SOVBench-O 벤치마크에서는 오디오-비주얼 컨텍스트에서 평균 정확도 87.8%, QA 컨텍스트에서 88.4%를 기록하여 StreamOV의 81.6% 및 83.8%를 상회했습니다 [Table 1]. 또한, 새로 도입된 OST-DiagBench에서 OST는 d'=2.95라는 진단 성능을 달성하여 오픈 베이스라인의 최대 1.38을 크게 뛰어넘었으며, 시각 유도 청각 환각(vision-induced auditory hallucinations)을 효과적으로 감소시켰습니다 [Table 2, Figure 4]. 이는 OST가 청각적 증거의 부재, 모순, 공존 상황에서 더 강력하게 오디오를 활용함을 보여줍니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 스트리밍 오디오-비주얼 추론 시스템에서 발생하는 premature cross-modal commitment 문제를 해결하기 위한 혁신적인 프레임워크인 Omni-Streaming Thinking (OST)을 제시합니다. OST는 미해결된 해석을 미래 검증 가능한 claims로 전환하고, 이러한 claims의 검증 결과를 의존성 인지 retraction 및 상태 rewriting 메커니즘과 연동함으로써 새로운 증거에 따라 모델의 추론 상태를 효과적으로 수정합니다. 이 접근 방식은 모델이 초기 시각적 추측이 이후 청각적 증거에 의해 반박될 때 발생하는 영구적인 오류를 방지할 수 있도록 합니다.
이 연구는 5가지 주요 스트리밍 및 오디오-비주얼 벤치마크에서 기존 최고 성능을 능가하는 결과를 보여줌으로써 해당 분야의 기술적 진보에 크게 기여합니다. 특히, OST-DiagBench의 도입은 모델의 cross-modal bias를 진단하는 새로운 표준을 제시하며, 향후 연구에서 더 강력하고 신뢰할 수 있는 멀티모달 AI 모델을 개발하는 데 중요한 도구가 될 것입니다. 궁극적으로 OST는 비동기적으로 증거가 도달하거나 모순될 수 있는 복잡한 실시간 스트리밍 환경에서 보다 정확하고 상황을 인지하는 AI 어시스턴트의 발전에 중요한 시사점을 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Audio-Visual Flamingo: Open Audio-Visual Intelligence for Long and Complex Videos
- [논문리뷰] OmniVideo-100K: A Dataset for Audio-Visual Reasoning through Structured Scripts and Evidence Chains
- [논문리뷰] LatentOmni: Rethinking Omni-Modal Understanding via Unified Audio-Visual Latent Reasoning
- [논문리뷰] FactReview: Evidence-Grounded Reviews with Literature Positioning and Execution-Based Claim Verification
- [논문리뷰] FutureOmni: Evaluating Future Forecasting from Omni-Modal Context for Multimodal LLMs
댓글