[논문리뷰] ZGCM-1: A Fully Open and Extremely Efficient Foundation Model for Math and Agentic Search
링크: 논문 PDF로 바로 열기
저자: Jiyan He, Guang Liang, Hao Liu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- ZGCM-1: 7.39B 파라미터를 가진 완전 오픈소스 Foundation Model로, 수학적 추론 및 Agentic Search 작업에 최적화되어 있다.
- Hybrid Attention Architecture: Gated Sliding-Window Attention (SWA)과 Global Attention을 5:1 비율로 interleaving하여 Context Length가 긴 시퀀스에서도 효율성을 높인 아키텍처이다.
- FP8 Precision: E4M3 for forward pass, E5M2 for backward pass를 사용하는 혼합 정밀도 학습 방식으로, 연산 효율성을 극대화한다.
- MDP Mid-Training: 상호작용 trace를 Markov Decision Process (MDP)의 State-Action Transition으로 재구성하여 dense하고 Step-level의 Supervision을 제공하는 Mid-Training 기법이다.
- AI-Native R&D: 연구 개발(R&D) Lifecycle 전반에 걸쳐 LLM 기반 Agent가 데이터 처리, 실험, 평가, 배포 등의 작업을 자율적으로 수행하도록 설계된 워크플로우이다.
- KV Cache: Transformer 모델의 Inference 시 Key와 Value tensor를 저장하는 메모리로, ZGCM-1의 Hybrid Attention 아키텍처를 통해 효율성이 개선되었다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Foundation Model 분야에서 수학적 추론 및 Agentic Problem Solving의 발전이 겪는 두 가지 주요 BottleNeck인 Scale Barrier와 Opacity Barrier를 해결하고자 한다. 기존의 최첨단 추론 및 Agentic Search 능력은 주로 hundred-billion-parameter systems에 국한되어 있어, 컴퓨팅 자원이 제한적인 연구자들은 이러한 Frontier-grade intelligence 훈련 및 탐색에서 소외되어 왔다. 또한, 대부분의 경쟁력 있는 모델들은 open-weight 형태로만 공개될 뿐, Upstream Filtering Recipe, Mid-Training Curriculum, Long-Context Schedule, Multi-turn Agent Trace 등 핵심 Training Recipe가 Proprietary Black Box로 남아 있어 Training Dynamics 및 Parametric Capacity Limit에 대한 체계적인 연구를 방해하고 있다. 저자들은 Compact Model이 Static Parametric Capacity의 본질적인 한계를 가질 수 있지만, 의도적인 Internal Thinking과 Active External Tool Use를 결합함으로써 이러한 한계를 초월할 수 있다는 Core Thesis를 제시한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 접근 가능한 Academic Compute 환경에서 ZGCM-1 모델의 Training 및 Inference를 효율적으로 만들기 위해 End-to-End, High-Efficiency Open Training Recipe를 개발하였다 [Figure 2]. 첫째, Hybrid Attention Architecture는 gated Sliding-Window Attention (SWA)과 Global Attention을 5:1 비율로 Interleaving하여 256K Context에서 Standard Full Attention 대비 3.94배의 Throughput Speedup과 6.4배의 KV Cache Reduction을 달성한다 [Figure 3, Figure 4]. 둘째, System-Algorithm Co-design으로 Muon Optimizer, Hybrid FP8 Precision (E4M3 Forward, E5M2 Backward), 그리고 TWEO Outlier Regularization을 결합하여 BF16/AdamW Baseline 대비 Pre-Training Time-to-Loss에서 약 4.2배의 Efficiency Improvement를 제공한다. 셋째, Progressive Curriculum & MDP Mid-Training에서는 600B Tokens에 걸쳐 Context를 16K → 64K → 256K로 점진적으로 확장하며, 상호작용 Trace를 Markov Decision Process (MDP) State-Action Transition으로 재구성하여 Dense하고 Step-level의 Supervision을 제공한다. 마지막으로, Execution-Grounded Alignment와 Mixed SFT (Supervised Fine-Tuning)를 통해 Deep Reasoning과 Direct-Response Efficiency의 균형을 맞춘 Mixed Think/No-Think Fine-tuning을 수행한다.
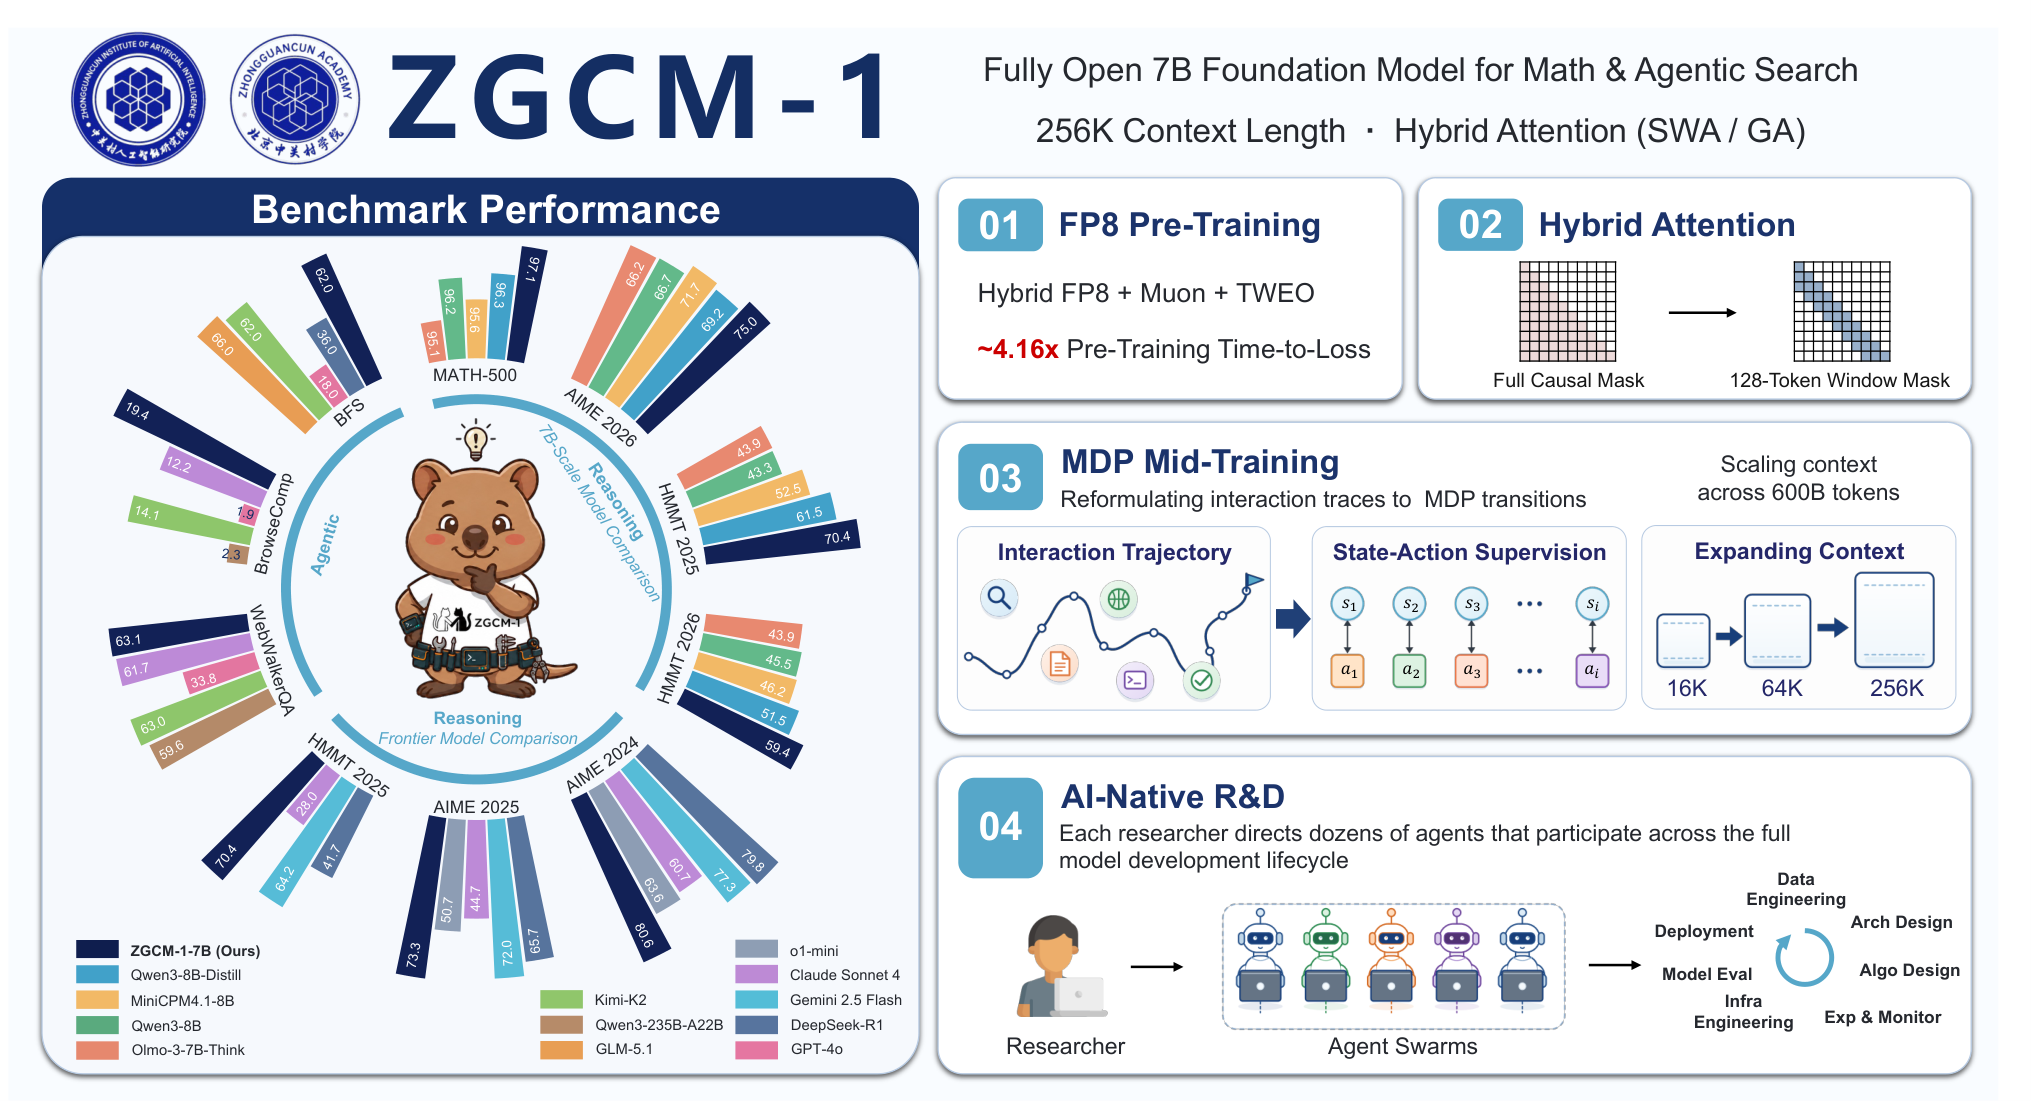
Figure 2 — ZGCM-1 모델 개요 및 주요 기술 하이라이트
광범위한 평가 결과, ZGCM-1-7B는 7B 규모의 모델 Family 중 General Benchmark에서 경쟁력을 보였으며, 특히 Challenging한 수학적 추론 및 Agentic Search Suite에서 Qwen3-235B-A22B 및 GLM-5.1과 같이 몇 배 더 큰 Frontier Model들과 대등한 성능을 유지하였다 [Figure 2]. 구체적으로, AIME 2026에서 75.0%, MATH-500에서 97.1%, HMMT 2025에서 70.4%의 점수를 기록했다. Agentic Search 능력으로는 WebWalkerQA에서 63.1%, BrowseComp에서 19.4%, Binary Function Search에서 62.0%의 정확도를 달성하며, GPT-4o를 능가하고 GLM-5.1에 근접하는 수준을 보여주었다 [Table 4].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 ZGCM-1이라는 7.39B 규모의 완전 오픈소스 Foundation Model을 제시하며, 256K Context 범위에서 복잡한 수학적 추론 및 Agentic Search를 위한 효율성을 최적화하였다. 이 연구는 Frontier-grade Reasoning이 반드시 수백억 개의 파라미터를 요구한다는 일반적인 가정에 도전하며, Compact Model이 Internal Reasoning과 External Tool Use를 결합함으로써 내재된 Parametric Capacity Limit을 극복할 수 있다는 Core Thesis를 성공적으로 입증하였다. 이 모델은 Hybrid Attention Architecture, FP8 Precision, Muon Optimizer, MDP Mid-Training, 그리고 AI-Native R&D Workflow와 같은 고효율 Recipe를 통해 뛰어난 성능과 효율성을 동시에 달성했다.
ZGCM-1의 개발은 학계 및 산업계에 중요한 시사점을 제공한다. 첫째, 컴퓨팅 자원이 제한적인 환경에서도 Frontier-grade Intelligence에 접근할 수 있는 효율적이고 투명한 Open Source Framework를 제공한다. 둘째, Pre-Training, Mid-Training, Post-Training 단계의 Model Weights, Checkpoint, Training Code, Data Recipe 및 W&B Log를 공개함으로써 Open Science 연구를 촉진하고 Reproducibility를 향상시킨다. 이는 Compact Model의 Scaling Dynamics, Long-Context Generalization, Agentic Co-Training 등 다양한 연구 영역에서 커뮤니티의 추가적인 탐색을 가능하게 할 것이다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Composition-RL: Compose Your Verifiable Prompts for Reinforcement Learning of Large Language Models
- [논문리뷰] Weak-Driven Learning: How Weak Agents make Strong Agents Stronger
- [논문리뷰] InftyThink+: Effective and Efficient Infinite-Horizon Reasoning via Reinforcement Learning
- [논문리뷰] TTCS: Test-Time Curriculum Synthesis for Self-Evolving
- [논문리뷰] OpenSIR: Open-Ended Self-Improving Reasoner
Review 의 다른글
- 이전글 [논문리뷰] When Agents Slow Down: Understanding LLM Agents' Test-Time Strategies via Elo-per-token Analysis
- 현재글 : [논문리뷰] ZGCM-1: A Fully Open and Extremely Efficient Foundation Model for Math and Agentic Search
- 다음글 [논문리뷰] AI for Games in the Foundation Model Era
댓글