[논문리뷰] When Agents Slow Down: Understanding LLM Agents' Test-Time Strategies via Elo-per-token Analysis
링크: 논문 PDF로 바로 열기
저자: Kaiyuan Liu, Qiuyang Mang, Bo Peng, Wenhao Chai, Hanchen Li, Shreyas Pimpalgaonkar, Luke Zettlemoyer, Alex Dimakis, Alvin Cheung, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Elo-per-token: LLM 에이전트의 테스트 타임 성능을 토큰 예산(token budget)에 따라 추적하고, 다양한 작업 간의 상대적 성과를 Bradley–Terry 모델을 사용하여 단일 Elo 점수 척도로 변환하는 평가 프레임워크입니다.
- Scaling Inflection Point: 에이전트의 테스트 타임 전략이 독립적인 샘플링(independent sampling)보다 성능 향상 효율이 떨어지기 시작하는 지점으로, 본 연구에서는 400 Elo-per-decade 기준선을 통해 정의합니다.
- Independent Sampling: 문제를 $n$번 독립적으로 풀고 가장 좋은 결과를 선택하는 베이스라인으로, log-compute에 대해 선형적인 Elo 성장을 보여주는 이론적 기준점입니다.
- Sticky-basin Hypothesis: 에이전트가 초기 단계에서 선택한 솔루션 공간(basin)에 고착화되어, 추가적인 컴퓨팅 자원을 투입해도 초기 basin 외부의 더 나은 솔루션을 탐색하기 어려워지는 현상을 설명하는 가설입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 LLM 에이전트가 테스트 타임(test-time)에 컴퓨팅 자원을 할당하는 방식과 그에 따른 성능 확장성을 체계적으로 측정하고자 합니다. 기존 벤치마크는 단일 결과물에 대한 pass/fail 여부만 판단하여, 에이전트가 토큰을 소비하며 진행하는 탐색 과정의 성능 개선을 측정하지 못하는 한계가 있습니다. 이를 해결하기 위해 저자들은 에이전트가 솔루션을 수정하고, 도구를 사용하며, 스스로 판단을 내리는 과정에서의 Test-Time Scaling (TTS) 특성을 정량화하고자 합니다. [Figure 1]은 에이전트가 반복 샘플링을 통해 얻는 성능 변화를 보여주며, 기존 에이전트들이 특정 임계점 이후 성능 향상이 정체되는 양상을 드러냅니다.
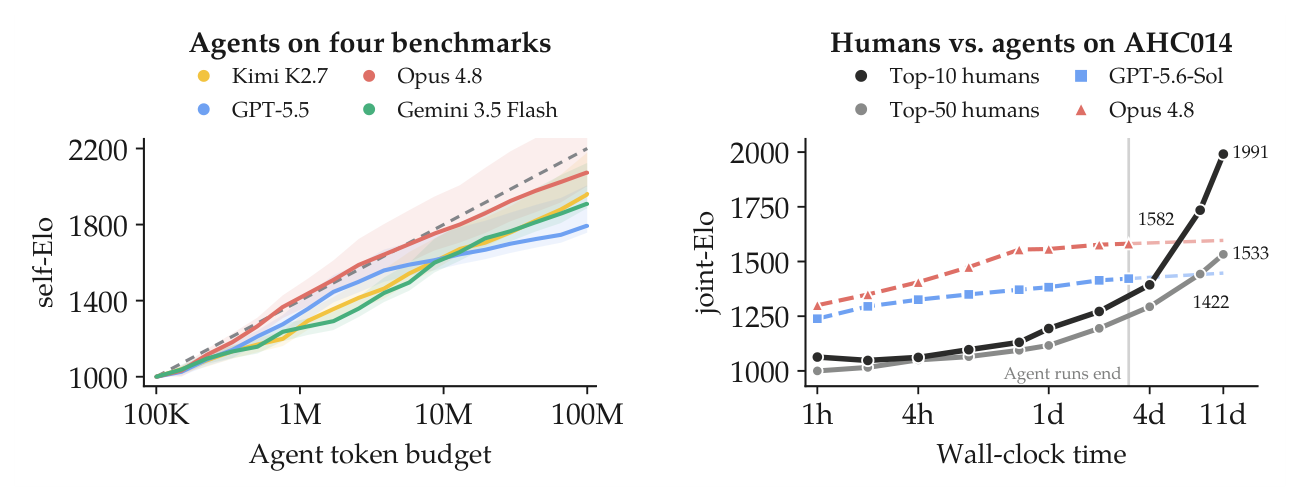
Figure 1 — 에이전트와 인간의 테스트 타임 성능 확장성 비교를 보여주는 핵심 결과 그래프
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 저자들은 Elo-per-token 분석법을 제안하여 에이전트, 샘플링 베이스라인, 인간의 성능을 동일한 척도에서 비교 평가하였습니다. 연구 결과, 일반적인 LLM 에이전트는 초기 단계에서 독립적 샘플링보다 빠르게 성능을 향상시키지만, 일정 토큰 예산을 초과하면 성능 향상이 정체되거나 독립적 샘플링의 효율보다 낮아지는 경향을 보입니다. [Figure 3]은 4개 벤치마크에서의 에이전트 scaling 패턴을 보여주며, 대부분의 에이전트가 로그-선형(log-linear) 수준의 성능 향상에 그침을 증명합니다. 반면, 인간은 [Figure 4] 및 [Figure 1]에서 볼 수 있듯이 contest time이 지남에 따라 초선형(superlinear) 성장을 보이며 에이전트를 추월하는데, 이는 에이전트가 가지지 못한 지속적 학습 능력(continual learning)을 시사합니다. 또한, 저자들은 Scaling Inflection Point를 활용하여 전체 토큰 예산을 단일 세션이 아닌 다수의 병렬 세션으로 분할할 때, FrontierCS Polyomino Packing 작업에서 기존 단일 세션 대비 +264 Elo 향상을 달성하는 최적화 전략을 확인했습니다.
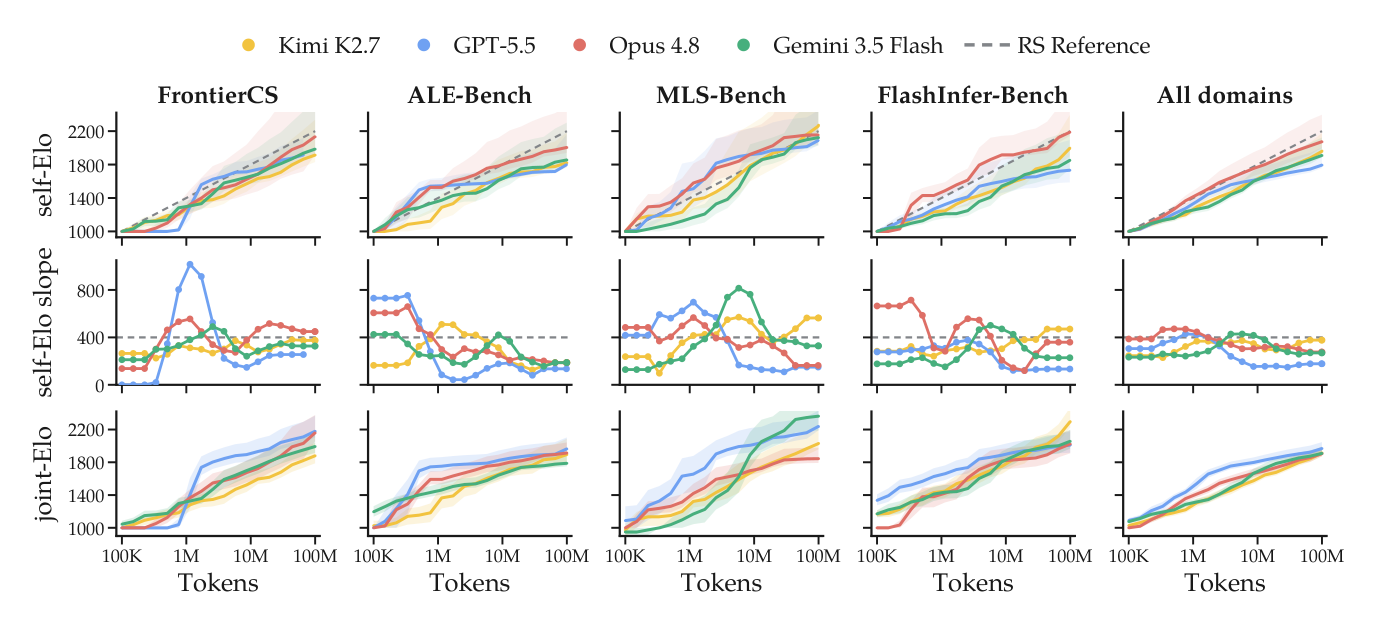
Figure 3 — 다양한 벤치마크에서의 에이전트 self-Elo scaling 패턴과 효율성을 분석한 그래프
## 4. Conclusion & Impact (결론 및 시사점) 본 연구는 에이전트의 테스트 타임 성능 확장이 독립적 샘플링의 효율을 넘어서지 못하는 한계를 지적하며, 에이전트가 솔루션 탐색 과정에서 특정 basin에 고착화되는 Sticky-basin 현상을 확인했습니다. 이는 향후 에이전트 시스템이 긴 시간 동안 성능을 개선하기 위해서는 단순히 토큰을 늘리는 것이 아니라, 더 나은 basin으로 탈출하거나 재탐색할 수 있는 아키텍처 설계가 필수적임을 시사합니다. 제안된 Elo-per-token 프레임워크와 인플렉션 포인트 기반의 예산 할당 방식은 향후 AI 에이전트의 테스트 타임 자원 최적화 및 평가를 위한 표준적인 방법론으로 활용될 것으로 기대됩니다.
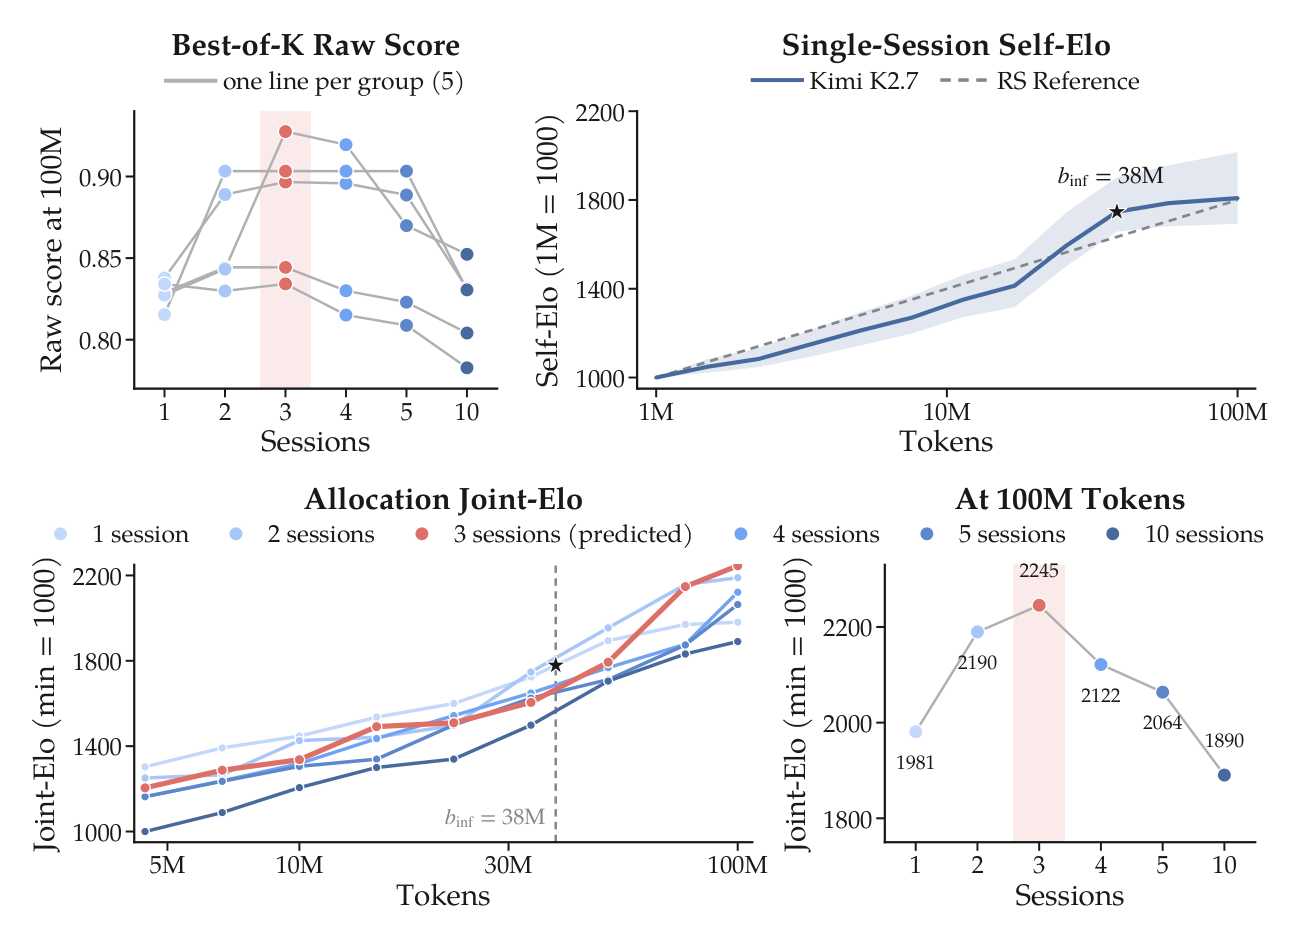
Figure 8 — 인플렉션 포인트를 활용한 컴퓨팅 예산 할당 최적화 전략의 효과를 입증한 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ContinualSkillBench: Can LLM Agents Truly Evolve Their Capabilities?
- [논문리뷰] SkillRise: Agentic Reinforcement Learning for Cross-Task Skill Evolution
- [논문리뷰] REVERE: Reflective Evolving Research Engineer for Scientific Workflows
- [논문리뷰] Deep Tabular Research via Continual Experience-Driven Execution
- [논문리뷰] Memento-Skills: Let Agents Design Agents
Review 의 다른글
- 이전글 [논문리뷰] Vidu S2: Real-Time Interactive, Editable, and Spatial Video Generation
- 현재글 : [논문리뷰] When Agents Slow Down: Understanding LLM Agents' Test-Time Strategies via Elo-per-token Analysis
- 다음글 [논문리뷰] ZGCM-1: A Fully Open and Extremely Efficient Foundation Model for Math and Agentic Search
댓글