[논문리뷰] Vidu S2: Real-Time Interactive, Editable, and Spatial Video Generation
링크: 논문 PDF로 바로 열기
저자: Jintao Zhang, Kai Jiang, Jintao Chen, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Vidu S2: 실시간 상호작용, 편집, 공간 비디오 생성을 위한 포괄적인 시스템으로, Vidu S2-Avatar와 Vidu S2-Editing 모델로 구성된다.
- Vidu S2-Avatar: 실시간 상호작용이 가능한 디지털 캐릭터 생성 모델로, 720p 해상도, 동적 Reference 업데이트, 그리고 강력한 Instruction Following을 지원한다.
- Vidu S2-Editing: 실시간 비디오 스트림을 편집하는 모델로, Style Transfer, Virtual Try-on, Character Replacement, Background Replacement 등의 기능을 제공한다.
- Self-Replay Forcing (SRF): 오토회귀적 롤아웃(autoregressive rollout) 분포를 Teacher 분포와 정렬시키면서 Cross-block Gradient Flow를 유지하는 On-policy 동적 증류 학습(Dynamic Distillation) 방법론이다.
- Spatial Video: 시청자에게 깊이, 스케일, 객체의 위치를 인식하게 하여 더욱 강력한 Presence감을 제공하는 좌우 Eye View가 동기화된 비디오를 의미한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존의 비디오 생성 모델들, 예를 들어 Sora와 같은 모델들은 고품질 비디오를 생성하지만 대부분 Offline, One-shot Generation 패러다임을 따른다. 이는 사용자가 프롬프트를 입력하고 수 분에서 수십 분을 기다려야 전체 비디오를 받을 수 있으며, 이 과정에서 사용자는 적극적인 상호작용 없이 수동적으로 기다려야 하는 한계를 가진다. 이러한 제한점은 모델이 전체 비디오를 Diffusion 패러다임에 따라 동기적으로 Denoising하여 전체 Clean Video를 최종 단계에서 생성하는 방식에서 기인한다.
이러한 배경에서 저자들은 실시간 상호작용 비디오 콘텐츠에 대한 상당한 수요가 존재하며, 기존 Vidu S1의 한계점들을 극복해야 할 필요성을 제기한다. Vidu S1은 540p 해상도, 고정된 Reference, 댄스와 같은 큰 몸동작에 대한 제한적인 Instruction Following, 그리고 스트리밍 비디오 편집 미지원 등의 문제점을 가지고 있었다. 따라서 본 연구의 핵심 문제는 고품질의 실시간 상호작용 및 편집 가능한 비디오를 생성하고, 더 나아가 Spatial Video 형태로 제공함으로써 기존의 Offline, Passive한 경험을 넘어 몰입감 있는 인터랙티브 시각 경험을 제공하는 것이다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 실시간 인터랙티브, 편집 가능, 그리고 공간 비디오 생성을 위한 Vidu S2를 제안한다. Vidu S2는 크게 두 가지 핵심 모델인 Vidu S2-Avatar와 Vidu S2-Editing으로 구성되며, 이들을 효율적인 Inference Infrastructure와 Agentic System을 통해 구현한다 [Figure 1].
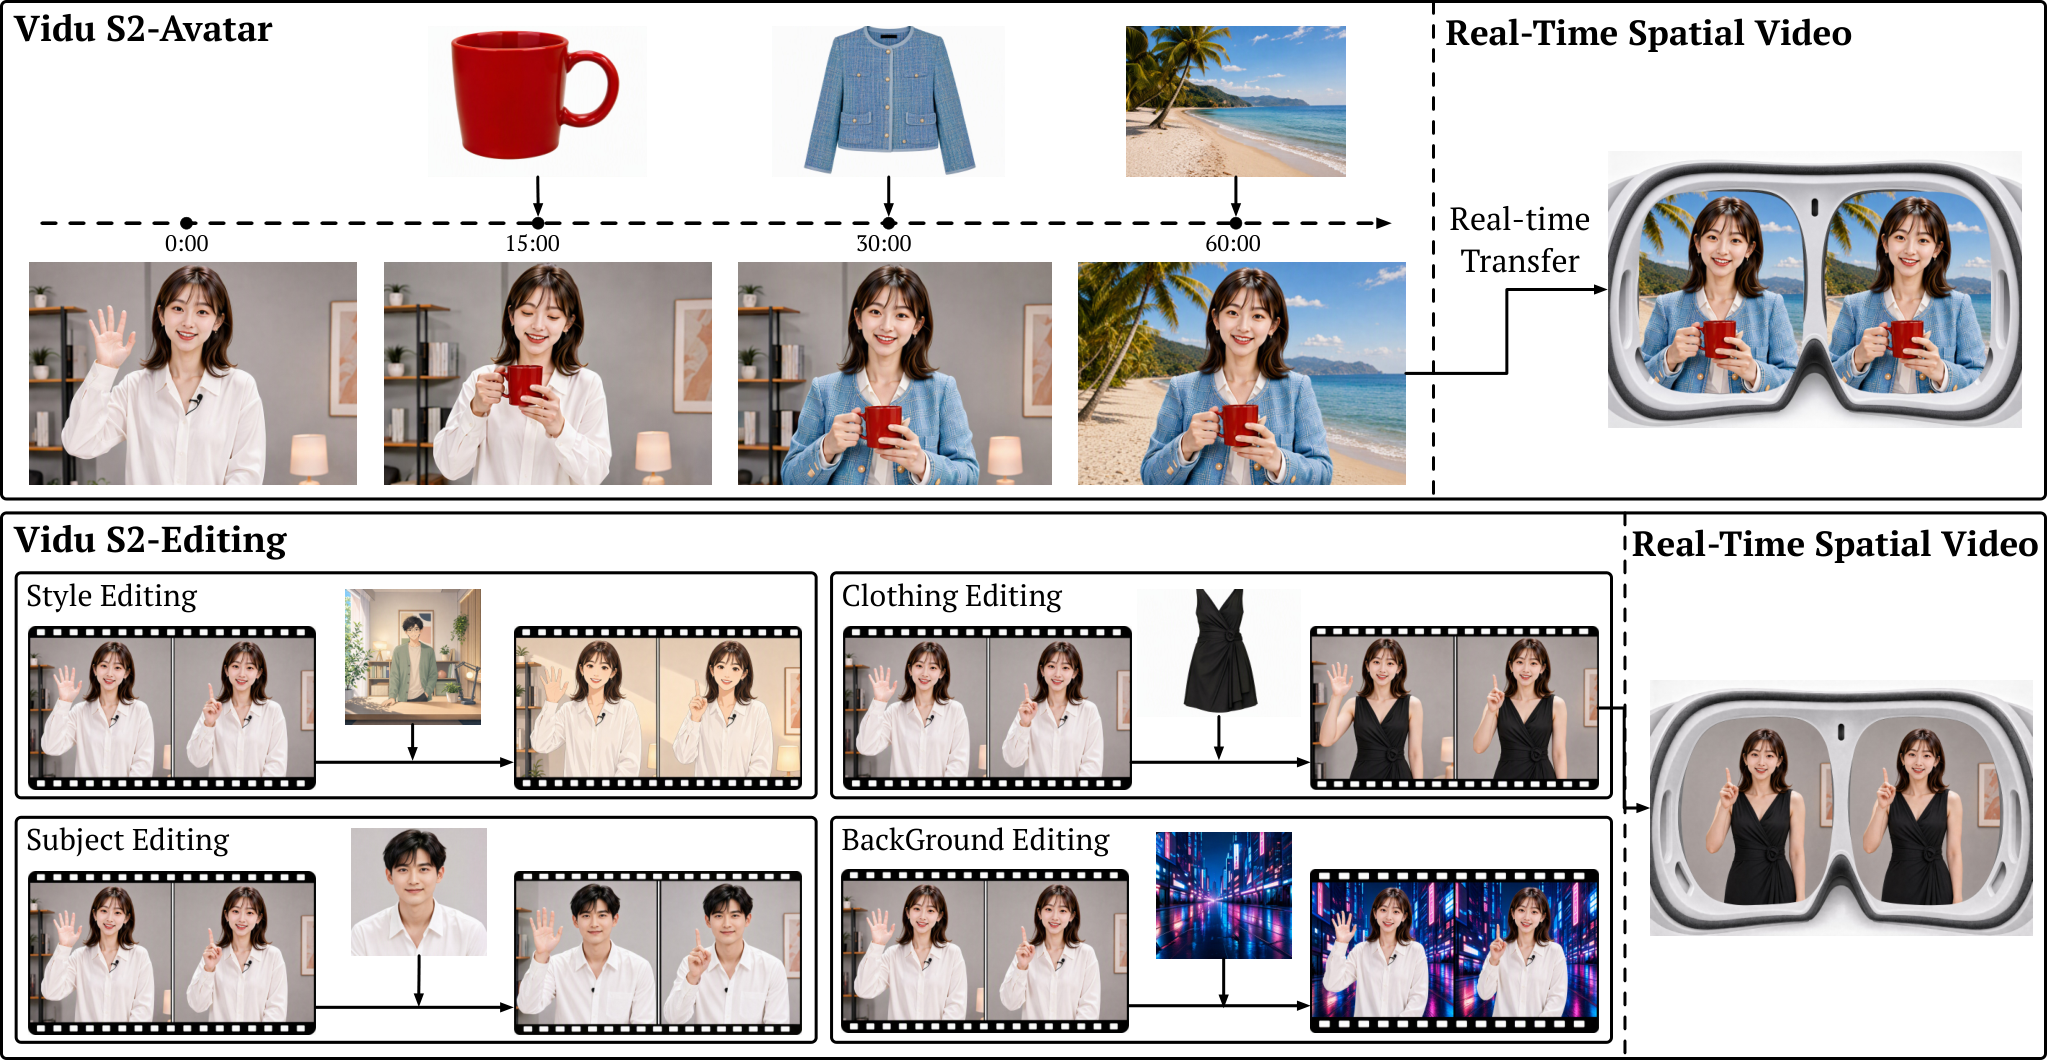
Figure 1 — Vidu S2 시스템 개요
Vidu S2-Avatar는 오디오-비주얼 Joint Diffusion Transformer를 활용하여 Reference-conditioned Video-Audio Generation을 수행한다. 이 모델은 Self-Replay Forcing (SRF)를 도입하여 오토회귀적 롤아웃(autoregressive rollout) 후 학생 모델이 생성한 전체 Trajectory를 독립적으로 Re-noise하고, Gradient가 활성화된 단일 Causal Pass로 Replay함으로써 데이터 효율성과 훈련 품질을 향상시킨다. 또한, 540p에서 720p 해상도로 실시간 생성을 확장하기 위해 경량의 Super-Resolution Refiner를 추가하며, 명목상 해상도 대신 측정된 Clarity를 기준으로 훈련 비디오를 선택하여 품질을 보장한다. 더 강력한 Instruction Following을 위해 솔로 댄스 비디오와 2D/3D 애니메이션 데이터를 추가하고, 배경 안정화(Background Stabilization) 기법을 적용하며, Human Preference로부터의 Reinforcement Learning을 통해 동작의 자연스러움, 표현력, Instruction Adherence를 개선한다. 사용자가 스트림 도중 언제든지 새로운 Reference Image를 제공할 수 있도록 VLM Agentic System을 구축하여 Prompt Generation, Visual Feedback, Reference Image Handling을 지원한다 [Figure 3, Figure 4].
Vidu S2-Editing은 Diffusion Transformer (DiT)를 활용하여 Source Video와 선택적 Reference Image에 기반한 Instruction-guided Video Editing을 제공한다. 핵심 설계는 Frame-aligned Attention으로, 각 Target Frame이 동일한 시간 단계의 Source Frame만을 참조하여 편집된 비디오가 입력 비디오와 동일한 모션 및 타이밍을 유지하도록 한다. 또한, Vidu S2-Avatar와 동일한 Hybrid Forcing 및 Self-Replay Forcing 프레임워크를 따르는 Causal Streaming Training을 통해 실시간 스트리밍 비디오 편집 기능을 확보하며, Temporal Consistency와 Instruction Adherence를 향상시킨다.
실험 결과, Vidu S2-Avatar는 StreamAV-Bench의 모든 평가 지표에서 Baseline 모델들을 능가하는 성능을 보였다 [Table 1]. 특히 Visual Aesthetics (VA)에서 0.687, Visual Quality (VQ)에서 3.370, Audio-Visual Synchronization (AVSync)에서 0.617 (낮을수록 좋음), Subject Consistency (SC)에서 0.998, Background Consistency (BC)에서 0.993를 달성하여 시각적 품질, 오디오 품질, Cross-modal Coordination, Long-horizon Continuity 전반에서 균형 잡힌 우위를 입증했다. Vidu S2-Editing 또한 Sparkle-Bench에서 Overall Score 3.74를 기록하며 모든 Baseline 모델들을 상회했으며 [Table 2], OpenVE 및 RefVIE Joint Evaluation에서 Joint Overall Score 4.26으로 가장 강력한 Offline Baseline인 Bernini-R 14B를 0.34점 차이로 뛰어넘었다 [Table 3]. Unpaired Virtual Try-on 태스크의 ViViD Test Set에서는 VFID_I_ 값이 9.9515로, CatV^2^TON (19.5131) 대비 현저히 낮은 수치를 달성하며 생성된 비디오와 Reference 비디오 분포 간의 더 높은 정렬도를 보여주었다 [Table 4].
인간 선호도 평가(Human Preference Evaluation)에서도 Vidu S2는 일관된 우위를 보였다 [Figure 6, Figure 7]. Vidu S2-Avatar는 Overall Quality, Motion Quality, Expression Quality, Visual Quality, Consistency, Audio-Visual Synchronization, Semantic Adherence 등 모든 측면에서 Runway Character GWM-1, PixVerse Image Avatar, HeyGen과 같은 상업 시스템 대비 현저히 높은 선호도를 얻었다 [Figure 6]. 특히 Overall Quality에서 Runway 대비 85.7%, PixVerse 및 HeyGen 대비 100%의 선호도를 기록했다. 이러한 정량적 및 정성적 결과들은 Vidu S2가 실시간 인터랙티브 비디오 생성 및 편집 분야에서 Baseline 모델들을 크게 능가하며, 실제 사용 환경에서의 성능과 사용자 경험을 크게 향상시켰음을 보여준다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 실시간 인터랙티브 디지털 캐릭터 생성 모델인 Vidu S2-Avatar와 실시간 비디오 편집 모델인 Vidu S2-Editing을 포함하는 Vidu S2 시스템을 성공적으로 제안하며, 실시간 Spatial Video 생성의 가능성을 탐구한다. Vidu S2-Avatar는 Vidu S1 대비 720p 해상도 지원, 동적 Reference 업데이트, 그리고 댄스와 같은 복잡한 동작을 포함한 강력한 Instruction Following 능력을 제공한다. Vidu S2-Editing은 Style Transfer, Virtual Try-on, Character Replacement, Background Replacement 등 다양한 실시간 비디오 스트림 편집 기능을 지원한다. 종합적인 실험 결과는 Vidu S2가 모든 Baseline 모델들을 뛰어넘는 성능을 보이며 실시간 Inference 요구사항을 완벽하게 충족함을 입증한다.
이 연구는 실시간 비디오 생성 및 편집 기술의 최첨단 발전을 제시하며, 특히 효율적인 Inference 및 Serving Stack 구축을 통해 저비용 GPU에서도 이러한 고급 모델의 실용화를 가능하게 했다는 점에서 큰 의미를 가진다. 이는 Live Streaming, 화상 통신, 게임, 그리고 궁극적으로는 메타버스 환경에서 실시간으로 콘텐츠를 생성하고 조작하는 새로운 형태의 몰입형 인터랙티브 시각 경험을 제공할 수 있는 중요한 기반을 마련한다. 본 연구는 전통적인 3D 모델링, 재료 생성, 애니메이션, 장면 구축에 대한 의존도를 크게 줄일 수 있는 잠재력을 가지며, 학계 및 산업계 전반에 걸쳐 차세대 인터랙티브 비주얼 컴퓨팅 패러다임을 이끌어낼 것으로 기대된다.
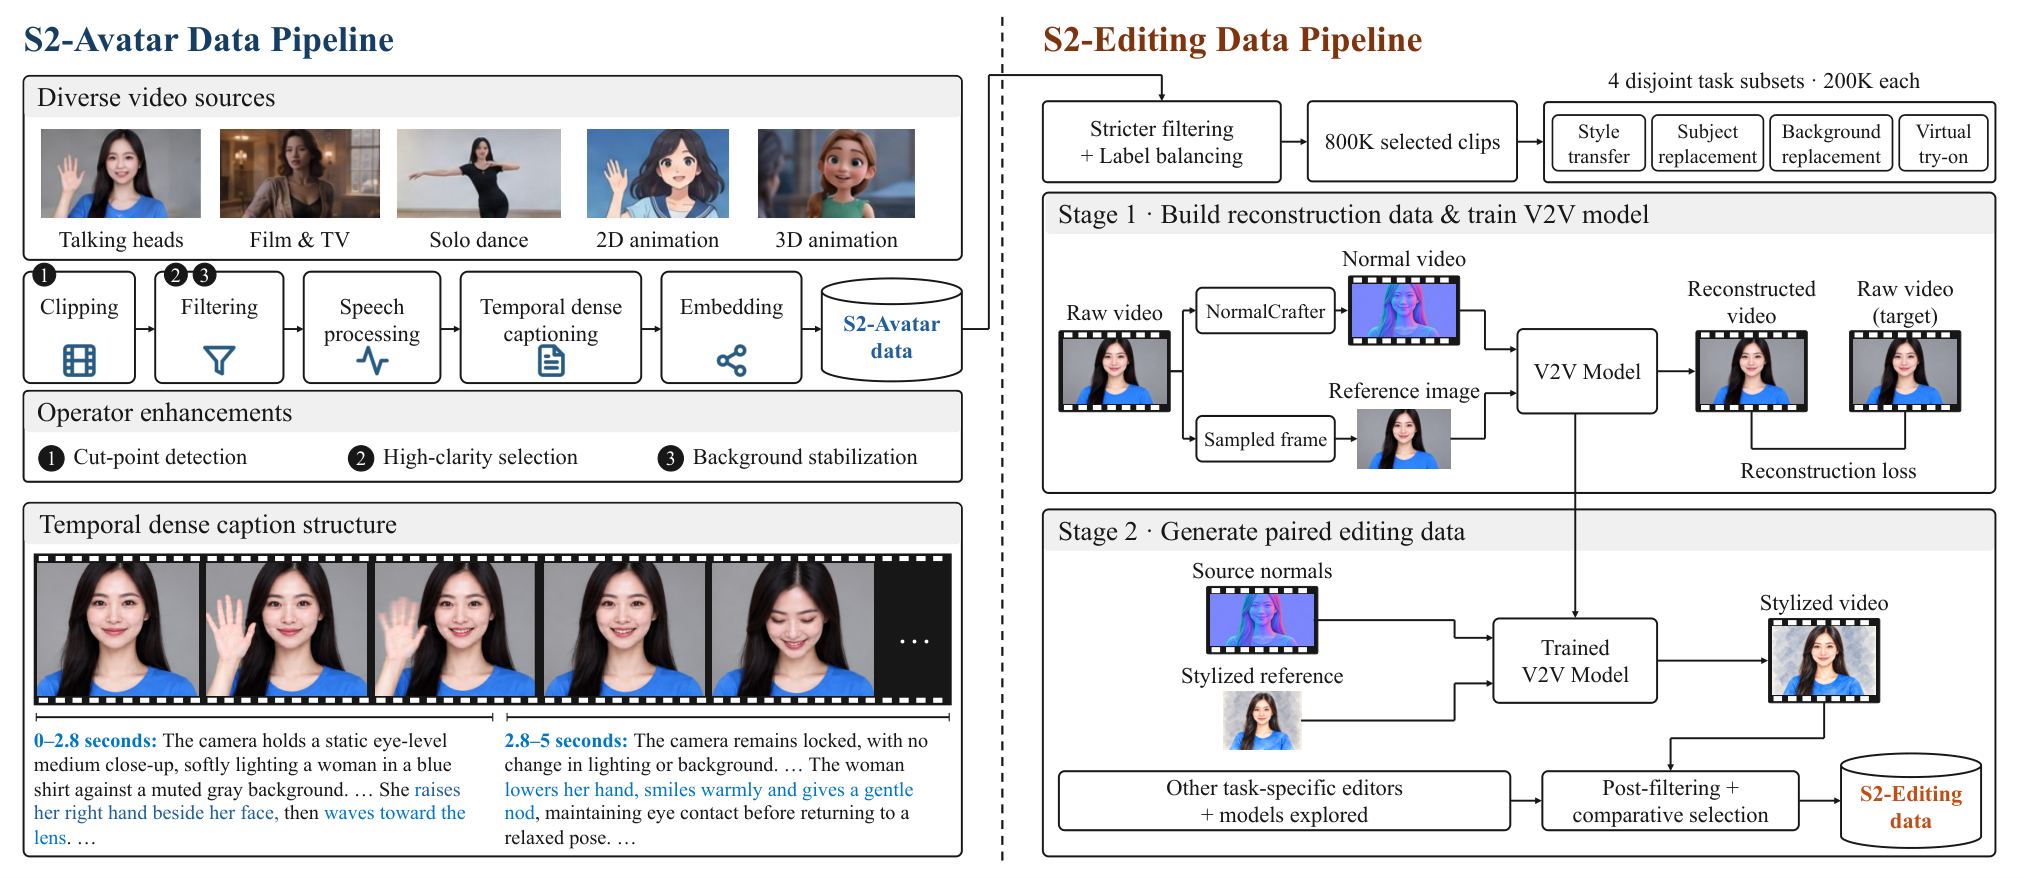
Figure 2 — 데이터 준비 파이프라인 개요
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] MIDAS: Multimodal Interactive Digital-human Synthesis via Real-time Autoregressive Video Generation
- [논문리뷰] NOVA: Sparse Control, Dense Synthesis for Pair-Free Video Editing
- [논문리뷰] Kiwi-Edit: Versatile Video Editing via Instruction and Reference Guidance
- [논문리뷰] End-to-End Video Character Replacement without Structural Guidance
- [논문리뷰] Region-Constraint In-Context Generation for Instructional Video Editing
Review 의 다른글
- 이전글 [논문리뷰] RSIAgent: Autonomous Exploration for Recursive Self-improvement in New Environments
- 현재글 : [논문리뷰] Vidu S2: Real-Time Interactive, Editable, and Spatial Video Generation
- 다음글 [논문리뷰] When Agents Slow Down: Understanding LLM Agents' Test-Time Strategies via Elo-per-token Analysis
댓글