[논문리뷰] RSIAgent: Autonomous Exploration for Recursive Self-improvement in New Environments
링크: 논문 PDF로 바로 열기
저자: Sibo Zhu, Shicheng Fan, Xinyue Wang, Wenyi Wu, Kun Zhou, Biwei Huang
1. Key Terms & Definitions (핵심 용어 및 정의)
- RSIAgent: 새로운 환경에서 자율적인 Memory 구축을 통한 Recursive Self-Improvement를 위한 training-free multi-agent framework를 지칭합니다.
- Recursive Self-Improvement (RSI): Agents가 model parameters를 업데이트하지 않고도 환경별 Knowledge를 자율적으로 습득, 검증, 통합하여 재사용 가능한 Memory를 구축하는 과정을 의미합니다.
- Multi-Agent Harness Framework: Curriculum Agent, Actor Agent, Verifier Agent로 구성되어, 지속적인 환경 Exploration, Outcome 검증, 환경 특화 Knowledge retention을 조율하는 프레임워크입니다.
- Broad Recursive Self-exploration (BRS): 새로운 환경에 대한 광범위한 이해를 신속하게 구축하기 위해 다양한 Interaction experience를 병렬적으로 수집하는 2단계 Exploration 전략 중 첫 번째 단계입니다.
- Deep Recursive Self-exploration (DRS): 누적된 Memory를 정교화하기 위해 중요한 Knowledge gap, hard cases, boundary conditions에 집중하여 순차적으로 탐색하는 2단계 Exploration 전략 중 두 번째 단계입니다.
- Evolvable Memory: 환경 특화 Knowledge, 재사용 가능한 Procedures 및 Scripts, 이전 실행에서 얻은 Lessons learned를 저장하는 지속적인 Memory로, 검증된 Outcome에 기반하여 업데이트되고 정제됩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Digital Agent 시스템이 pretrained model에 의해 완전히 포착되지 않는 새로운 환경의 Interface, Tools, Failure modes에 적응해야 하는 문제를 해결하고자 합니다. 기존 Adaptation 접근 방식은 추가 Interaction data 수집 및 Training에 의존하며, 이는 상당한 비용을 초래하고 Private 또는 지속적으로 변화하는 환경에서는 적용하기 어렵습니다. 단순히 성공적인 Trajectory를 Memory에 저장하는 것을 넘어, Agents가 Actions, Environment conditions, Outcomes 간의 안정적인 Causal relationships를 발견하고 이를 재사용 가능한 Causal structures로 조직하는 것이 중요합니다. 따라서 본 연구의 핵심 문제는 Agent가 새로운 환경에서 재사용 가능한 Memory로 Self-improvement를 위해 Causal relations를 자율적으로 발견할 수 있는 효율적인 Exploration strategy를 설계하는 것입니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Agents가 새로운 환경에 자율적으로 탐색하고 적응할 수 있도록 Recursive Self-Improvement 프레임워크인 RSIAgent를 제안합니다. RSIAgent는 Actor Agent (Evolvable Memory로 Action을 실행하고 Memory를 업데이트), Verifier Agent (Environment Feedback을 통해 Outcome을 독립적으로 검증), Curriculum Agent (Practice tasks를 생성하여 Exploration을 안내)로 구성된 Multi-agent Harness Framework를 활용합니다. 이 프레임워크는 Broad Recursive Self-exploration (BRS)과 Deep Recursive Self-exploration (DRS)이라는 두 단계의 자율 탐색 전략을 채택하여, 먼저 다양한 환경 지식을 구축한 다음 어려운 사례, 숨겨진 제약 조건, 경계 조건에 대한 지식을 정제합니다 [Figure 2]. Exploration이 완료되면, 축적된 Memory는 Frozen되어 Model parameters를 업데이트하지 않고 Downstream tasks에 직접 재사용됩니다.
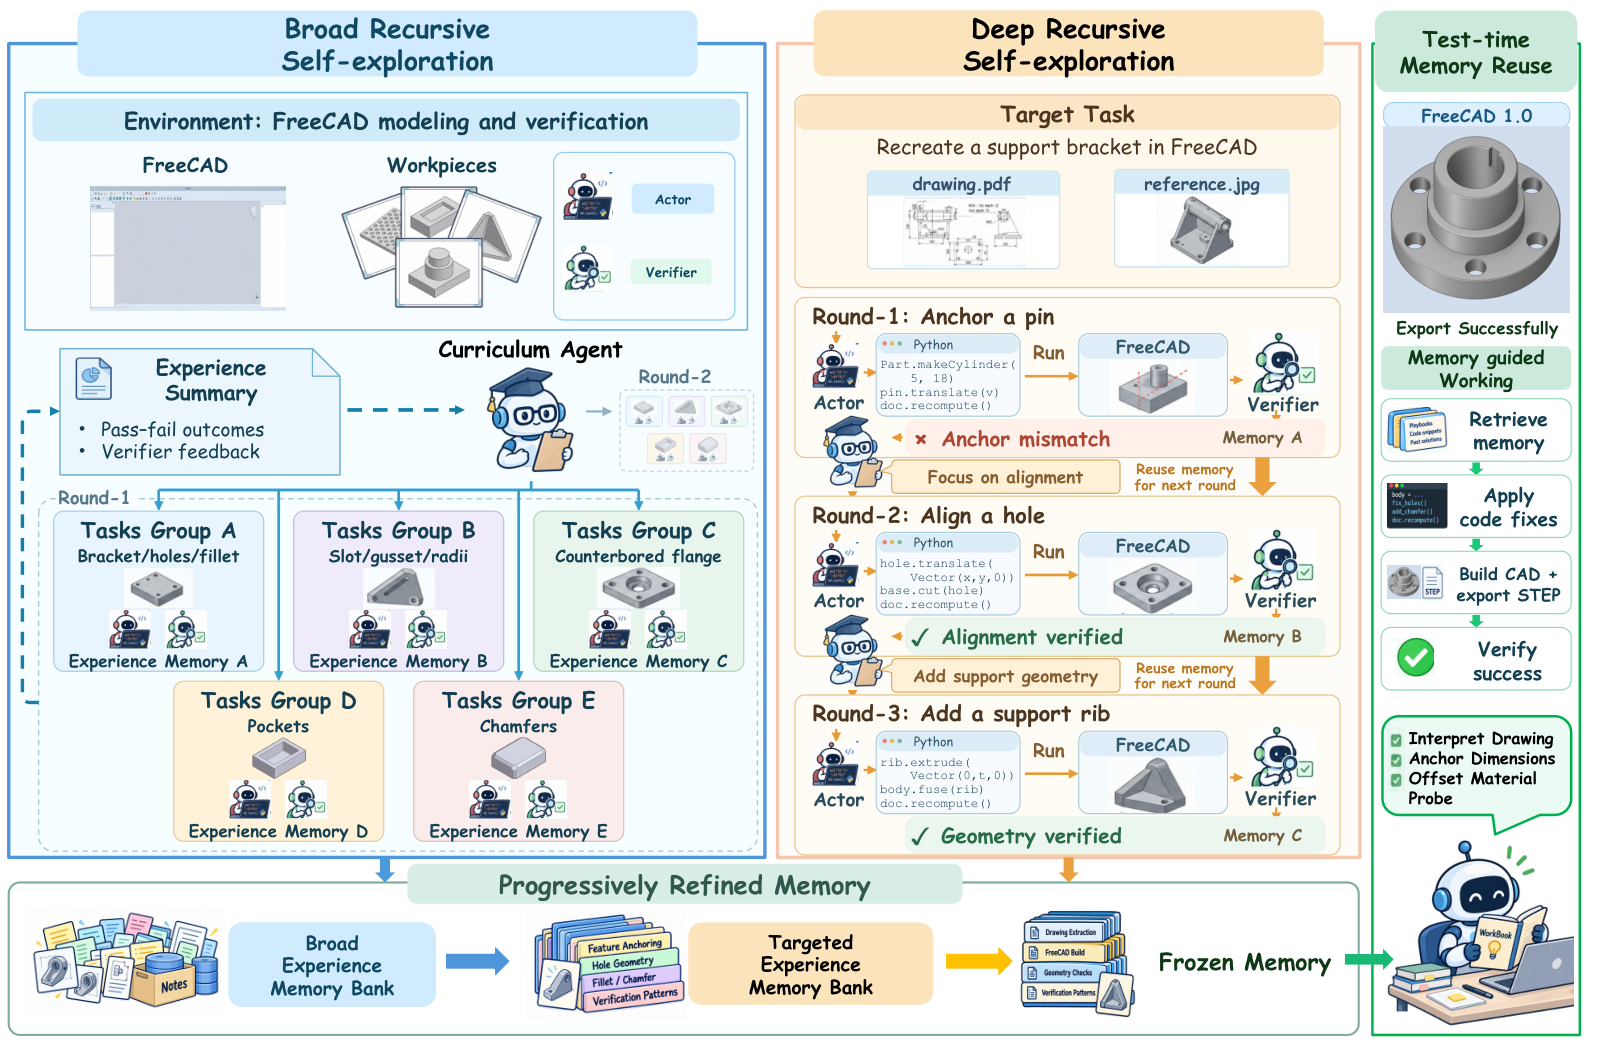
Figure 2 — RSIAgent의 Multi-agent 프레임워크 및 탐색 전략
실험 결과, RSIAgent는 OSWorld 2.0 (0808 offline) 및 Agent’s Last Exam (ALE) Near-term 벤치마크에서 기존 Open-source models의 성능을 크게 향상시켰습니다. OSWorld 2.0에서 Partial score는 71.97%에서 78.98%로, Binary accuracy는 37.80%에서 42.68%로 증가했습니다. ALE에서는 Partial score가 83.75%에서 84.82%로, Binary accuracy는 49.25%에서 50.75%로 향상되었습니다. 특히, RSIAgent는 Kimi-K3 및 GLM-5.3과 같은 Open-source models이 GPT-6 Astra (OSWorld 2.0 Partial score에서 6.38%, ALE Partial score에서 2.56% 우위) 및 Claude Opus 5와 같은 Frontier closed-source models을 능가하도록 지원했습니다 [Table 1, Figure 1]. Ablation study는 BRS와 DRS를 결합할 때 네 가지 OSWorld 2.0 Task에서 평균 74.54%의 가장 높은 Partial score를 달성하여, BRS-only (65.52%) 또는 DRS-only (56.50%)보다 우수함을 입증했습니다 [Figure 4].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 새로운 디지털 환경에서 Recursive Self-improvement를 위한 training-free Multi-agent framework인 RSIAgent를 성공적으로 도입했습니다. Curriculum, Actor, Verifier Agents의 협업과 Broad-then-deep Exploration 전략을 통해, RSIAgent는 환경 특화 Knowledge를 자율적으로 습득, 검증, 통합하여 재사용 가능한 Memory를 구축합니다. 이 연구는 강력한 Open-source models이 RSIAgent를 통해 Frontier closed-source models의 성능을 뛰어넘을 수 있음을 OSWorld-v2 및 Agent’s Last Exam 벤치마크에서 입증하였습니다. 이러한 결과는 Model parameters를 업데이트하지 않고도 효과적인 Agent-level self-improvement가 Open-source 및 Closed-source foundation models 간의 Capability gap을 크게 줄이거나 역전시킬 수 있음을 시사하며, 이는 향후 AI 시스템의 자율 학습 및 적응 능력 발전에 중요한 영향을 미칠 것입니다.
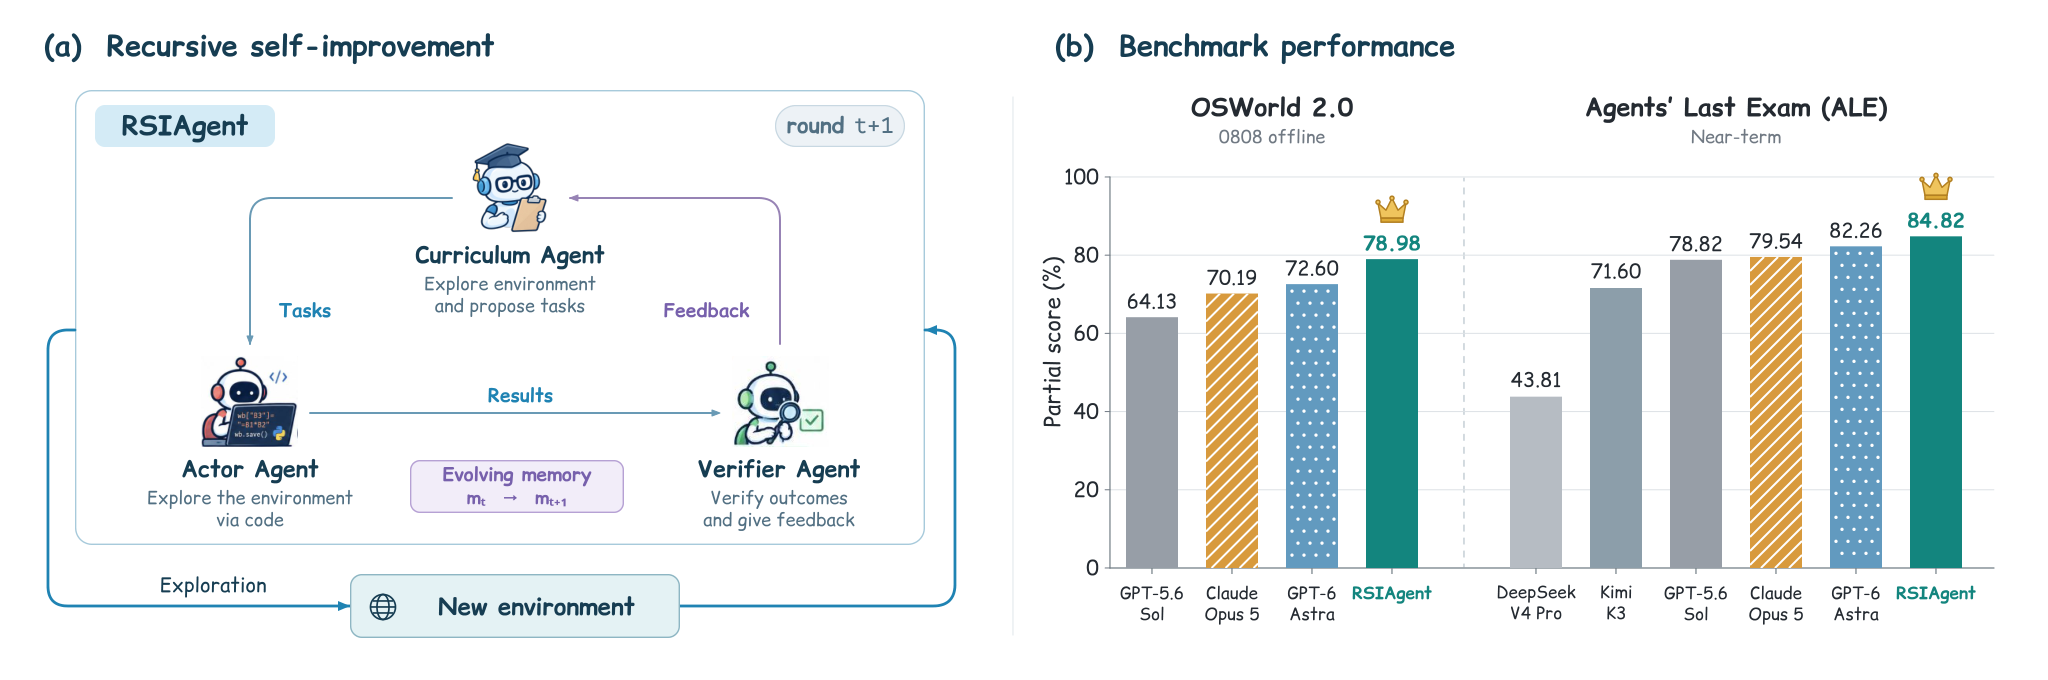
Figure 1 — RSIAgent의 개요 및 주요 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Recursive self-improvement of AI research agents
- [논문리뷰] SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness
- [논문리뷰] The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement
- [논문리뷰] Dream-RSI: Recursive Self-Improvement through Evolving Worlds
- [논문리뷰] Atria Dawn: The Dawn of Agentic Superintelligence
Review 의 다른글
- 이전글 [논문리뷰] Pick Your Poison: Learning to Select Poison Sets for Stronger LLM Backdoor Attacks
- 현재글 : [논문리뷰] RSIAgent: Autonomous Exploration for Recursive Self-improvement in New Environments
- 다음글 [논문리뷰] Vidu S2: Real-Time Interactive, Editable, and Spatial Video Generation
댓글