[논문리뷰] Dream-RSI: Recursive Self-Improvement through Evolving Worlds
링크: 논문 PDF로 바로 열기
저자: Tong Zheng, Xidong Wu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Recursive Self-Improvement (RSI): AI 에이전트가 후보 솔루션을 생성, 평가, 피드백 통합, 정제를 반복하는 순환적 발견(discovery) 루프를 통해 자체 역량을 지속적으로 향상시키는 목표를 지칭합니다.
- Exploration Policy: 에이전트가 복잡한 검색 공간에서 솔루션을 찾는 방식을 결정하는 전략으로, 브랜칭(branching), 병렬 탐색(parallel exploration), 탐색 중단(stopping) 등의 결정을 포함합니다.
- Discovery Tree: 과거의 모든 탐색 결정과 그에 따른 코드 실행 결과(execution outcomes)를 구조화하여 기록한 이력을 의미하며, 각 노드는 특정 시점의 시도와 관찰 결과를 나타냅니다.
- Replay Simulator (Worlds): 누적된
discovery history를 활용하여 새로운exploration policy의 성능을 저비용으로 신속하게 평가할 수 있도록 재구성된 시뮬레이션 환경입니다. - Dreaming:
replay simulator내에서 다양한 후보exploration policy들을 시뮬레이션하여, 실제 온라인 환경에서 비용이 많이 드는 실행 없이 즉각적이고 저렴한 피드백을 얻는 과정을 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 자율 AI 에이전트가 복잡한 도메인에서 고가치 솔루션을 발견하기 위한 recursive self-improvement (RSI) 과정에서 exploration strategy를 관리하고 개선하는 데 따르는 근본적인 병목 현상을 해결하고자 합니다. 기존 시스템들은 검색 공간이 확장됨에 따라 고정된 exploration strategy가 적응하지 못하는 문제에 직면합니다. 반면, online policy optimization은 long-horizon rollout에 걸쳐 지연되고 비용이 많이 드는 피드백으로 인해 광대한 meta-search space를 탐색해야 하는 어려움이 있습니다. 이러한 한계점은 과거의 discovery experience로부터 학습하여 exploration을 개선할 수 없게 만들고, 결과적으로 컴퓨팅 자원의 비효율적인 할당을 초래합니다. meta-level에서 exploration policy의 평가는 많은 proposal-evaluation cycle에 걸친 discovery process 전체를 관찰해야 하므로 비용과 시간이 많이 소요됩니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 이러한 병목 현상을 해결하기 위해 Dream-RSI 프레임워크를 제안합니다. Dream-RSI는 exploration을 명시적이고 프로그래밍 가능하게 만드는 경량의 orchestration layer를 도입하여, 기존 코딩 에이전트는 변경하지 않고 exploration policy만을 제어합니다. 핵심 아이디어는 누적된 discovery history를 replay simulator로 활용하는 것입니다. 이 replay simulator는 과거의 discovery tree를 기반으로 구축되며, 이를 통해 dreaming 과정을 수행하여 다양한 후보 exploration policy를 즉각적이고 저렴한 비용으로 평가할 수 있습니다. 개선된 policy는 이후 온라인에 재배포되어 추가적인 discovery를 추진하고 simulator pool을 지속적으로 확장하는 self-improving loop를 형성합니다. replay objective는 discovery quality, execution cost, parallelism의 균형을 맞춥니다.
주요 실험 결과는 다음과 같습니다:
- Algorithm Engineering (Lasso path solver):
Dream-RSI는 Gemini-3.1 Pro 백본에서 Recursive Fixed Exploration 대비 평균runtime을 3587.1 ms에서 2931.0 ms로 줄였으며,discovery-agent calls는 550회에서 317회로 대폭 감소시켰습니다. Gemini-3.7-Flash에서도 평균runtime을 2516.7 ms에서 2350.6 ms로 단축하며discovery-agent calls를 3200회에서 1879회로 줄였습니다. 또한, 51,200회의generation을 사용한 SimpleTES에 비해 두 자릿수 적은discovery-agent calls로 더 낮은downstream runtime을 달성했습니다. [Figure 3] - Mathematics Optimization:
Sum–Difference문제에서 1.145427의score를 달성하여 SimpleTES를 능가했습니다.Circle Packing에서는 2.635983으로 기존의 강력한 방법론들과 동등한 최고score를 기록했습니다.Autocorrelation에서는 1.456375로 경쟁력 있는 성능을 보였습니다. [Table 1] - GPU Kernel Engineering: VGG16 및 LayerNorm 태스크에서
Dream-RSI는 각각 2.43배 및 1.79배 적은generation으로 비교 가능한 최종 성능에 도달했습니다.ConvDiv및ConvMax태스크에서는 유사한discovery budget하에 각각 2.09배 및 1.44배 더 높은 성능을 달성했습니다. [Figure 4]
4. Conclusion & Impact (결론 및 시사점)
본 논문은 recursive self-improvement 과정에서 exploration의 효과를 증진시키는 Dream-RSI 프레임워크를 제시합니다. Dream-RSI는 축적된 discovery history를 정적인 context가 아닌 능동적이고 replay 가능한 simulator로 변환함으로써, long-horizon discovery setting에서 meta-optimization의 핵심 병목인 지연되고 값비싼 피드백 문제를 효과적으로 해결합니다. historical discovery tree로 구축된 replay simulator 내에서 dreaming을 통해 후보 exploration policy를 신속하고 무시할 만한 execution cost로 평가할 수 있게 됩니다. 개선된 policy는 다시 온라인에 배포되어 추가적인 discovery를 유도하고 simulator pool을 확장하며 recursive self-improvement loop를 완성합니다.
이 연구는 algorithm engineering, mathematical optimization, GPU kernel engineering과 같은 다양한 과학적 발견 도메인에서 discovery quality를 유지하거나 향상시키면서 discovery cost를 크게 절감하는 scalable하고 효율적인 방법을 제시합니다. 이는 자율 AI 시스템의 meta-level exploration strategy 최적화에 새로운 패러다임을 제공하며, long-horizon discovery의 효율성과 확장성을 크게 개선할 수 있는 중요한 시사점을 가집니다.
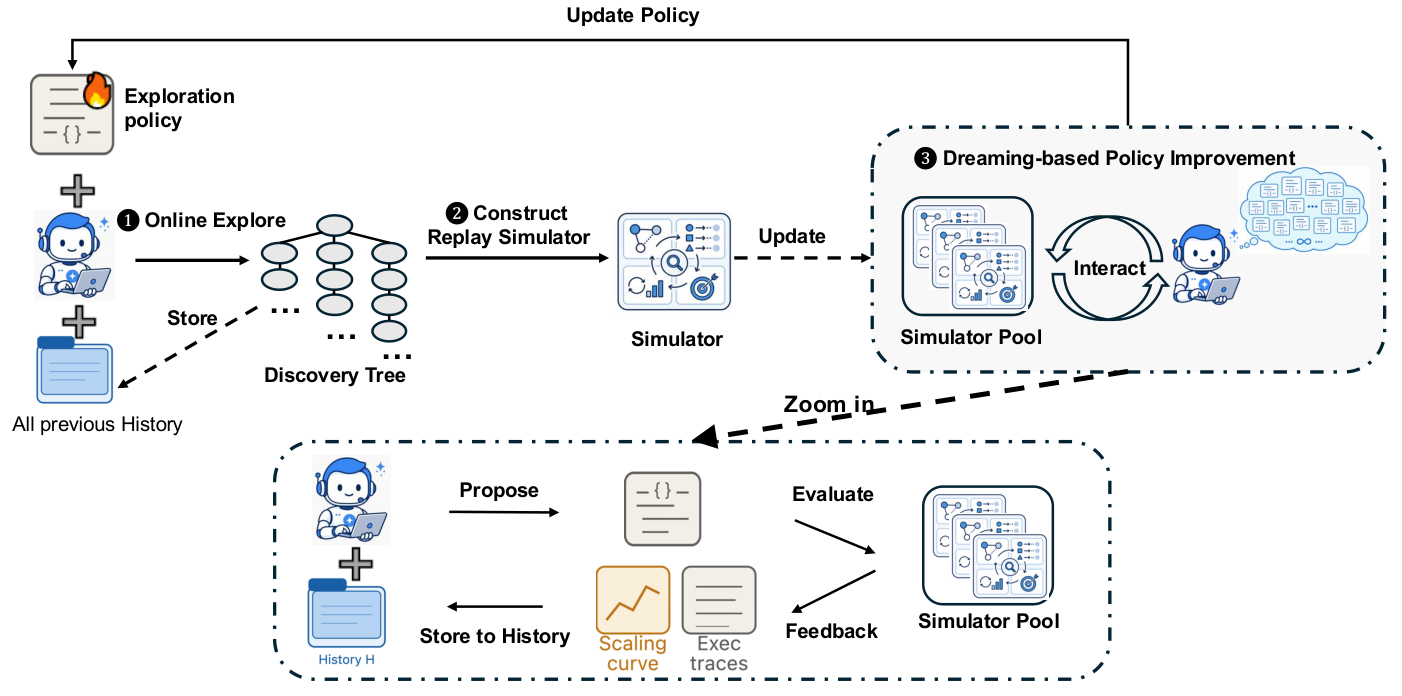
Figure 1 — Dream-RSI 개요
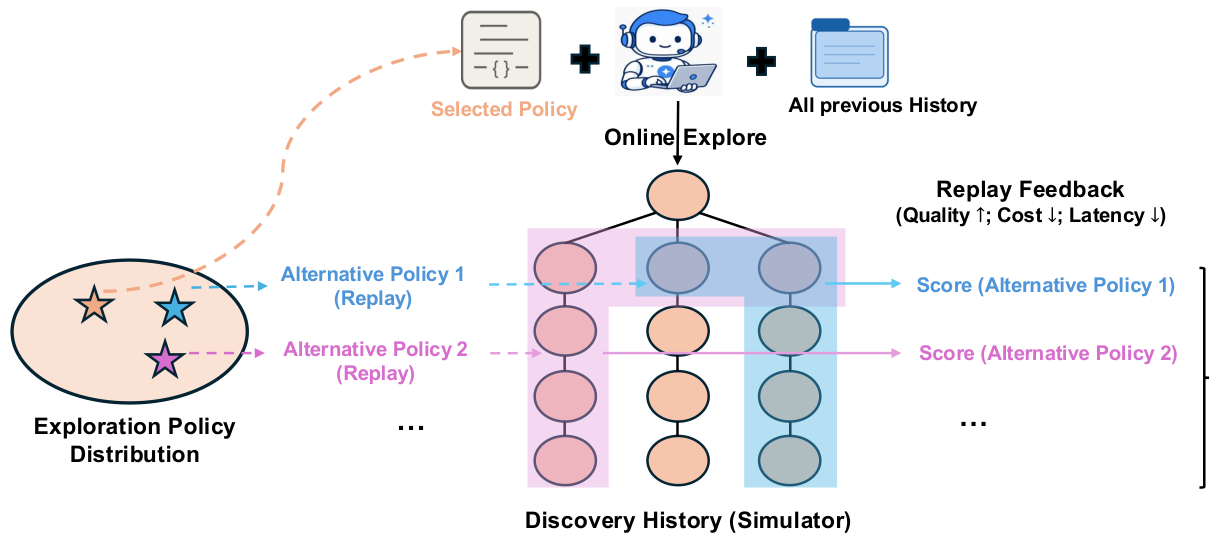
Figure 2 — 발견 이력 시뮬레이터
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Recursive self-improvement of AI research agents
- [논문리뷰] SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness
- [논문리뷰] The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement
- [논문리뷰] RSIAgent: Autonomous Exploration for Recursive Self-improvement in New Environments
- [논문리뷰] Atria Dawn: The Dawn of Agentic Superintelligence
Review 의 다른글
- 이전글 [논문리뷰] Discovery Foundation Models: Toward Open-Ended Discovery Intelligence
- 현재글 : [논문리뷰] Dream-RSI: Recursive Self-Improvement through Evolving Worlds
- 다음글 [논문리뷰] Expert-Space Exploration in MoE Reinforcement Learning
댓글