[논문리뷰] Expert-Space Exploration in MoE Reinforcement Learning
링크: 논문 PDF로 바로 열기
저자: Hongyi He, Zhenghao Lin, Xiao Liu, Peng Cheng, Yan Lu, Yeyun Gong, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- ESRL (Expert-Space Exploration Reinforcement Learning): MoE 모델의 expert routing 공간을 명시적으로 탐색하여 rollout 다양성을 확보하는 아키텍처 인지형 프레임워크입니다.
- Anchored Expert Sampling: 고신뢰도 expert는 유지(anchor)하면서, 나머지 슬롯에 대해서만 확률적으로 expert를 선택하여 품질 저하를 방지하는 기법입니다.
- Rollout Routing Replay (R3): Rollout 과정에서 사용된 특정 expert 경로를 기록하여, policy 최적화 시 동일한 경로를 강제로 활성화함으로써 학습과 추론 간의 불일치를 해소하는 기술입니다.
- Pass@1 / Pass@8: 모델의 추론 성능을 평가하는 정량적 지표로, 생성된 32개의 샘플 중 최소 1개(또는 8개)가 정답을 포함할 확률을 의미합니다.
- GRPO (Group Relative Policy Optimization): 가치 모델(value model) 없이 그룹 내 상대적 이점을 활용하여 정책을 최적화하는 LLM 학습 방식입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 기존의 LLM post-training 연구가 token-level의 sampling에만 집중하고, MoE 모델의 핵심인 expert routing의 다양성 활용에는 소홀했다는 점을 지적하며 ESRL을 제안합니다. MoE 모델은 token-dependent하게 sparse한 expert 경로를 선택하는데, 기존 방식은 determinisitc한 top-K routing을 사용하여 동일한 입력에 대해 항상 같은 expert만 활성화하는 고질적인 문제를 안고 있습니다. 이러한 구조적 결정론은 RL 학습 과정에서 탐색 범위를 심각하게 제한하며, 결과적으로 충분한 reward 다양성을 확보하지 못해 학습 신호가 약화되는 현상을 초래합니다. 기존의 무분별한 routing noise 주입 방식은 부적절한 expert를 활성화하여 생성 품질을 크게 떨어뜨리는 한계가 있으며, 이를 개선하기 위해 routing-level의 통제된 탐색 기법이 필수적입니다. [Figure 1]은 이러한 routing-level 탐색이 어떻게 더 나은 출력 생성을 유도하는지 잘 보여줍니다.
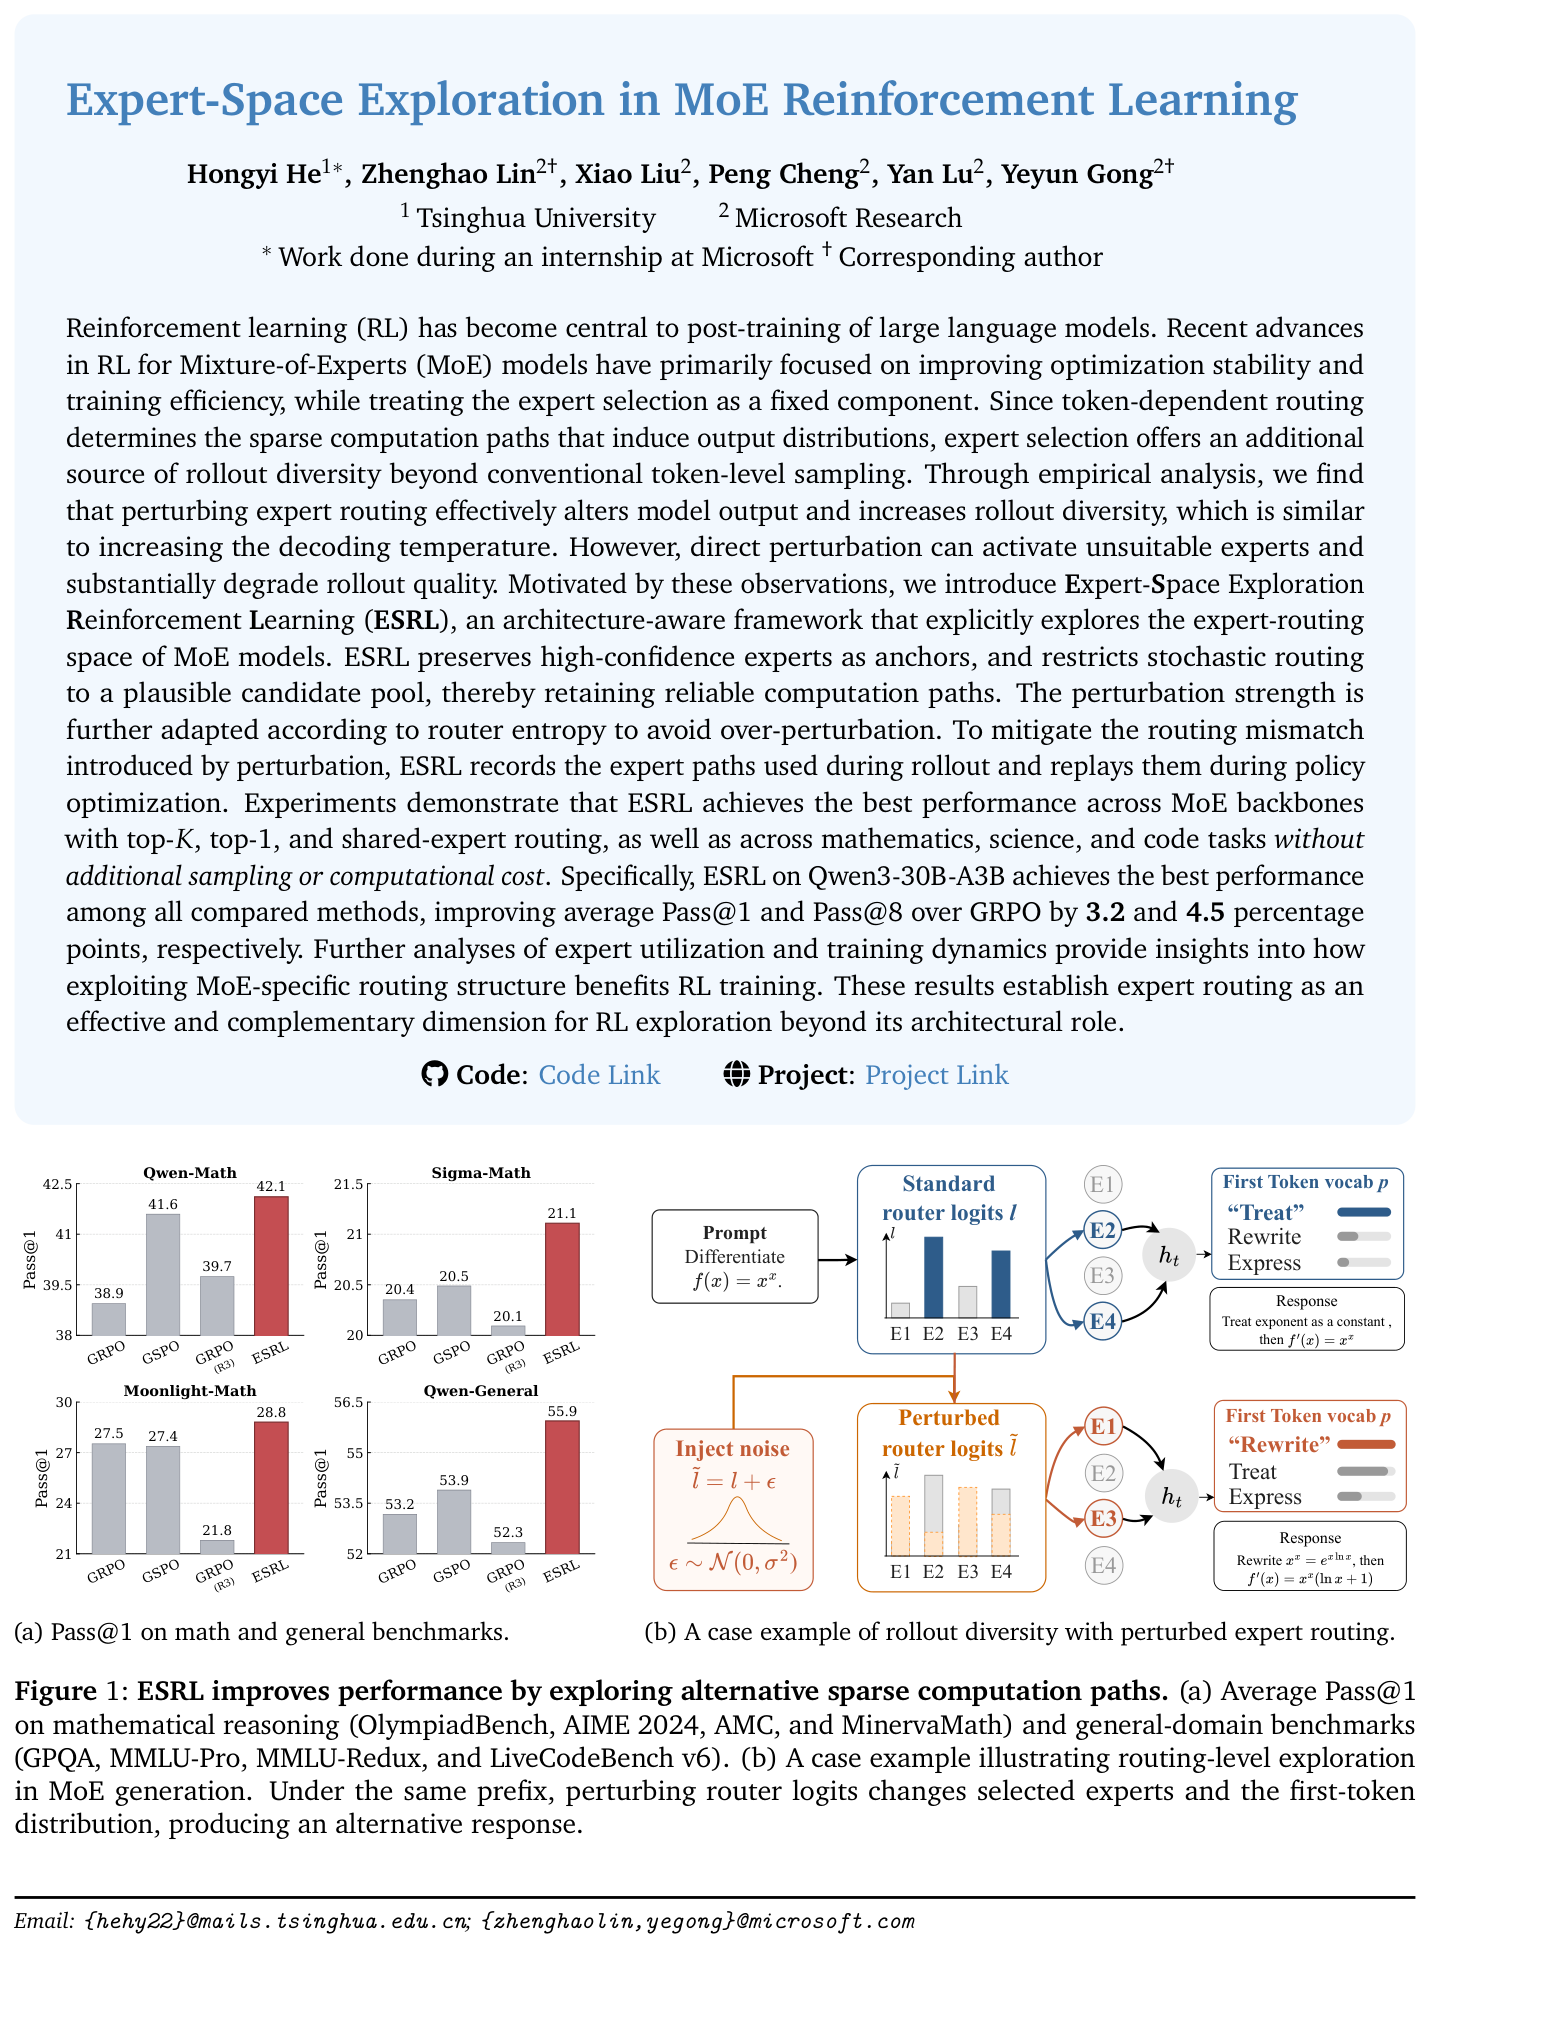
Figure 1 — ESRL의 전체적인 컨셉과 expert perturbation을 통한 다양성 확보 방식을 보여주는 핵심 그림
## 3. Method & Key Results (제안 방법론 및 핵심 결과) ESRL은 router의 entropy를 기반으로 perturbation 강도를 적응적으로 조절하고, anchored expert sampling과 routing replay를 결합하여 안정적이고 효과적인 탐색을 수행합니다. 구체적으로는 고신뢰도 expert를 보호하면서 exploratory candidate pool 내에서만 노이즈를 주입하여, 생성 품질을 유지함과 동시에 더 넓은 computation path를 탐색합니다. 실험 결과, Qwen3-30B-A3B 모델에서 ESRL은 평균 Pass@1을 3.2%p, Pass@8을 4.5%p 향상시키며 GRPO 대비 압도적인 성능 우위를 증명했습니다. [Table 1]에서 확인할 수 있듯이, 이러한 개선은 수학, 과학, 코드 등 다양한 도메인에서 일관되게 나타나며, 특히 science 벤치마크에서는 Pass@8 기준 최대 23.3%p의 비약적인 상승을 보였습니다. 또한 [Table 2]는 제안 방법론이 다양한 MoE 구조와 모델 규모에 관계없이 범용적인 성능 향상을 이끌어냄을 입증합니다.
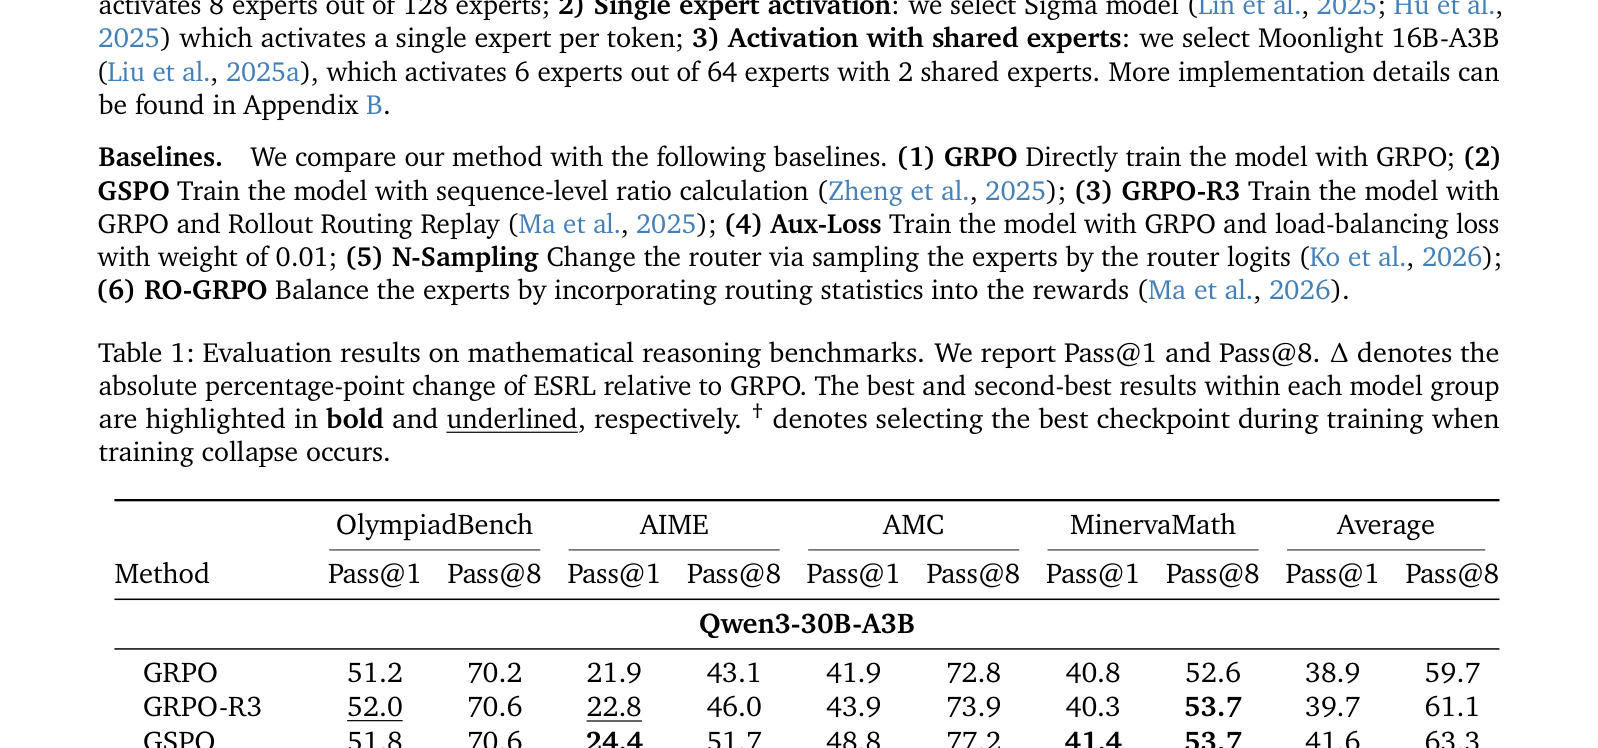
Table 1 — 기존 Baseline인 GRPO 대비 ESRL의 성능 우위를 정량적으로 보여주는 핵심 결과 테이블
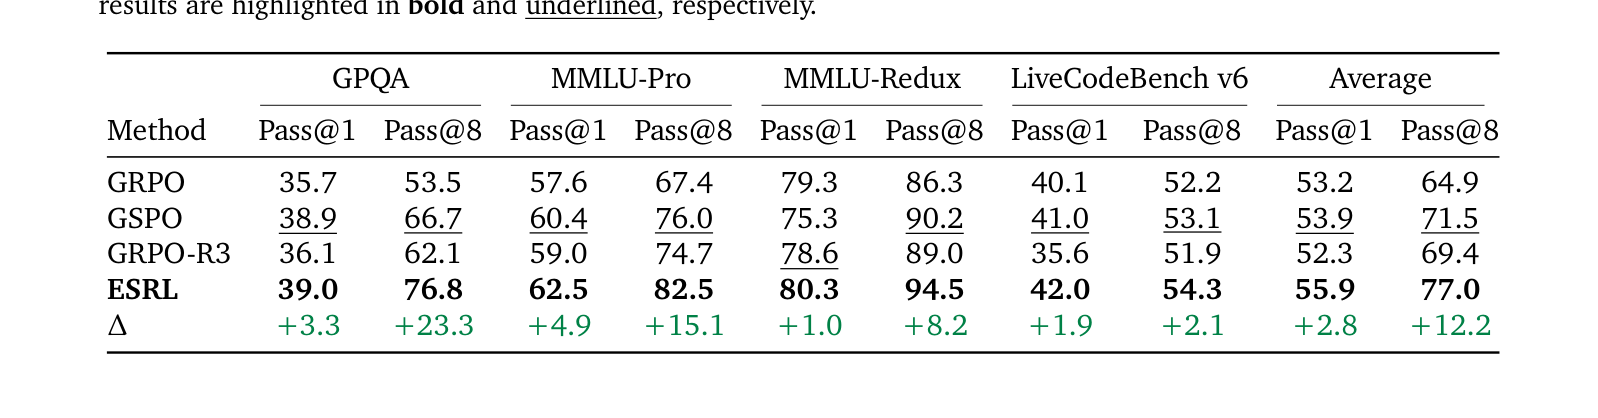
Table 2 — 수학 이외의 도메인(과학, 코드)에서의 범용적인 성능 개선을 입증하는 결과 테이블
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 expert routing 공간의 탐색이 MoE 기반 LLM의 RL 학습을 위한 강력하고 새로운 차원의 전략임을 명시합니다. ESRL은 기존의 reward 설계나 loss 수정 없이도 rollout 단계에서만 routing 구조를 적응적으로 활용하여 탐색 능력을 극대화한다는 점에서 높은 확장성과 Orthogonal한 이점을 제공합니다. 이러한 접근 방식은 향후 MoE 모델의 효율적인 대규모 학습뿐만 아니라, 특정 전문가 지식의 균형 잡힌 활용이 필요한 다양한 도메인으로의 확장 가능성을 열어주었으며, 모델의 고차원적인 추론 능력을 끌어내는 데 중요한 학술적 근거를 마련했습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Stabilizing MoE Reinforcement Learning by Aligning Training and Inference Routers
- [논문리뷰] Don't Mask the Environment: Observation Supervision Changes How Agents Explore Under RL
- [논문리뷰] WarpSAC: Towards the Pinnacle of Scalable Off-policy RL by Rethinking Exploration and Exploitation
- [논문리뷰] TREK: Distill to Explore, Reinforce to Refine
- [논문리뷰] On the Scaling of PEFT: Towards Million Personal Models of Trillion Parameters
Review 의 다른글
- 이전글 [논문리뷰] Dream-RSI: Recursive Self-Improvement through Evolving Worlds
- 현재글 : [논문리뷰] Expert-Space Exploration in MoE Reinforcement Learning
- 다음글 [논문리뷰] Grouped Value Attention: Efficient KV Caching via On-Demand Key Reconstruction
댓글