[논문리뷰] Don't Mask the Environment: Observation Supervision Changes How Agents Explore Under RL
링크: 논문 PDF로 바로 열기
저자: Juzheng Zhang, Disha Makhija, Manoj Ghuhan Arivazhagan, Vinayshekhar Bannihatti Kumar, Rashmi Gangadharaiah
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- ActObs: 환경 관찰(Environment observation) 토큰을 마스킹하지 않고 손실 함수(Loss function)의 예측 대상으로 포함하여 에이전트의 환경 모델링 능력을 강화하는 새로운 SFT 방법론입니다.
- ActionSFT: 에이전트의 행동(Action) 토큰에만 손실을 적용하고 환경 관찰 토큰은 컨텍스트로만 취급하는 기존의 표준적인 trajectory 학습 방식입니다.
- GRPO (Group Relative Policy Optimization): 환경과의 상호작용을 통해 에이전트의 성능을 개선하는 강화학습 알고리즘으로, 본 논문에서는 SFT 이후의 정책 최적화 과정에서 사용되었습니다.
- pass@k: 주어진 샘플링 예산(k) 내에서 최소 하나의 성공적인 trajectory를 생성할 확률을 측정하는 에이전트 성능 평가지표입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 기존 SFT 관행이 에이전트가 환경과의 상호작용 결과인 관찰(Observation)을 예측하도록 학습하지 않아 강화학습(RL)을 위한 최적의 초기화 정책을 제공하지 못한다는 문제의식에서 출발합니다. 기존 ActionSFT는 행동 모방에만 치중하여 환경에 대한 예측 모델을 퇴화시키며, 이는 후속 강화학습 과정에서의 탐색(Exploration) 효율을 저하시키는 원인이 됩니다. 본 논문은 [Figure 1]을 통해 환경 관찰 토큰을 손실 예측에 포함하는 것이 에이전트의 정책 변화와 이후 강화학습 성능에 어떠한 영향을 미치는지 분석하고자 합니다.
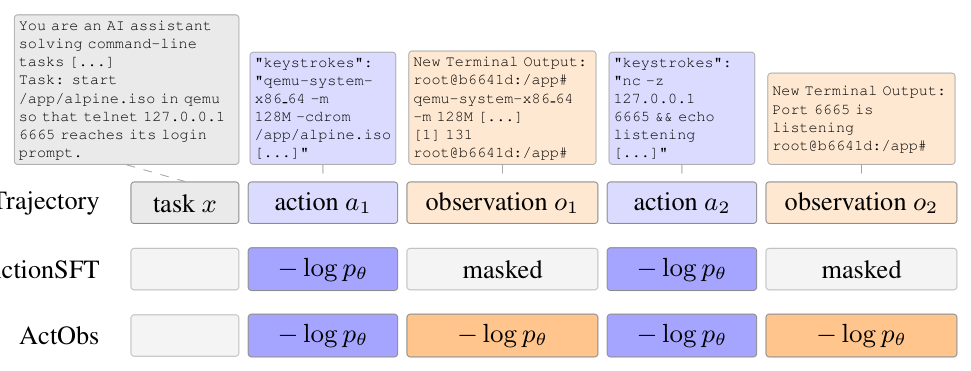
Figure 1 — ActObs와 ActionSFT의 학습 타겟 차이를 명확히 보여주는 핵심 방법론 다이어그램
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 논문은 에이전트 trajectory 내의 환경 관찰 토큰을 예측 대상으로 추가하는 ActObs objective를 도입하여, 별도의 데이터, 파라미터, 혹은 추가적인 추론 단계 없이 에이전트의 인과 관계 모델링 능력을 극대화합니다. 이 방법은 학습 초기 단계부터 행동 기울기(Action gradient)와 관찰 예측 기울기가 직교(Orthogonal)하게 분리되는 현상을 방지하며, [Table 1]에 나타난 것처럼 Qwen3-4B 및 8B 모델에서 강화학습 후 더 높은 pass@k 성능을 달성합니다. 특히, Terminal-Bench 2.0 벤치마크에서 ActObs 기반 정책은 강화학습 과정에서 더 높은 엔트로피를 유지하고 적은 정책 이동(Policy movement)을 보이면서도 더 많은 태스크를 해결하는 것으로 확인되었습니다. aider-polyglot 코드 편집 벤치마크에서도 기존 ActionSFT 대비 pass@1 기준 43% 향상된 성능을 보여, 도메인 간 강한 전이 학습 능력을 입증했습니다.
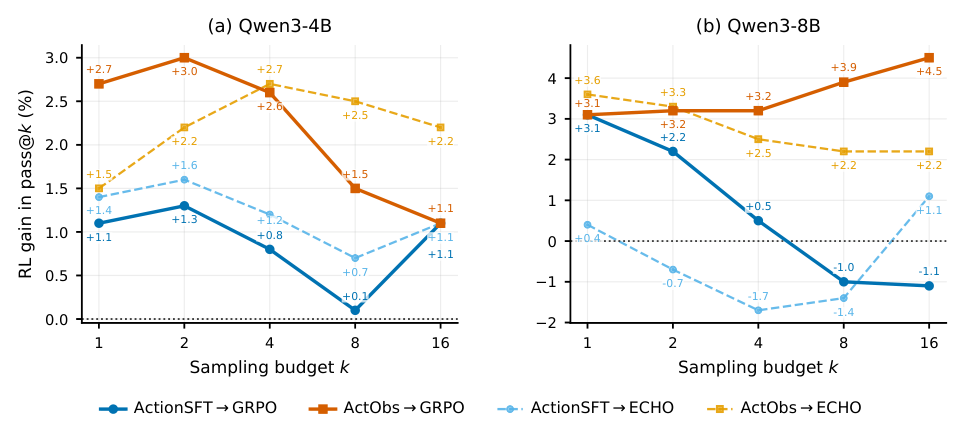
Table 1 — 제안 방법론인 ActObs와 기존 ActionSFT의 정량적 성능 비교표
## 4. Conclusion & Impact (결론 및 시사점) 본 연구는 환경 관찰에 대한 공동 학습(Joint supervision)이 강화학습을 위한 강력하고 안정적인 초기화 정책을 제공함을 증명합니다. 단순한 행동 모방을 넘어 환경의 피드백을 예측하게 함으로써 에이전트는 더 넓은 행동 공간을 유지하고, 결과적으로 강화학습 과정에서 더 효율적으로 탐색하고 성능을 개선할 수 있습니다. 본 기법은 기존 에이전트 학습 파이프라인의 손실 마스크를 변경하는 것만으로도 즉각적인 성능 개선을 이끌어낼 수 있어, 향후 다양한 에이전트 기반 모델의 학습 효율성을 높이는 데 중요한 가이드라인을 제공합니다.
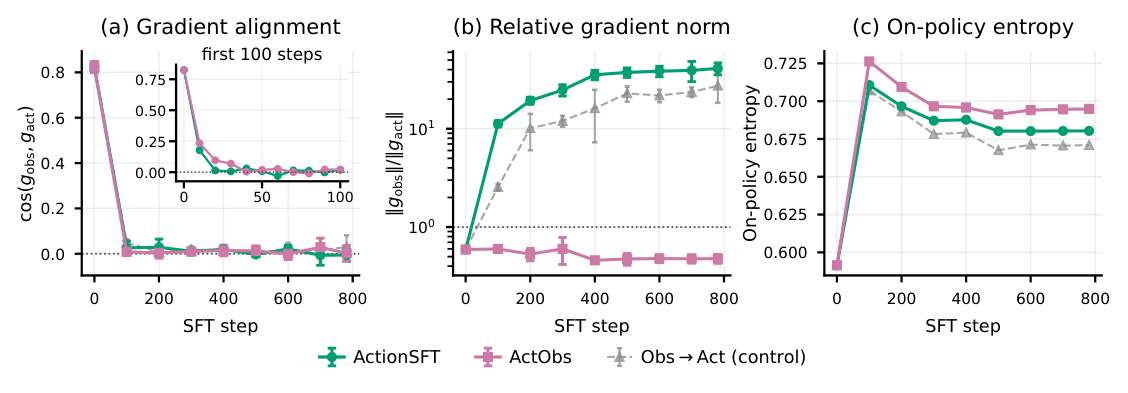
Figure 5 — 기울기 최적화 과정에서 ActObs가 직교성 문제를 어떻게 해결하는지 설명하는 메커니즘 분석 그래프
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Distill Where You Fail: Recovering Learning Signals of Negative RL-Groups from Adaptive Teacher Guidance
- [논문리뷰] TREK: Distill to Explore, Reinforce to Refine
- [논문리뷰] Inpainting-Guided Policy Optimization for Diffusion Large Language Models
- [논문리뷰] Rufus-Air: An Open LLM Post-Training Recipe
- [논문리뷰] VideoGen-Agent: Reinforcing Video Generation Agents
Review 의 다른글
- 이전글 [논문리뷰] DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression
- 현재글 : [논문리뷰] Don't Mask the Environment: Observation Supervision Changes How Agents Explore Under RL
- 다음글 [논문리뷰] FAMOS: Feed-Forward 3D Articulation Modeling from Sparse Observations
댓글