[논문리뷰] FAMOS: Feed-Forward 3D Articulation Modeling from Sparse Observations
링크: 논문 PDF로 바로 열기
저자: Kevin Qu, Tao Sun, et al.
1. Key Terms & Definitions
- FAMOS (Feed-Forward 3D Articulation Modeling from Sparse Observations): 이 논문에서 제안하는 feed-forward 모델로, sparse하고 unordered한 partial point clouds로부터 movable-part segmentation과 joint parameters를 예측합니다.
- Multi-state Articulation Transformer: FAMOS의 핵심 아키텍처로, state-wise attention과 global attention을 번갈아 적용하여 여러 observation에 걸쳐 articulation cues를 통합하는 Transformer 모델입니다.
- Observed Articulation Span: 논문에서 제안하는 새로운 training objective로, input observation 세트에서 각 part가 보이는 motion range를 감독하여 모델이 모든 articulation state를 활용하도록 장려합니다.
- Revolute Joint: 단일 축을 중심으로 회전 운동을 허용하는 관절로, unit axis와 origin으로 parameterize됩니다.
- Prismatic Joint: 단일 방향을 따라 병진(sliding) 운동을 허용하는 관절로, unit direction으로 parameterize됩니다.
2. Motivation & Problem Statement
본 논문은 sparse한 monocular observations로부터 articulated objects를 정확하게 모델링하는 데 내재된 핵심 문제를 해결하고자 합니다. 기존 test-time optimization-based methods는 dense multi-view inputs를 요구하며 계산 비용이 높아 scalability에 한계가 있습니다. Single-state feed-forward methods는 단일 observation에서 kinematic properties를 추론하기 위한 motion evidence가 부족하여 주로 학습된 category-level shape priors에 의존하며, 이는 unseen geometries 및 partial inputs에 대한 generalization 성능 저하로 이어집니다. 심지어 여러 articulation states의 observation이 제공되더라도, 기존 방법들은 각 observation을 독립적으로 처리하여 중요한 motion cues를 활용하지 못합니다. 이러한 한계점들을 극복하기 위해, 여러 sparse observations를 동시에 고려하여 articulation을 예측하는 새로운 feed-forward 접근 방식의 필요성이 제기됩니다.
3. Method & Key Results
저자들은 sparse하고 unordered한 partial point clouds로부터 movable-part segmentation과 joint parameters를 예측하는 feed-forward 모델인 FAMOS를 제안합니다. 핵심 방법론은 state-wise attention과 global attention을 번갈아 사용하는 Multi-state Articulation Transformer입니다 [Figure 2]. 이 구조는 개별 observation 내의 geometric context와 observation 간의 직접적인 상호작용을 통합하여 다양한 수의 input을 유연하게 처리하며 articulation cues를 효과적으로 집계합니다. 또한, 모델이 개별 observation의 geometry에만 의존하는 학습 shortcut을 방지하기 위해, input 세트 전반에 걸쳐 각 part가 보이는 motion range를 감독하는 새로운 training objective인 observed articulation span을 도입합니다 [cite: 1, 3, Figure 3]. 이 objective는 모델이 모든 articulation states에 걸쳐 정보를 통합하도록 유도합니다. 데이터셋의 규모와 다양성 한계를 극복하고자, 저자들은 training 중에 self-annotated assets를 on-the-fly로 합성하는 procedural data generator를 개발했습니다 [cite: 1, 4, Figure 4].
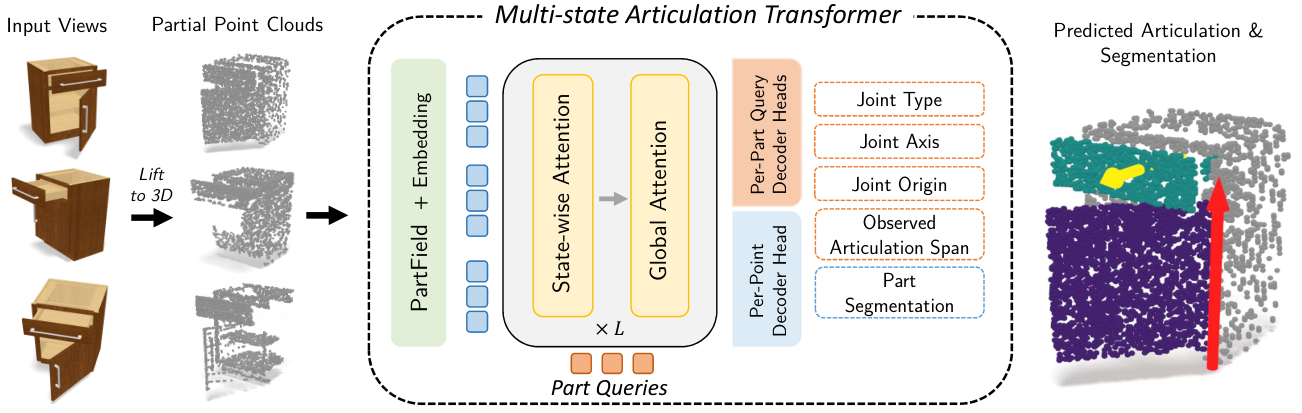
Figure 2 — 제안하는 Famos 프레임워크 개요
실험 결과, FAMOS는 PartNet-Mobility, ACD, ArtiCraft-10K 세 가지 benchmark에서 기존의 feed-forward baseline인 Particulate와 optimization-based baseline인 ReArt, ArtGS 대비 일관된 성능 향상을 보였습니다. Movable-part segmentation에서 FAMOS는 PartNet-Mobility에서 98.4% F1 score를 달성했으며, cross-dataset benchmark인 ACD에서는 71.9%, ArtiCraft-10K에서는 92.5%를 기록하여 Particulate 대비 최대 28.2 F1 points의 상대적 개선을 보였습니다. Motion estimation에서는 가장 엄격한 MAO (M + Axis Error < 5° + Origin Error < 0.05) 기준에서 PartNet-Mobility 98.4%, ACD 64.5%, ArtiCraft-10K 90.0%의 F1 score를 달성하여 Particulate 대비 최대 27.8 F1 points 향상되었습니다. 또한, FAMOS는 optimization-based methods보다 약 3,000배 더 빠르게 추론을 수행합니다 [cite: 1, Table B.1]. Ablation study를 통해 global attention과 observed articulation span loss가 articulation estimation 정확도에 결정적인 역할을 함이 확인되었습니다 [cite: 8, Figure 7 (a)]. Procedural pre-training과 curated data를 혼합한 training strategy는 특히 out-of-distribution 데이터셋에서 강력한 generalization 성능을 보여줍니다 [cite: 9, Table 5]. 심지어 단일 input state(S=1) 환경에서도 FAMOS는 Particulate baseline보다 우수한 성능을 보여, robust한 object-centric prior를 학습했음을 시사합니다 [cite: 7, Table 3]. 정성적 결과는 FAMOS가 synthetic training에만 의존했음에도 불구하고 real-world captures에 효과적으로 generalize함을 보여줍니다 [cite: 1, Figure 1, Figure 6].
4. Conclusion & Impact
본 논문은 sparse monocular observations로부터 articulated object modeling을 위한 feed-forward 접근 방식인 FAMOS를 성공적으로 제시했습니다. 제안된 Multi-state Articulation Transformer는 state-wise attention과 global attention의 조합을 통해 다중 observation 정보를 효과적으로 통합하며, observed articulation span objective는 모델이 articulation cues를 최대한 활용하도록 유도하여 generalization 성능을 향상시킵니다. 또한, procedural asset generator는 기존 데이터셋의 한계를 극복하고 다양한 self-annotated training data를 대규모로 제공함으로써 연구의 중요한 기반을 마련했습니다. 이 연구는 기존 feed-forward 및 optimization-based methods 대비 일관된 성능 향상을 입증하며, casual하고 sparse한 captures로부터 single feed-forward pass로 정확하게 articulation을 예측함으로써 robotics, AR/VR, embodied AI 분야에서 효율적이고 신뢰할 수 있는 object manipulability 이해를 위한 실용적인 솔루션을 제공합니다.
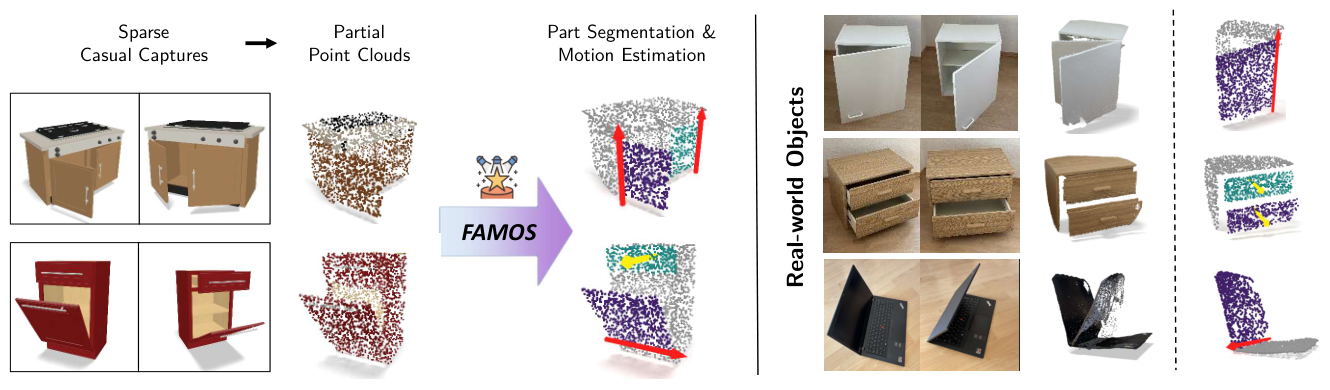
Figure 1 — Famos 모델 개요 및 실제 적용 사례
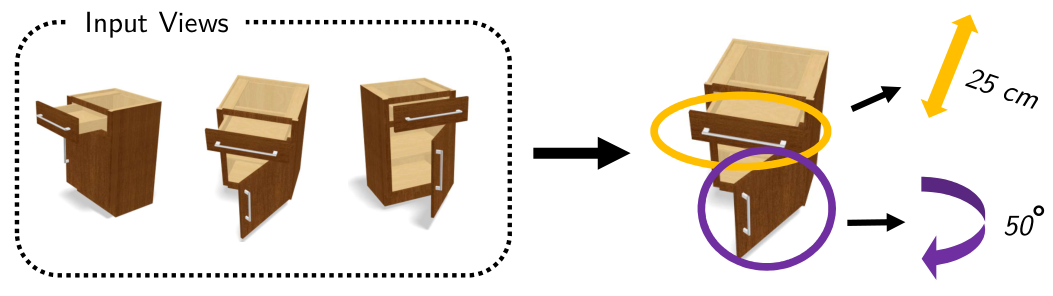
Figure 3 — 관측된 관절 가동 범위 (Observed articulation span)
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs
- [논문리뷰] Neural Spectral Capacity: Measuring and Designing Architectures from Network Specification Alone
- [논문리뷰] Grouped Value Attention: Efficient KV Caching via On-Demand Key Reconstruction
- [논문리뷰] RelightFormer: Feed-forward Generative Transformer for Multiview Object Relighting
- [논문리뷰] Encoded Early, Used Late: Where Transformers Begin to Act on an Inferred Partner's Expertise
Review 의 다른글
- 이전글 [논문리뷰] Don't Mask the Environment: Observation Supervision Changes How Agents Explore Under RL
- 현재글 : [논문리뷰] FAMOS: Feed-Forward 3D Articulation Modeling from Sparse Observations
- 다음글 [논문리뷰] JEPA-Anything: Learning Predictive Models across Different Worlds
댓글