[논문리뷰] Neural Spectral Capacity: Measuring and Designing Architectures from Network Specification Alone
링크: 논문 PDF로 바로 열기
저자: Chenyu Zhu, Ruoyu Zhao, Zhichao Lu
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 제안하는 Neural Spectral Capacity (NSC)는 아키텍처 사양만으로 계산 가능한 closed-form scalar입니다.
- Neural Spectral Capacity (NSC): 각
weight matrix의singular-value spectrum에 기반하며,parameter count나FLOPs를 넘어선architectural structure를 포착하는scalar quantity입니다. - NSC-DP:
NSC의layer-wise additive structure를 활용하여resource constraint하에서NSC를 전역적으로 최대화하는 아키텍처를 찾아내는exact dynamic-programming solver입니다. - Spectral Capacity (ψ(W)):
weight matrix W에 해당하는linear Gaussian channel의mutual information capacity를 나타내는per-matrix score로,ln det(I + W^T W)또는∑i ln(1 + σi^2)로 정의됩니다. - Marchenko–Pastur law:
random matrix theory의 핵심 이론으로,standard random initialization조건에서min(m,n) → ∞일 때weight matrix의spectral capacity (ψ)가 행렬의dimensions과initialization variance만으로deterministic하게 계산 가능함을 보장합니다. - Training-free Proxies:
neural architecture search (NAS)에서training cost를 회피하기 위해initialization시점에 아키텍처를 평가하는scalar function들을 지칭하며, 일반적으로model instantiation이나data,gradients를 필요로 합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
현대 Transformer 아키텍처의 설계 및 압축은 고정된 parameter 또는 compute budget 하에서 capacity를 architectural component에 어떻게 배분할지에 대한 문제로 귀결됩니다. 기존의 standard scalar tools인 #Params와 #FLOPs는 size와 compute만을 포착할 뿐, depth-width tradeoff, FFN ratio, attention-head allocation과 같은 architectural structure에 대한 정보를 제공하지 못합니다. 이로 인해 동일한 budget을 가진 두 아키텍처가 다른 structure를 가질 때 identical scores를 받지만 실제 trained performance는 다르게 나타나는 한계가 있습니다. 또한, 기존의 training-free proxies들은 randomly-initialized network를 instantiate하고 activation patterns나 gradient norms 등을 측정하여 score를 도출하기 때문에 LLM scale에서는 expensive하며 input data에 의존적입니다. 이들 proxy는 black-box scalar function이므로 resource constraint 하에서 globally optimal한 아키텍처를 찾는 것이 아닌, heuristic search를 통해 visited된 아키텍처 중 best를 반환하는 제약이 있습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Transformer의 architectural specification만으로 계산 가능한 closed-form scalar인 Neural Spectral Capacity (NSC)를 제안합니다. NSC의 구성은 각 weight matrix의 singular-value spectrum에 기반하며, 이를 linear Gaussian channel의 mutual information에 연결합니다. per-matrix capacity인 ψ(W)는 ln det(I + W^T W)로 정의되며, 이는 singular values의 합으로 표현됩니다. standard random initialization 조건에서 Marchenko–Pastur law를 통해 ψ(W)는 matrix의 dimensions와 initialization variance만으로 deterministic하게 계산 가능하며, model instantiation, data, gradients가 필요 없습니다. 네트워크 전체의 NSC는 각 layer의 per-matrix capacity를 합산하여 계산되며, multi-head attention은 per head로 분해되어 합산되는 layer-wise additive structure를 가집니다. 이러한 additive structure 덕분에 NSC는 NSC-DP라는 exact dynamic-programming solver를 사용하여 resource constraint 하에서 NSC를 globally maximizing하는 아키텍처를 찾아낼 수 있습니다.
핵심 결과로, NSC는 일곱 개의 Transformer 및 CNN architecture families에 걸쳐 trained performance를 ranking하는 데 있어 #Params, #FLOPs, 그리고 기존 training-free proxies를 outperform합니다. 특히 FlexiBERT 벤치마크에서 #Params가 τ=0.082로 ranking signal이 붕괴될 때, NSC는 parameter count가 <10% 차이 나는 아키텍처 쌍에서 τ=0.505의 높은 correlation을 유지하여 architectural structure를 포착하는 능력을 입증했습니다 [cite: 1, Figure 2]. end-to-end architecture search에서는 NSC-DP가 WikiText-103 벤치마크의 Transformer-XL 아키텍처를 human-designed baseline 대비 더 우수한 test PPL 23.087로 발견하며, 이는 CPU에서 22 seconds 만에 달성되어 기존 training-free proxies의 heuristic search 방식보다 400x 이상 faster합니다. 또한, structured pruning 분야에서 NSC-DP는 LLaMA-7B 모델을 5.7B로 pruning할 때, calibration data 없이 여덟 가지 commonsense reasoning tasks에서 best model을 생성하며, 이는 가장 강력한 training-free proxy baseline 대비 ~5900x faster한 성능을 보였습니다 [cite: 1, Figure 3].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Neural Spectral Capacity (NSC)와 이를 활용한 exact dynamic-programming solver인 NSC-DP를 도입하여 Transformer 아키텍처 설계 및 압축에 대한 새로운 패러다임을 제시합니다. NSC는 model instantiation이나 data, gradients 없이 architectural specification만으로 capacity를 quantify하고, NSC-DP는 resource constraint 하에서 globally optimal한 아키텍처를 orders of magnitude faster하게 찾아낼 수 있는 독점적인 이점을 제공합니다. 이 연구는 neural architecture search 및 large language model (LLM) compression 분야에 중대한 영향을 미칩니다. 학계 및 산업계는 NSC를 통해 resource-constrained environment에서 architecture decision-making의 efficiency와 effectiveness를 극대화할 수 있으며, 특히 MHA/GQA/MQA grouping 및 per-layer expert allocation in MoEs와 같은 architectural axes로의 확장이 용이하여 향후 Transformer 기반 시스템의 optimization에 중요한 quantitative tool로 자리매김할 것으로 기대됩니다.
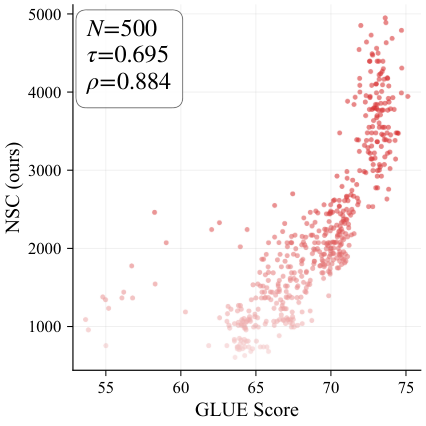
Figure 2 — NSC 랭킹 품질 예시
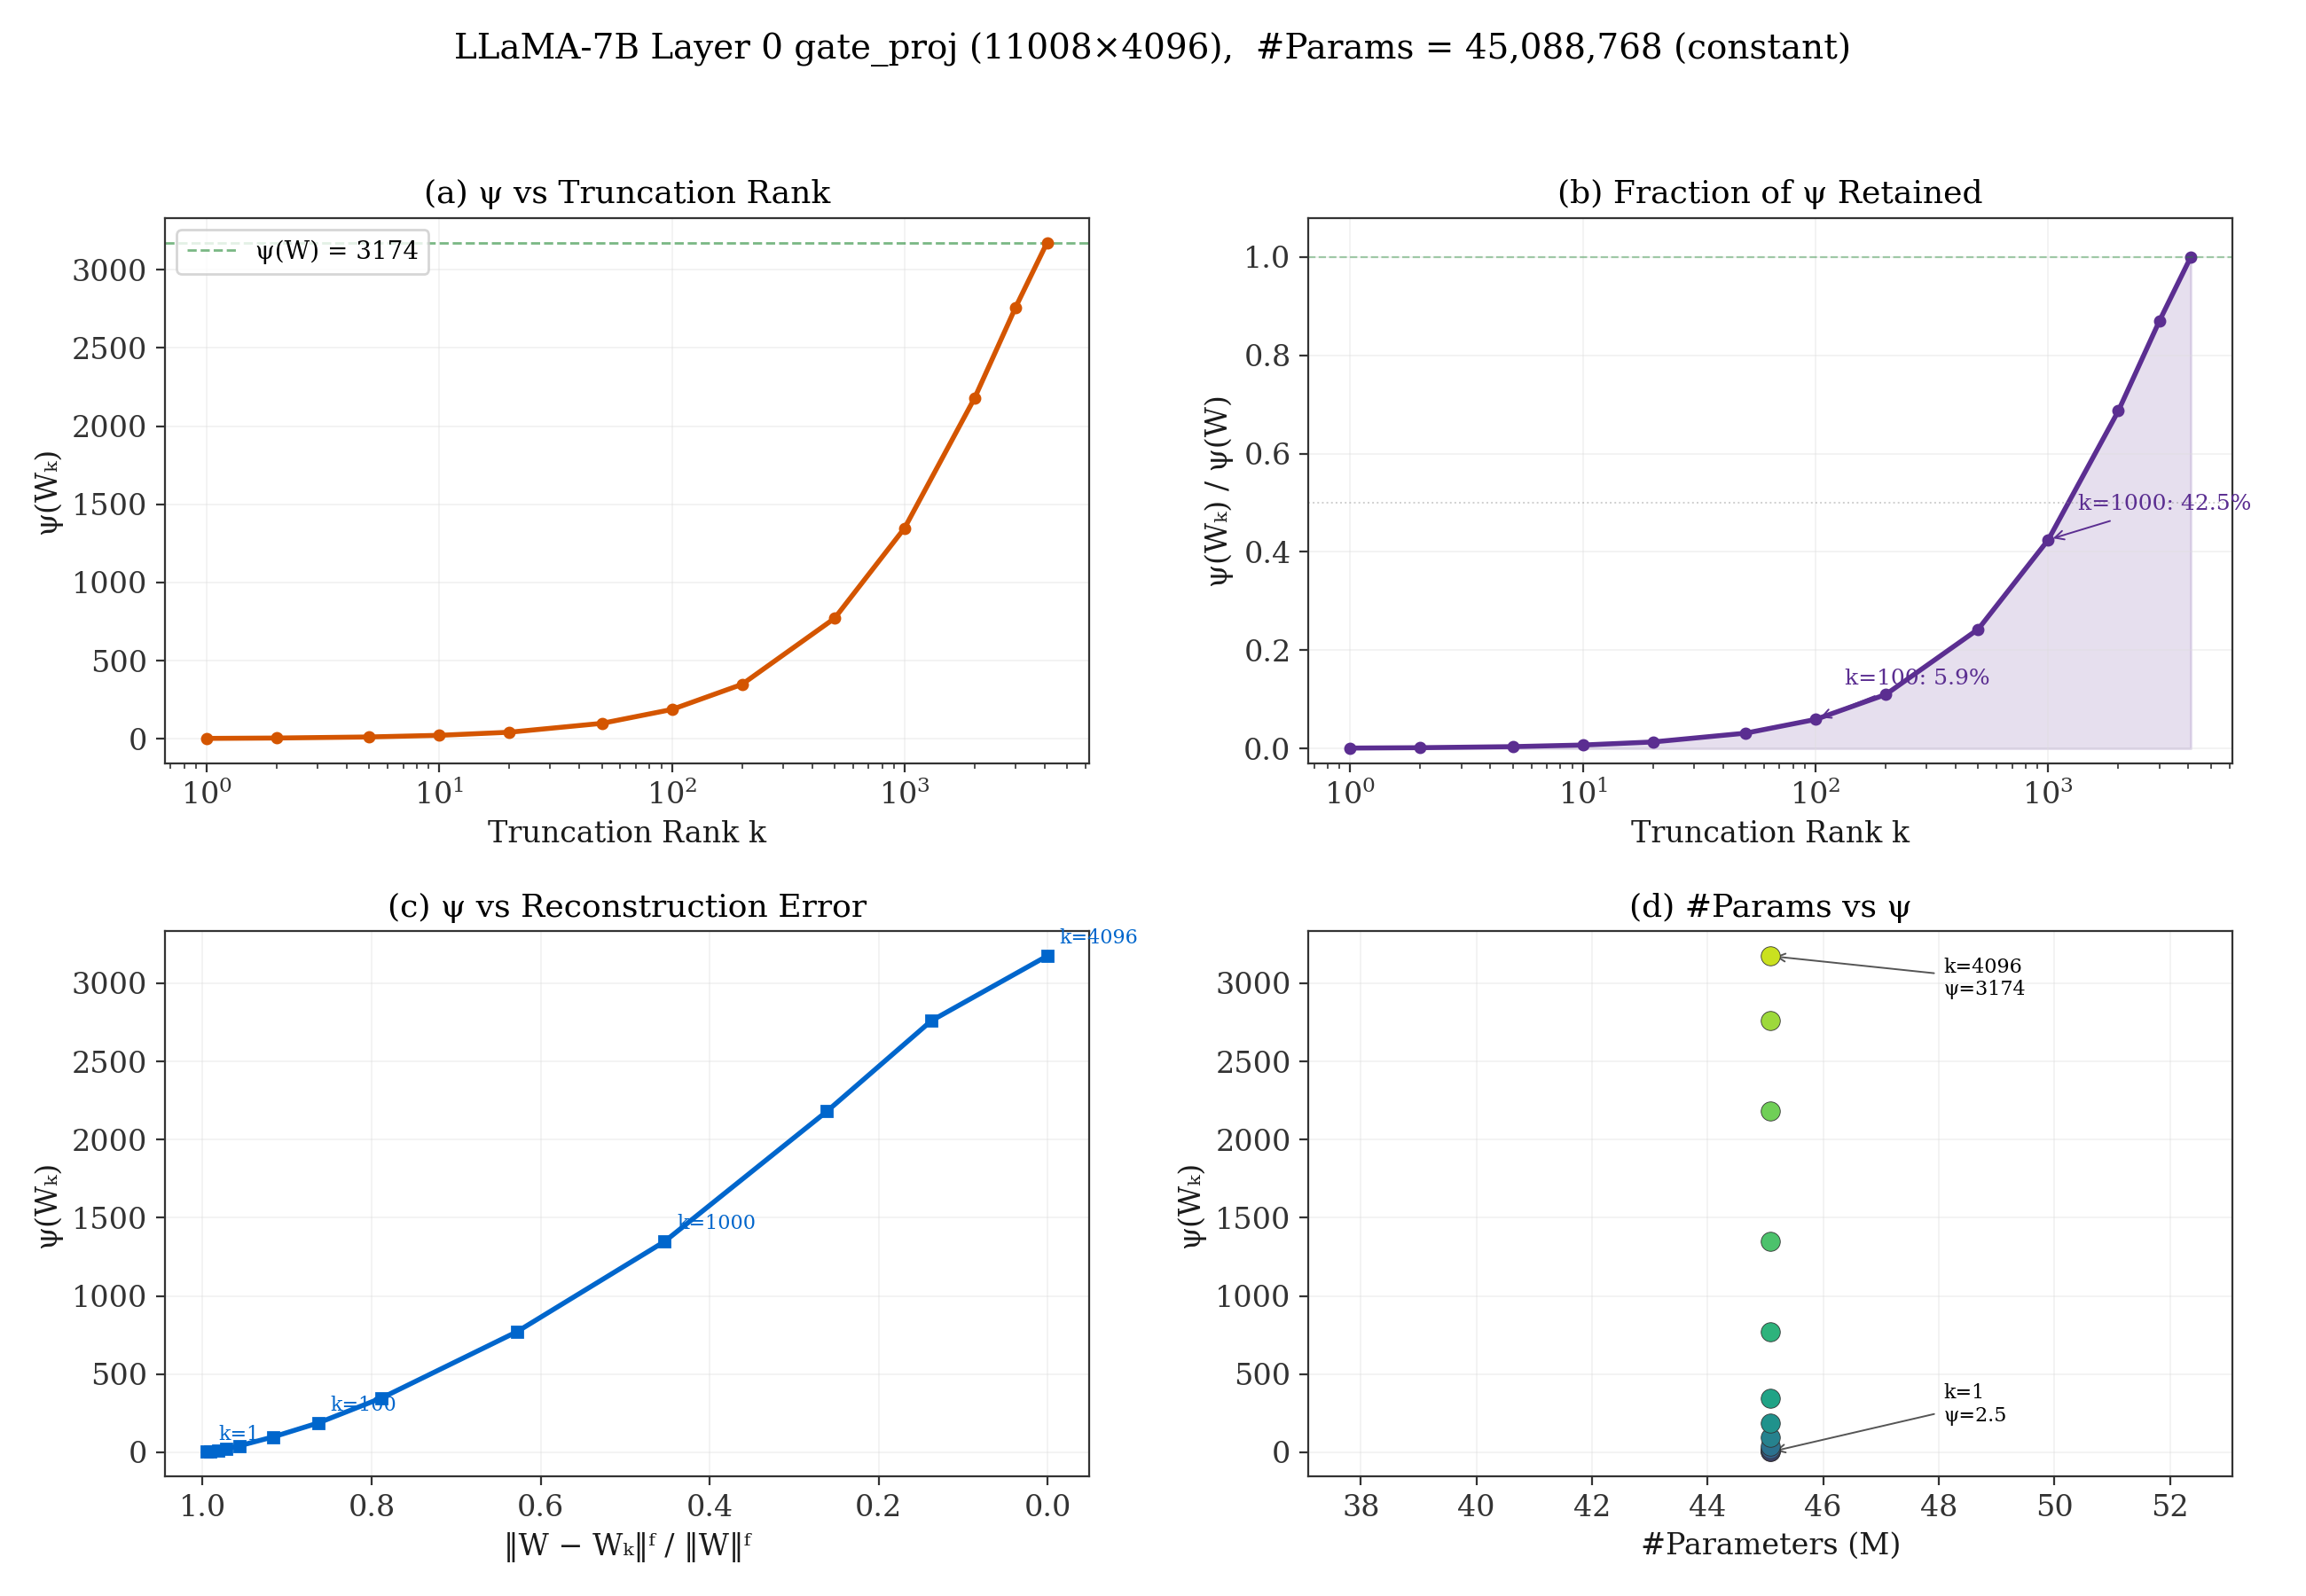
Figure 4 — ψ와 파라미터 수 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs
- [논문리뷰] FAMOS: Feed-Forward 3D Articulation Modeling from Sparse Observations
- [논문리뷰] Grouped Value Attention: Efficient KV Caching via On-Demand Key Reconstruction
- [논문리뷰] RelightFormer: Feed-forward Generative Transformer for Multiview Object Relighting
- [논문리뷰] Encoded Early, Used Late: Where Transformers Begin to Act on an Inferred Partner's Expertise
Review 의 다른글
- 이전글 [논문리뷰] Just Ask Jev: Reinforcement Learning for Calibrated Decisions as a Zero-Shot Detector of AI Alignment Failures
- 현재글 : [논문리뷰] Neural Spectral Capacity: Measuring and Designing Architectures from Network Specification Alone
- 다음글 [논문리뷰] OmniEcho: Spatial Audio Understanding for Embodied Agents
댓글