[논문리뷰] Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs
링크: 논문 PDF로 바로 열기
저자: Pavel Tikhonov, Anton Korznikov, Matvey Mikhalchuk, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Superposition Linearity Hypothesis: 두 개의 개별적인 텍스트 스트림의 임베딩이 선형적으로 결합될 때, Large Language Model (LLM)이 각 스트림의 다음 토큰 분포를 중첩하여 출력한다는 가설입니다.
- Embedding Mixing: 두 개 이상의 텍스트 스트림 임베딩을 토큰별로(element-wise) 평균화하여 단일 혼합 입력(mixed input)을 생성하는 과정입니다.
- Rank Analysis: 혼합된 출력 분포에서 개별 스트림의 Ground-Truth 다음 토큰이 차지하는 순위를 측정하여 정보 보존 정도를 정량화하는 분석 방법입니다.
- Superposition Approximation Ratio ($\mathcal{R}_{\mathcal{D}}$): 혼합된 입력에 대한 모델의 출력 분포와 이상적인 선형 혼합 분포 간의 불일치를 정량화하는 지표로, 값이 1 미만이면 혼합 상태 출력이 두 무관한 컨텍스트보다 이상적인 선형 혼합에 더 가깝다는 것을 의미합니다.
- Hidden-state Additivity: Transformer의 Residual Stream 내에서 hidden state들이 얼마나 선형적으로 중첩되는지를 나타내는 개념으로, 두 개별 hidden state의 합이 혼합된 hidden state와 얼마나 유사한지를 측정합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
최신 LLM의 기반이 되는 Transformer 아키텍처는 Self-Attention 및 MLP 블록과 같은 고도로 비선형적인 구성 요소를 사용합니다. 이로 인해 기존에는 추론을 단일하고 일관된 의미 스트림으로 처리하는 것이 일반적이었고, 여러 독립적인 스트림을 처리하려면 별도의 Forward Pass를 실행하거나 순차적 처리를 수행해야 했습니다. 그러나 최근 연구에서 Decoder-only Transformer가 잔여 스트림(Residual Stream)에서 강한 선형 구조를 보인다는 점이 밝혀졌으며, 이는 Layer-to-layer 전환이 종종 Affine Map으로 근사될 수 있음을 시사합니다.
이러한 배경은 LLM의 End-to-End Input-Output 행동에서도 선형성이 확장될 수 있는지에 대한 근본적인 질문을 제기합니다. 기존 비선형 모델에서는 입력의 선형 조합이 의미적으로 무관한 출력으로 이어질 것으로 예상되었으나, 본 연구는 입력 임베딩을 선형적으로 조합했을 때 모델이 개별 다음 토큰 분포의 Superposition을 출력하는 Superposition Linearity Hypothesis를 제시합니다. 이러한 선형적 특성은 LLM의 효율적인 배포와 처리량(Throughput) 증대, 메모리 소비 감소에 중요한 함의를 가집니다. 특히 Figure 1에서 볼 수 있듯이, Embedding Mixing 후에도 단일 스트림 예측 토큰이 혼합 분포의 상위 랭크에 자주 나타나며, 이는 기존 모델의 한계를 넘어선 새로운 접근 방식의 필요성을 보여줍니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Transformer가 두 개의 사상을 동시에 처리할 수 있음을 입증하며, Superposition Linearity Hypothesis를 검증하기 위해 Embedding Mixing, Rank Analysis, Distributional Shape Preservation, Training Dynamics 분석 및 Fine-tuning을 통한 개선 방법론을 제시합니다. 먼저, 두 개의 고유한 입력 시퀀스 $x^{(A)}$와 $x^{(B)}$의 임베딩을 토큰별로 평균화하여 혼합 입력 임베딩 $z = \frac{1}{2}(E(x^{(A)})+E(x^{(B)}))$을 생성합니다. 이 혼합된 입력 $z$를 사전 학습된 Transformer 모델에 통과시켜 출력 Logit $\ell(z)$ 및 확률 분포 $P_{\text{mix}}(z)$를 얻습니다.
실험 결과, 사전 학습된 LLM은 놀라운 수준의 내재적 선형성(Intrinsic Linearity)을 보여주었습니다. 특히, Figure 1에 제시된 Cumulative Rank Distribution에 따르면, Pythia-2.8B, Llama-3.2-3B, Qwen2.5-3B 모델에서 Ground-Truth 토큰이 약 30–40%의 경우 상위 10위권 내에, 50–60%의 경우 상위 50위권 내에 나타났습니다. 이는 대규모 어휘 크기($|\mathcal{V}| \geq 50,000$)를 고려할 때, 원본 입력의 '신호'가 노이즈 수준 이상으로 잘 보존됨을 의미합니다. 또한, Distributional Approximation Metrics (KL, JS, Wasserstein Divergence)를 측정한 결과, Table 1에서 $P_{\text{mix}}$가 타겟 혼합 분포 $P_{\text{target}} = \frac{1}{2}(P(x|A)+P(x|B))$에 근접하며, Superposition Approximation Ratio ($\mathcal{R}_{\mathcal{D}}$)가 일관되게 1 미만을 기록했습니다.
연구진은 Superposition Linearity가 학습된 능력보다는 아키텍처의 내재적 특성임을 밝히기 위해 Pre-training 과정에서의 Linearity Dynamics를 추적했습니다. Figure 2는 Hidden-state Additivity Error ($\bar{\mathcal{E}}$)가 Pre-training 초기 Checkpoint에서 가장 작고, 학습이 진행됨에 따라 단조롭게 증가함을 보여주며, 이는 Pre-training이 Residual Stream의 비선형 상호작용을 증폭시키는 것과 일치합니다.
이러한 Linearity의 저하는 Lightweight Fine-tuning을 통해 크게 복원될 수 있습니다. 제안된 Self-distillation 프레임워크는 Mixed Input에 대한 모델 출력과 개별 출력의 혼합 간의 불일치를 최소화하도록 설계되었으며, 이는 Pythia-2.8B에서 Mean KL Divergence를 1.86에서 0.27로, $\mathcal{R}_{\mathrm{KL}}$을 0.42에서 0.06으로 크게 감소시켰습니다. Fine-tuning 후 Figure 1에서 True Next Token이 Top-5에 나타날 확률이 약 30%에서 60% 이상으로 증가했습니다. 특히 Table 2에 따르면, Fine-tuning은 Base 모델에서 Median Rank가 284였던 Content Position의 Median Rank를 5로 낮추고, Top-1 Agreement를 22.8%까지 높여, 모델이 복잡한 의미론적 콘텐츠를 병렬로 처리할 수 있음을 입증했습니다.
마지막으로, 논문은 혼합된 Hidden State에서 두 개의 스트림을 Disentangle하여 개별적인 Coherent Continuation을 생성하는 디코딩 절차인 Joint Contrastive decoding을 소개했습니다. 이 방법론은 Table 5에서 LAMBADA Mean Accuracy를 Qwen2.5-3B의 경우 0.168에서 0.345로, Llama-3.2-3B의 경우 0.182에서 0.430으로 향상시키면서 낮은 Jaccard Token Overlap을 유지했습니다. 이는 단일 Forward Pass에서 두 개의 Coherent Continuation을 생성할 수 있음을 보여주는 Proof-of-Concept입니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Transformer가 선형적으로 결합된 텍스트 스트림을 독립적인 경로의 Superposition으로 처리할 수 있음을 성공적으로 입증했습니다. 이러한 내재적인 아키텍처 특성은 표준 Pre-training 과정에서 저하되지만, 경량 Fine-tuning을 통해 강력하게 복원될 수 있으며, 이를 통해 모델은 혼합된 Hidden State 내에서 개별적인 의미 신호를 유지할 수 있습니다.
이러한 발견은 LLM의 효율적인 배포에 중요한 함의를 가집니다. Superposed Output을 성공적으로 Disentangle함으로써, 본 접근 방식은 단일 Forward Pass에서 두 개의 Coherent Continuation 생성을 가능하게 하여, 이론적으로 2배의 Inference Throughput 증가를 제공합니다. 또한, 여러 스트림이 단일 벡터 표현으로 압축되므로, 이 패러다임은 메모리 소비를 대폭 줄여 활성 스트림당 KV-Cache Footprint를 효과적으로 절반으로 감소시킵니다. 이는 챗봇 및 대규모 Retrieval-Augmented Generation (RAG) 시스템과 같이 높은 볼륨 또는 실시간 언어 생성이 필요한 애플리케이션에 큰 이점을 제공할 것입니다.
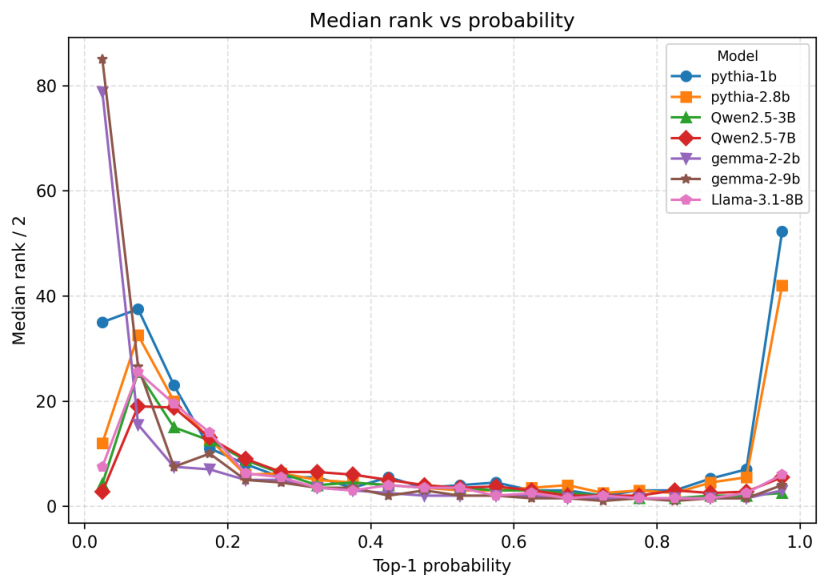
Figure 2 — 사전 학습 중 중첩 선형성 저하
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Delta Attention Residuals
- [논문리뷰] Adapting Vision-Language Models for E-commerce Understanding at Scale
- [논문리뷰] Token Sparse Attention: Efficient Long-Context Inference with Interleaved Token Selection
- [논문리뷰] BiasGym: Fantastic Biases and How to Find (and Remove) Them
- [논문리뷰] Pruning the Unsurprising: Efficient Code Reasoning via First-Token Surprisal
Review 의 다른글
- 이전글 [논문리뷰] World Action Agent: Harnessing VLMs for Robot Manipulation via World Action Rehearsal
- 현재글 : [논문리뷰] Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs
- 다음글 [논문리뷰] AgentWorld: Benchmarking Long-Horizon Collaboration of Multi-agent LLMs
댓글