[논문리뷰] VideoGen-Agent: Reinforcing Video Generation Agents
링크: 논문 PDF로 바로 열기
저자: Binxu Li, Haoyi Duan, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- VideoGen-Agent: 외부 도구를 활용하여 비디오를 생성하도록 학습된 Multimodal Agent입니다. Procedural Knowledge, Single/Multi-Entity Identity, Physics Simulation, Compositional Scene, Multi-Shot의 6가지 Task를 수행합니다.
- Multitask Agentic Reinforcement Learning: Multitask 환경에서 Agent가 외부 도구 사용 결정을 최적화하도록 Reinforcement Learning을 적용하는 방법론입니다. VideoGen-Agent의 2단계 학습 중 하나로, Tool Use와 비디오 품질을 평가하는 Hybrid Reward를 사용합니다.
- VABench: VideoGen-Agent의 성능 평가를 위해 제안된 6가지 Capability Category를 포괄하는 600개의 Held-out Prompt로 구성된 벤치마크입니다.
- Multitask Hybrid Reward: Agentic Reinforcement Learning 단계에서 사용되는 보상 함수로, Format Reward, VLM Reward, Tool-Use Reward의 세 가지 구성 요소로 이루어져 Tool Call의 유효성, 비디오 품질, Task에 적합한 도구 선택 및 활용을 종합적으로 평가합니다.
- Supervised Fine-Tuning (SFT): VideoGen-Agent 학습의 첫 번째 단계로, Teacher Agent가 생성한 Tool-Use Trajectory Dataset을 사용하여 Agent Policy를 Fine-Tuning하는 과정입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
현재 비디오 생성 모델은 Photorealistic하고 Temporally Coherent한 비디오를 생성하는 데 큰 발전을 이루었지만, 생성된 비디오가 Prompt에 명시된 내용을 정확하게 표현하는 데는 한계가 있습니다. 기존 모델들은 Pretraining 중 얻은 지식에 의존하여 특정 엔티티나 이벤트의 정확한 묘사에 어려움을 겪으며, 예를 들어 특정 인물의 Visual Identity를 클립 전체에 걸쳐 유지하지 못하거나, 물리 법칙을 위반하여 Implausible Behavior를 생성할 수 있습니다. 또한, 순서가 지정된 일련의 동작을 요구하는 Prompt의 경우, 모델이 단계를 누락하거나 순서가 뒤바뀌게 묘사하는 문제도 발생합니다. 이러한 문제들은 제품 시연, 교육 콘텐츠, 스포츠 분석 등 다양한 실용적 응용 분야에 영향을 미치며, 외부 지식과 도구를 활용하여 비디오 생성을 안내하는 새로운 접근 방식이 필요합니다. 기존 Agentic Video Generation 방식은 특정 목표에만 초점을 맞추는 경향이 있어 다양한 Heterogeneous Tasks에 걸쳐 도구 사용을 학습하는 데 한계가 있습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
VideoGen-Agent는 Multitask Agentic Reinforcement Learning을 통해 외부 도구를 사용하여 비디오를 생성하도록 학습된 Multimodal Agent입니다. 이 방법론은 크게 두 가지 단계로 구성됩니다. 첫 번째는 Supervised Fine-Tuning (SFT)으로, Teacher-Distilled Trajectories로 구성된 16K Agent Trajectory Dataset을 사용하여 Agent Policy를 Fine-Tuning합니다. 이 단계에서는 Next-Token Prediction Objective를 사용하여 Agent가 Teacher의 Tool-Use 패턴을 학습하게 합니다. 두 번째 단계는 Agentic Reinforcement Learning (RL)로, SFT Checkpoint에서 시작하여 Group Relative Policy Optimization (GRPO)를 통해 Agent Policy를 최적화합니다. RL 단계에서는 Multitask Hybrid Reward를 사용하여 학습 신호를 제공합니다. 이 Hybrid Reward는 Format Reward, VLM Reward, Tool-Use Reward의 세 가지 구성 요소로 이루어져 있으며, 각각 Tool Call의 유효성, 최종 비디오 품질 및 Prompt 일관성, Task에 적합한 도구 선택 및 출력 활용도를 종합적으로 평가합니다. 또한, Task Advantage Normalization을 통해 서로 다른 Task Category 간의 학습 신호 균형을 맞춥니다. [Figure 2]는 VideoGen-Agent의 전체 학습 파이프라인을 보여줍니다.
실험 결과, VideoGen-Agent는 VABench 벤치마크에서 뛰어난 성능을 보였습니다. Toolset 1을 사용한 VideoGen-Agent는 Baseline T2V Generator인 Seedance 1.0 대비 19.1 points 향상된 75.6의 Overall Score를 달성했습니다. 이는 가장 강력한 Standalone Baseline인 Seedance 2.0의 73.2 points를 2.4 points 초과하는 결과입니다. 특히, Toolset 2로 Generation Tool을 업그레이드했을 때는 추가 Agent Training 없이 Overall Score가 86.1까지 상승하며 모든 6가지 Category에서 최고 점수를 기록했습니다. [Figure 1]은 VideoGen-Agent가 Augmentation, Generation, Verification Tool을 조정하는 Multimodal Agent의 개요를 보여줍니다. Ablation Study를 통해 SFT와 RL Training Stage가 각각 69.2와 75.6으로 성능 향상에 기여했음이 확인되었고, Hybrid Reward의 각 구성 요소(VLM Reward 및 Tool Reward) 제거 시 성능이 각각 73.3 및 71.2로 감소하여 그 중요성이 입증되었습니다. [Figure 3]은 Procedural Knowledge Task에서 VideoGen-Agent가 Characteristic Arm Positions과 Movement Progression을 더 정확하게 재현함을 보여줍니다.
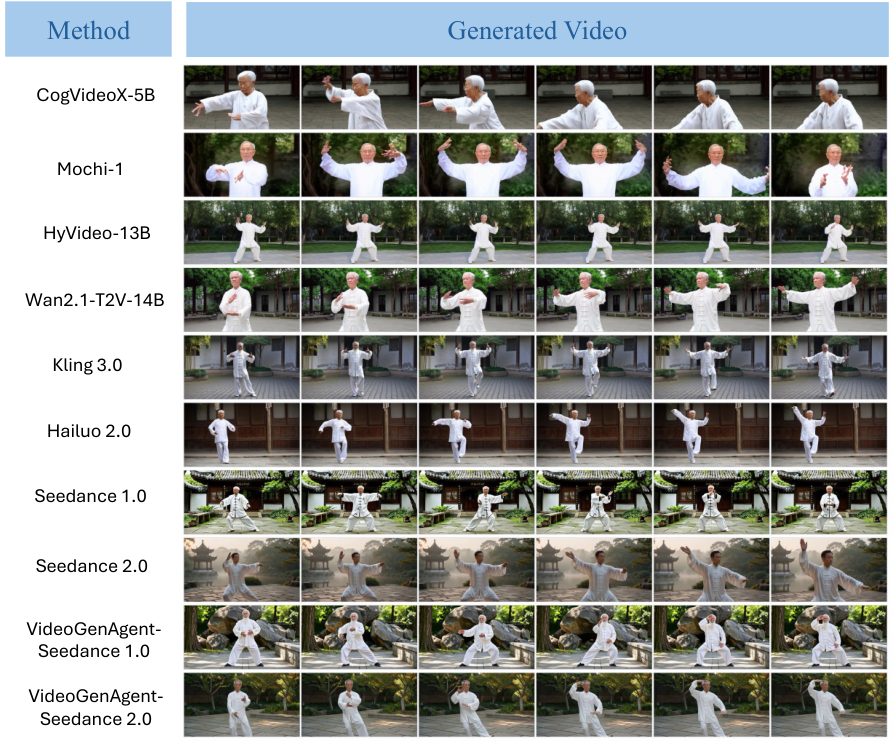
Figure 3 — Procedural Knowledge 정성적 비교
4. Conclusion & Impact (결론 및 시사점)
본 논문은 다양한 비디오 생성 Task에서 외부 도구를 활용하는 Multimodal Agent, VideoGen-Agent를 소개합니다. Supervised Fine-Tuning과 Multitask Reinforcement Learning의 2단계 학습을 통해 Agent는 Augmentation, Generation, Verification Tool을 효과적으로 조율하는 Policy를 학습합니다. 이 연구는 기존 단일 비디오 생성 모델이 어려움을 겪는 Procedural Knowledge, Identity Preservation, Physical Consistency, Compositional Scene, Temporal Ordering 등의 복합적인 요구사항을 충족시키는 데 크게 기여합니다. 특히, VABench 벤치마크에서의 정량적 성능 향상과 Human Preference 평가 결과는 Agentic Approach와 Tool Use의 효과를 강력하게 뒷받침합니다. 또한, 학습 과정에서 만나지 않은 상위 Generation Tool로도 성능 향상을 이끌어낼 수 있음을 보여줌으로써, Agent Training과 Generation Model 발전 간의 Complementary Benefits를 입증했습니다. VideoGen-Agent는 향후 더욱 복잡한 Workflow와 광범위한 Creative Task를 위한 비디오 생성 Agent 연구의 중요한 기반을 제공할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Geo-Align: Video Generation Alignment via Metric Geometry Reward
- [논문리뷰] Video Models Can Reason with Verifiable Rewards
- [논문리뷰] WorldCompass: Reinforcement Learning for Long-Horizon World Models
- [논문리뷰] Knowledge is Not Enough: Injecting RL Skills for Continual Adaptation
- [논문리뷰] SenseNova-MARS: Empowering Multimodal Agentic Reasoning and Search via Reinforcement Learning
Review 의 다른글
- 이전글 [논문리뷰] UltraTex: Unleashing 2K Multi-View Diffusion for 3D Texturing
- 현재글 : [논문리뷰] VideoGen-Agent: Reinforcing Video Generation Agents
- 다음글 [논문리뷰] Why Do Video Diffusion Models Violate Physics? Unveiling the Flaws in Attention Mechanisms
댓글