[논문리뷰] Why Do Video Diffusion Models Violate Physics? Unveiling the Flaws in Attention Mechanisms
링크: 논문 PDF로 바로 열기
저자: Yueyan Li, Haibo Wang, Caixia Yuan, Xiaojie Wang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Physical Commonsense: 모델이 일상생활 속 물리 객체 및 그 상호작용을 지배하는 물리 법칙(주로 역학, 광학, 열역학, 물질 특성 포함)에 대해 가지는 기본적인 이해를 지칭합니다.
- Motion Planning: 비디오 확산 모델 내에서 조건(condition)으로부터 의미론적 정보를 비디오 잠재(latent)에 도입하고, 이를 프레임별로 할당하여 객체의 위치를 결정하며, 프레임 간 객체 모션의 일관성을 유지하는 전반적인 프로세스를 의미합니다.
- Cross-Attention: 텍스트 프롬프트와 같은 조건부 의미 정보를 비디오 잠재 공간의 각 프레임 영역에 주입하고 할당하는 역할을 하는 메커니즘입니다.
- Self-Attention: 비디오 토큰 간의 통신을 가능하게 하여 프레임 간 관계를 조정하고 엔티티의 위치를 결정하는 데 핵심적인 역할을 하는 모듈입니다.
- Rotary Position Embedding (RoPE): 어텐션 모듈에서 쿼리(query)와 키(key)에 상대적 위치 정보를 주입하여 토큰 간의 인과적 논리 정보나 공간적 위치 관계를 포착하게 하는 기술이며, 3D 구현 시 과도한 공간 어텐션 감쇠를 유발할 수 있습니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
최신 비디오 확산 모델들은 인상적인 시각적 품질에도 불구하고, 실제 물리 법칙을 위반하는 콘텐츠를 자주 생성하여 물리적 상식(Physical Commonsense)의 부족을 드러냅니다. [cite: 1, Figure 1] 기존의 해결책들은 외부 물리적 사전 지식(external physical priors)을 도입하거나, 조건 프롬프트(condition prompts)를 재작성하거나, 물리 현상이 풍부한 특수 데이터를 추가하는 방식에 의존하지만, 이러한 방법들은 확장하기 어렵거나 문제의 근본적인 원인을 해결하지 못합니다. 따라서 본 연구는 비디오 확산 모델 내부 메커니즘을 탐구하여 비디오 생성 실패 모드의 근본적인 원인을 밝히고, 모델 아키텍처나 알고리즘 설계를 개선하는 데 초점을 맞춥니다. 특히, 모델의 물리적 상식과 밀접하게 관련된 "Motion Planning" 프로세스에 대한 해석 가능성 연구를 수행하여, 모션 궤적이 초기 디노이징(denoising) 단계에서 어떻게 형성되는지를 조사합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 비디오 확산 모델의 물리 법칙 위반 문제를 해결하기 위해 Text-to-Video (T2V) 모델의 "Motion Planning" 프로세스에 대한 최초의 해석 가능성 연구를 수행합니다. 이 연구는 디노이징 초기 단계에서 객체 모션 궤적이 "first shape, then details" 원칙에 따라 형성됨을 보여줍니다. 구체적으로, Cross-Attention 맵의 시간적 진화를 관찰한 결과, 객체 위치가 디노이징 초기 5단계 이내에 여러 후보 영역에서 최종 궤적으로 수렴하는 것을 확인했습니다. 저자들은 Attention Entropy 및 Support Quality와 같은 정량적 지표를 도입하여 이러한 수렴 과정을 측정하였으며, Causal Intervention 및 Attribution Patching 기법을 사용하여 모션 플래닝에 실질적으로 기여하는 특정 Cross-Attention Head의 부분집합을 식별했습니다 [cite: 1, 4, Figure 5].
Self-Attention 메커니즘 분석에서는 Rotary Position Embedding (RoPE)이 과도한 공간 어텐션 감쇠를 유발하여, 물리적으로 불가능한 위치에 초기 후보 영역이 조기에 고정되고 인접 프레임의 합리적인 궤적을 억제하는 "spatial anchoring effect"를 발견했습니다. [cite: 1, 6, Figure 16] 이 근본적인 결함을 해결하기 위해 저자들은 RoPE의 주파수(frequency) 스케일링(λh/w)을 디노이징 단계별로 조절하는 경량 아키텍처 수정 방안을 제안합니다. 이는 과도한 어텐션 감쇠를 줄여 모델이 더 많은 후보 영역을 탐색하고 물리적으로 일관된 모션을 확립하도록 돕습니다.
주요 실험 결과, 제안된 RoPE 수정 방법은 생성된 비디오의 Physical Commonsense (PC)를 현저히 향상시켰습니다. VideoPhy 벤치마크에서 Wan2.1-T2V-1.3B-LoRA+modified RoPE 모델은 기준 모델인 Wan2.1-T2V-1.3B의 29.45 Overall PC 대비 62.68 Overall PC를 달성하며 크게 개선되었습니다. 특히, Solid-Solid 상호작용에서 50.61 PC, Solid-Fluid 상호작용에서 72.81 PC를 기록하여 큰 폭의 성능 향상을 보였습니다. 또한, Prompt Refinement와 결합했을 때 Wan2.1-T2V-1.3B-LoRA+modified RoPE+PR 모델은 87.46 Semantic Adherence (SA)와 62.68 Overall PC를 기록하며 모든 베이스라인 및 조합보다 우수한 성능을 나타냈습니다. 훈련 프리(training-free) 및 훈련 기반(training-based) 실험 모두에서 방법론의 효과가 확인되었으며, 훈련 기반 접근 방식은 다양한 무작위 시드(random seeds)에 걸쳐 더 나은 일반화 성능을 보여주었습니다. 또한, 어텐션 모듈만 튜닝했을 때 FFN(Feed-Forward Network)을 포함한 경우보다 더 나은 결과를 얻어, 물리적 실패가 주로 어텐션 메커니즘에서 비롯됨을 확인했습니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 비디오 확산 모델이 물리적 상식을 위반하는 근본적인 원인이 Self-Attention 메커니즘의 Rotary Position Embedding (RoPE)에서 발생하는 과도한 공간 감쇠 결함임을 밝혀냈습니다. 저자들은 "first shape, then details"라는 발견에서 출발하여, Text-to-Video (T2V) 모델의 "Motion Planning" 과정에 대한 포괄적인 해석 가능성 분석을 제시했으며, 모션 궤적이 디노이징 초기 단계에 결정됨을 입증했습니다. 제안된 경량 RoPE modification 방법은 공간 어텐션 감쇠를 효과적으로 완화하여, 모델이 물리적으로 더 타당한 모션 궤적을 탐색하도록 유도합니다. 이 연구는 물리적 불일치의 아키텍처적 근본 원인을 해결하는 새로운 관점을 제공하며, 미래의 "World Simulators" 개발을 위한 더욱 견고하고 물리적으로 일관된 비디오 생성 모델 구축에 중요한 기여를 할 것으로 기대됩니다.

Figure 1 — 생성된 비디오의 물리 법칙 위반 사례
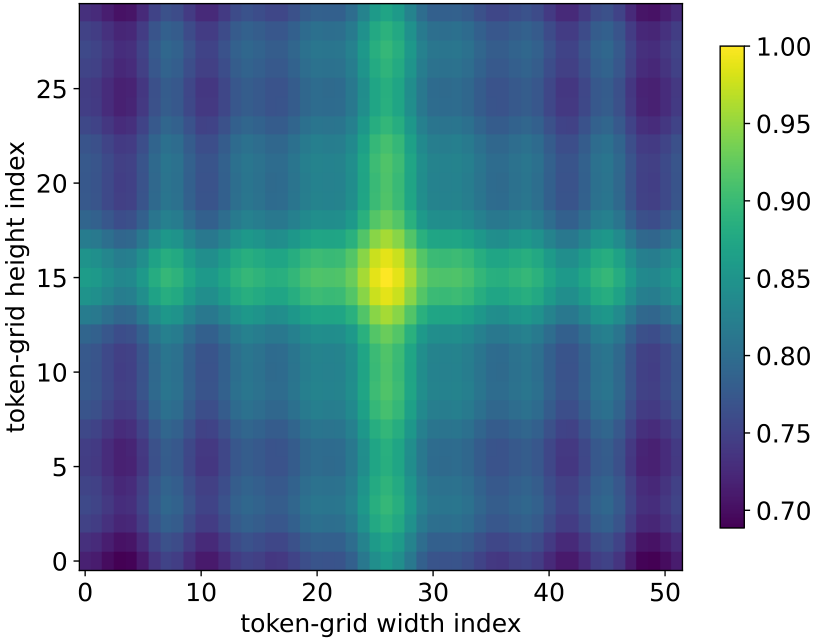
Figure 16 — RoPE의 공간 감쇠 효과 시각화
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LumosX: Relate Any Identities with Their Attributes for Personalized Video Generation
- [논문리뷰] Yume-1.5: A Text-Controlled Interactive World Generation Model
- [논문리뷰] Attention Illuminates LLM Reasoning: The Preplan-and-Anchor Rhythm Enables Fine-Grained Policy Optimization
- [논문리뷰] DF26: We Cannot Tell Fake From Real Anymore
- [논문리뷰] Encoded Early, Used Late: Where Transformers Begin to Act on an Inferred Partner's Expertise
Review 의 다른글
- 이전글 [논문리뷰] VideoGen-Agent: Reinforcing Video Generation Agents
- 현재글 : [논문리뷰] Why Do Video Diffusion Models Violate Physics? Unveiling the Flaws in Attention Mechanisms
- 다음글 [논문리뷰] WorldCrafter: Consistent Video World Model with Implicit 3D-aware Memory
댓글