[논문리뷰] The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement
링크: 논문 PDF로 바로 열기
메타데이터
저자: Yi Duan, Ying Liu, Zirui Tang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- RSI (Recursive Self-Improvement): AI 시스템이 자신의 한계를 스스로 식별하고, 개선 사항을 개발 및 검증하며, 그 과정에서 얻은 역량을 활용해 개선 프로세스 자체를 재귀적으로 향상시키는 자율적 폐쇄 루프 시스템입니다.
- Autonomy Levels (L1-L5): 개선 프로세스에서 AI가 담당하는 책임 범위에 따라 나눈 단계입니다. L1(개선 실행)부터 L5(메타 개선)까지 단계적으로 AI의 자율성이 확대됩니다.
- HCI (Headroom-Closed Index): 기존 LLM이 가진 성능의 한계와 개발 파이프라인의 효율성을 평가하여, 모델 개선 과정의 문제를 드러내는 지표입니다.
- Improvement Loop: AI가 데이터를 통해 개선을 시도하고 검증 후 이를 지속 가능한 역량으로 전환하는 일련의 순환 과정을 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 현대의 Foundation Model 개발 과정에서 발생하는 극심한 확장 비용과 병목 현상을 해결하기 위해 RSI의 개념을 정립하고 그 실현 가능성을 고찰합니다. 기존의 모델 개발은 데이터 준비, 아키텍처 설계, 평가 등 모든 단계에서 인간의 개입이 필수적인 선형적이고 비용 집약적인 과정입니다 [1.1절]. 이러한 구조는 개발 규모가 커질수록 인간의 조정 능력에 한계를 초래하며, 시스템이 지속적으로 진화하는 데 방해가 됩니다. 저자들은 인간의 개입을 줄이고 AI가 스스로 진화하는 RSI로의 패러다임 전환이 필요하다고 주장하며, 이를 위한 체계적인 자율성 프레임워크를 제안합니다 [Figure 1].
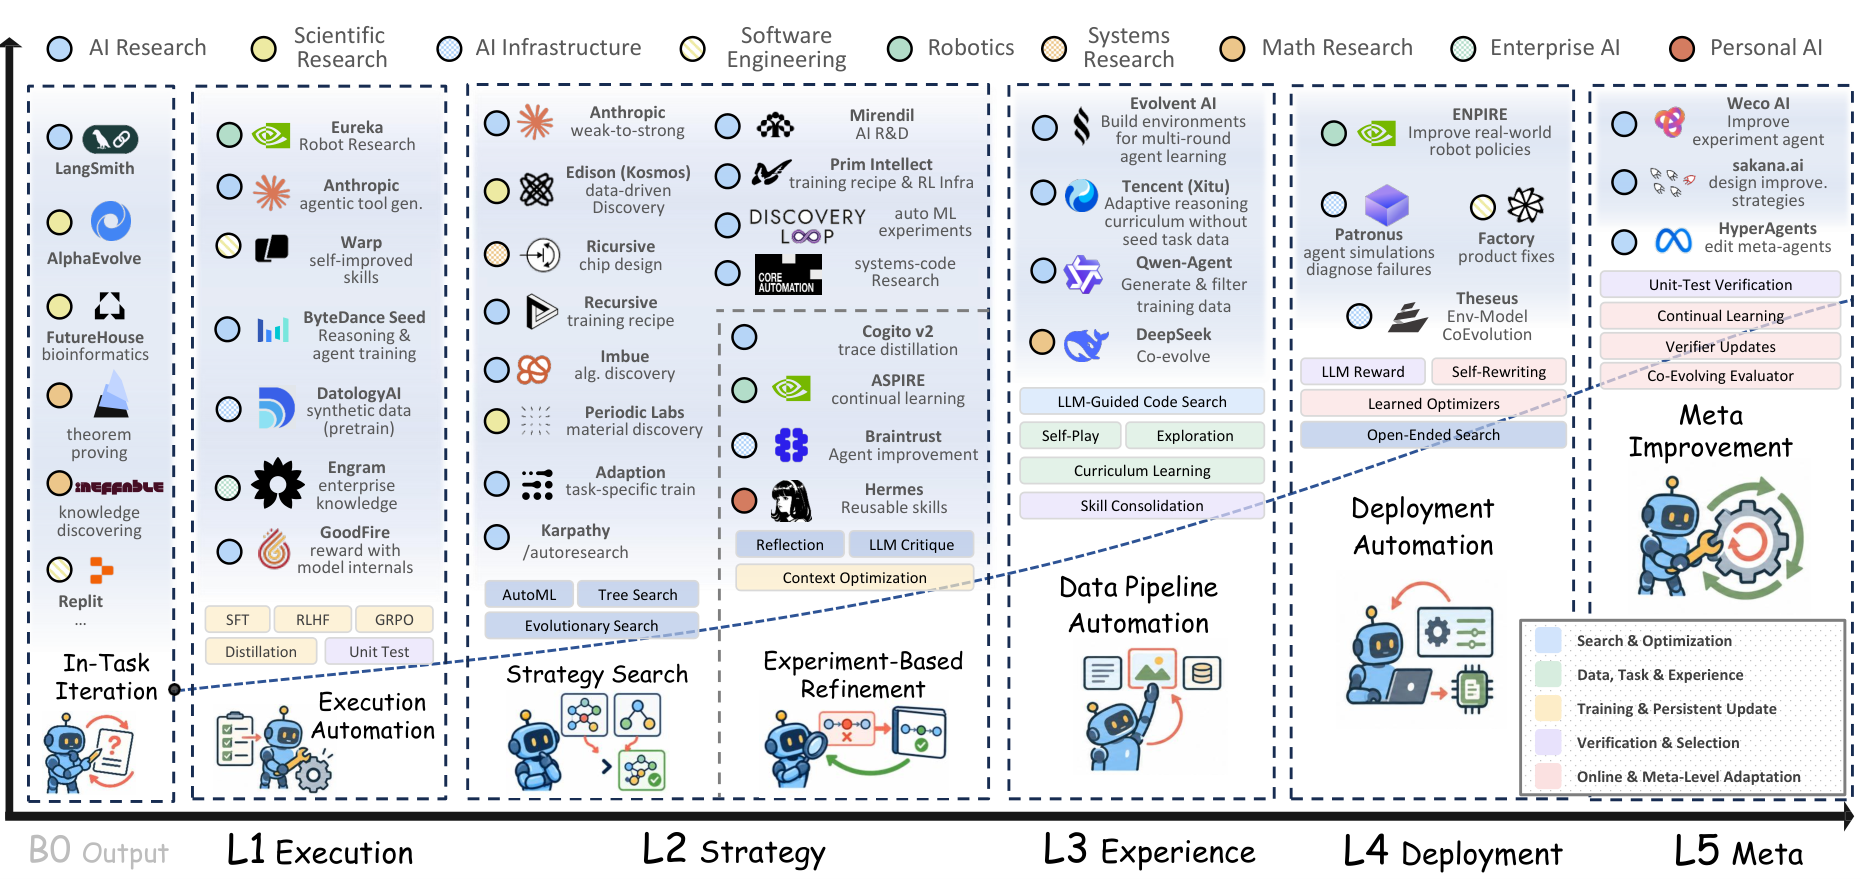
Figure 1 — RSI 5단계 자율성 및 시스템 구조
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 개선의 책임 범위에 따른 5단계 자율성 프레임워크를 제안하며, 각 단계에서 AI가 개선 루프의 더 많은 부분을 내재화하도록 설계합니다 [Figure 2].
- L1~L2: 시스템이 인간이 지정한 개선을 실행하거나(L1), 고정된 목표 내에서 스스로 개선 전략을 탐색(L2)하는 단계입니다.
- L3~L4: 학습 데이터나 경험을 스스로 확보하고(L3), 배포된 환경에서의 피드백을 통해 상태를 적응적으로 수정(L4)합니다.
- L5 (Recursive Meta-Improvement): 시스템이 개선 프로세스 자체(improver, verifier 등)를 수정하여, 다음 세대 개선 루프의 효율성을 높이는 가장 높은 자율성 단계입니다.
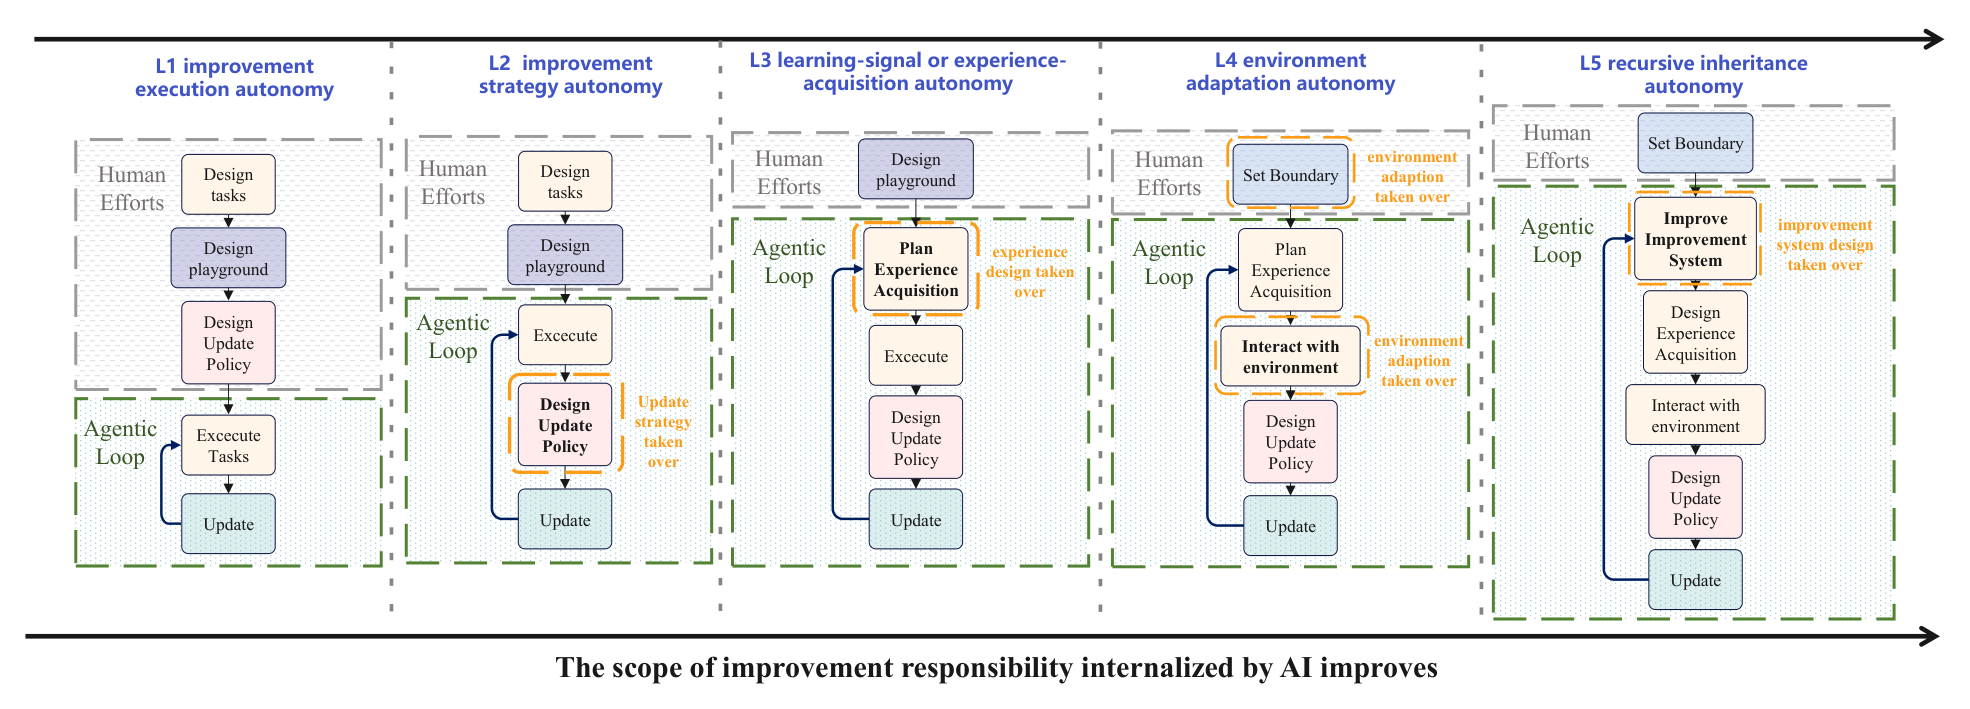
Figure 2 — 단계별 RSI 개선 루프 구조
저자들은 A-Evolve-Training과 같은 사례를 통해, 연구 정책을 스스로 수정하고 다음 학습 라운드에 적용했을 때 30B Nemotron 모델 기준 외부 점수가 0.80에서 0.86으로 상승하여 인간 전문가의 기록(0.87)에 근접했음을 보였습니다 [1.2절]. 또한, 다양한 도메인(과학, 로봇공학, 소프트웨어 엔지니어링 등)에서의 피드백 regimes을 비교하여, 루프 내에서 어떻게 개선 사항이 유지(persist)되고 검증되는지가 RSI 성공의 핵심임을 실증했습니다 [1.5절].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 AI 시스템이 단순히 성능을 높이는 단계를 넘어, 개선 프로세스 자체를 재귀적으로 향상시키는 RSI 시대의 청사진을 제시합니다. 이러한 연구는 AI 개발의 '인간 의존성'을 줄이고, 보다 자율적이며 지속 가능한 모델 진화 체계를 구축하는 데 기여할 것으로 기대됩니다. 다만, 자율적 개선 과정에서의 '오류 유전' 및 '평가 exploitation' 문제 등 안전하고 신뢰할 수 있는 RSI 구현을 위한 향후 과제들이 여전히 남아 있습니다. 이 프레임워크는 향후 연구자들이 AI 에이전트의 자율성을 측정하고 설계하는 데 있어 표준적인 가이드라인을 제공할 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Agentic Discovery of Neural Architectures: AIRA-Compose and AIRA-Design
- [논문리뷰] RayOrch: Programming and Executing Lineage-Controlled Multi-Grain Dataflows for Foundation-Model Data Preparation
- [논문리뷰] Recursive self-improvement of AI research agents
- [논문리뷰] OmniEdu: Open Foundation Models for Learning and Teaching
- [논문리뷰] Grounded Action Model: 3D Grounding as a Foundation for Robotics
Review 의 다른글
- 이전글 [논문리뷰] StepAudio 3 Realtime Technical Report
- 현재글 : [논문리뷰] The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement
- 다음글 [논문리뷰] The Router Within: Eliciting Native Skill Routing from a Frozen LLM
댓글