[논문리뷰] Grounded Action Model: 3D Grounding as a Foundation for Robotics
링크: 논문 PDF로 바로 열기
저자: Gehao Zhang, Weikai Huang, Shailesh Shailesh, Yiyan Peng, Jiafei Duan, Ranjay Krishna
1. Key Terms & Definitions (핵심 용어 및 정의)
- Grounded Action Models (GAMs): 3D Grounding을 기반으로 구축된 새로운 패러다임의 로봇 Foundation Model로, task-relevant object와 그들의 metric 3D geometry를 명시적으로 식별한다.
- 3D Grounding: Visual observation 및 task prompt를 metric 3D 공간 내의 object에 연결하는 프로세스로, "어떤 object가 중요한지, 어디에 있는지, 어떤 geometry를 차지하는지"에 대한 명시적인 정보를 제공한다.
- Vision-Language-Action Models (VLAs): Pretrained vision-language backbone을 로봇 제어에 적용하는 로봇 Foundation Model이다.
- World-Action Models (WAMs): Pretrained video-generation backbone을 기반으로 구축된 로봇 Foundation Model이다.
- WildDet3D: 본 연구에서 채택된 promptable 3D grounding backbone으로, 3D box detection을 위해 훈련되었다.
- Multi-stream Transformer (MM-DiT): GAM의 action head 아키텍처로, 다양한 정보 stream을 결합하여 action prediction을 수행한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 로봇 Foundation Model들이 metric grounding 능력이 부족하여 manipulation generalization에 한계를 가짐을 지적한다. Manipulation policy는 어떤 object가 중요하고 어디에 있는지 정확히 알아야 하지만, Vision-Language-Action Models (VLAs)나 World-Action Models (WAMs)와 같은 현재 로봇 Foundation Model들이 기반으로 하는 pretrained backbone들은 이러한 explicit metric grounding을 직접적으로 요구하지 않으며, spatial information을 로봇 demonstration으로부터 implicitly하게 학습하도록 남겨둔다. 이러한 implicit grounding은 object가 이동하거나, 배경이 변하거나, 다른 target이 선택될 때 정책의 generalization 성능을 저하시키는 원인이 된다. Pretraining objective가 task-relevant object를 명시적으로 식별하고 그들의 geometry를 제어에 노출하는 representation을 보장하지 않기 때문에, 새로운 접근 방식이 필요하다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 3D grounding을 로봇 action learning의 foundation으로 제안하고, Grounded Action Models (GAMs)를 통해 이를 구현한다. GAM은 task prompt (language, 2D points, 2D boxes)와 현재 이미지를 받아, frozen 상태의 pretrained promptable 3D grounding backbone (WildDet3D)을 사용하여 task object를 식별하고 3D 공간에서 localize한다. 이 foundation은 object localization, visual features, 그리고 metric geometry를 action learner에게 명시적으로 제공하여, action policy가 grounded object를 조작하는 방법에 집중할 수 있게 한다. GAM은 object-centric observation을 위해 task object와 로봇 팔에 제한된 image tokens 및 각 object의 point cloud와 pose를 인코딩하는 detection tokens를 구성한다. 이러한 tokens는 로봇 state history와 함께 Multi-stream Transformer (MM-DiT)에 입력되어, absolute joint-position targets의 chunk를 예측한다. Action head는 flow matching을 통해 학습되며, grounding backbone은 policy training 동안 frozen 상태를 유지한다.
실험 결과는 GAM의 뛰어난 성능과 generalization 능력을 입증한다:
- RoboTwin 2.0 벤치마크: GAM은 50개 task에 걸쳐 평균 55.3%의 성공률을 달성하며, Spatial Forcing (52.0%)을 능가한다. 특히, randomized scene (Hard setting)에서 47.6%의 성공률을 기록하여, 다음으로 높은 VLA인 Abot-M0 (30.4%) 및 WAM인 X-WAM (25.8%) 대비 큰 폭으로 우수하며, clean-scene demonstration만으로 학습했음에도 불구하고 scene randomization에 대한 강력한 generalization을 보여준다.
- LIBERO-PRO 벤치마크: 16가지 perturbation setting에 걸쳐 평균 61%의 성공률을 달성하여 π0.5 (53%) 대비 state-of-the-art 성능을 보인다. Target object가 재배치되거나 (Pos) 새롭게 지정되는 (Task) 시나리오에서 특히 높은 성능 향상을 보이며, 예를 들어 Spatial-Pos에서 GAM은 0.60의 성공률을 보인 반면, 기존 best baseline은 0.26에 불과했다.
- 실제 로봇 실험: Bimanual YAM에서 visual shift가 있는 조건에서 GAM은 17/20 성공을 달성하여 π0.5 (4/20)보다 훨씬 높은 89%의 in-distribution 성능 유지율을 보였다. Franka 로봇에서의 long-horizon 및 memory-dependent task에서는 Molmo2 planner와 통합된 GAM 시스템이 in-distribution에서 64.7%, out-of-distribution (OOD)에서 49.8%의 step completion rate를 기록하며, OOD 조건에서 77%의 ID 성능 유지율을 달성했다. 이는 π0.5의 57% 및 MolmoAct2의 48% 유지율보다 현저히 높은 수치이다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 pretrained promptable 3D detector를 통해 task specification을 action prediction에 연결하는 Grounded Action Model (GAM)을 성공적으로 제안하였다. GAM은 object-centric visual 및 metric representation을 활용하여 scene variation에 강건한 manipulation과 relocated 또는 newly designated target에 대한 뛰어난 generalization 성능을 제공한다. 또한, language, 2D points, 2D boxes를 지원하는 unified interface를 통해 인간의 직접적인 target selection과 planner-driven long-horizon 및 memory-dependent manipulation을 실제 로봇에서 성공적으로 지원함을 입증하였다. 이러한 결과들은 3D grounding이 task-relevant spatial changes에 민감하게 반응하면서도 시각적 변화에 강건한 manipulation policy 개발을 위한 유망한 foundation임을 시사한다.
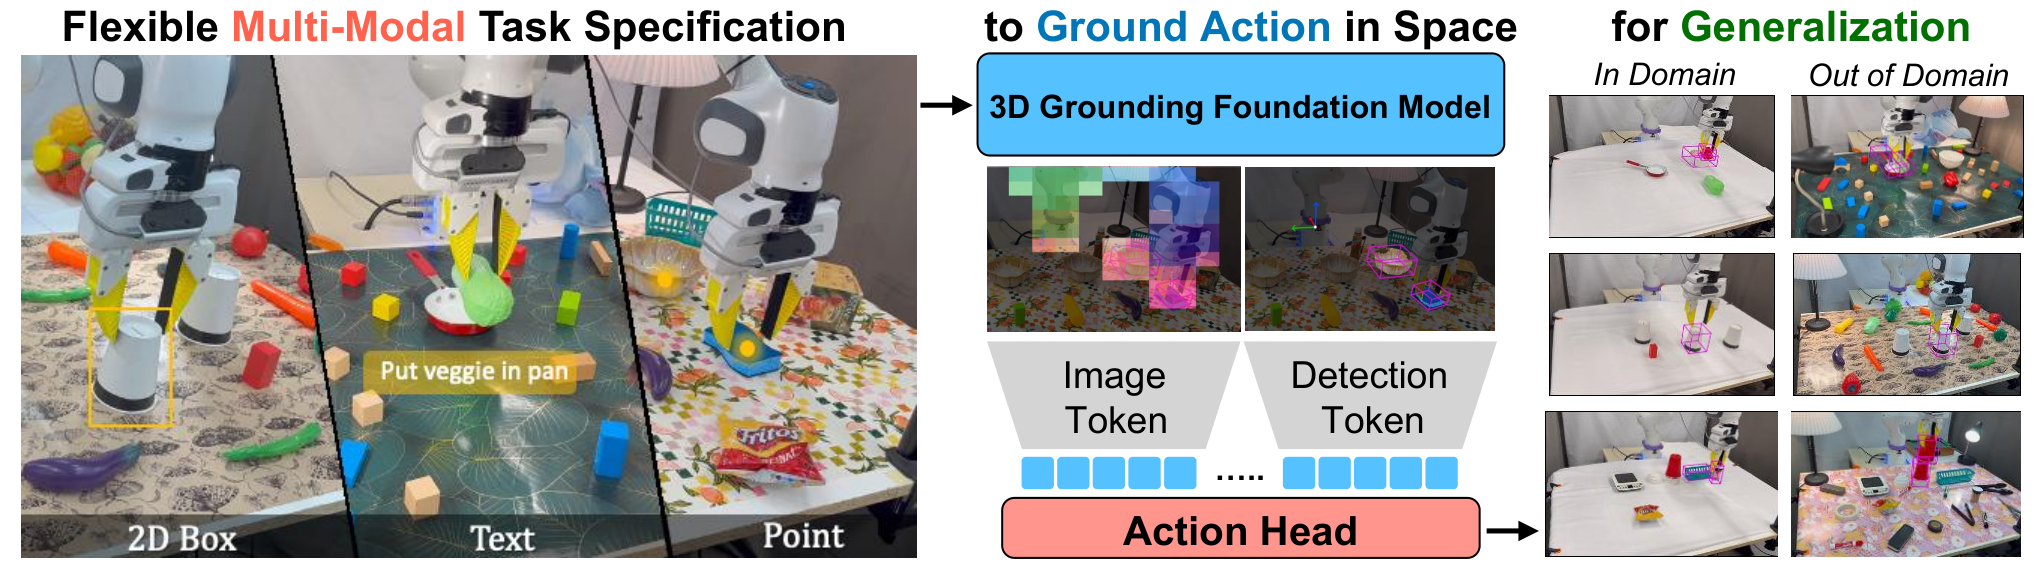
Figure 1 — 로봇 액션 학습의 3D Grounding
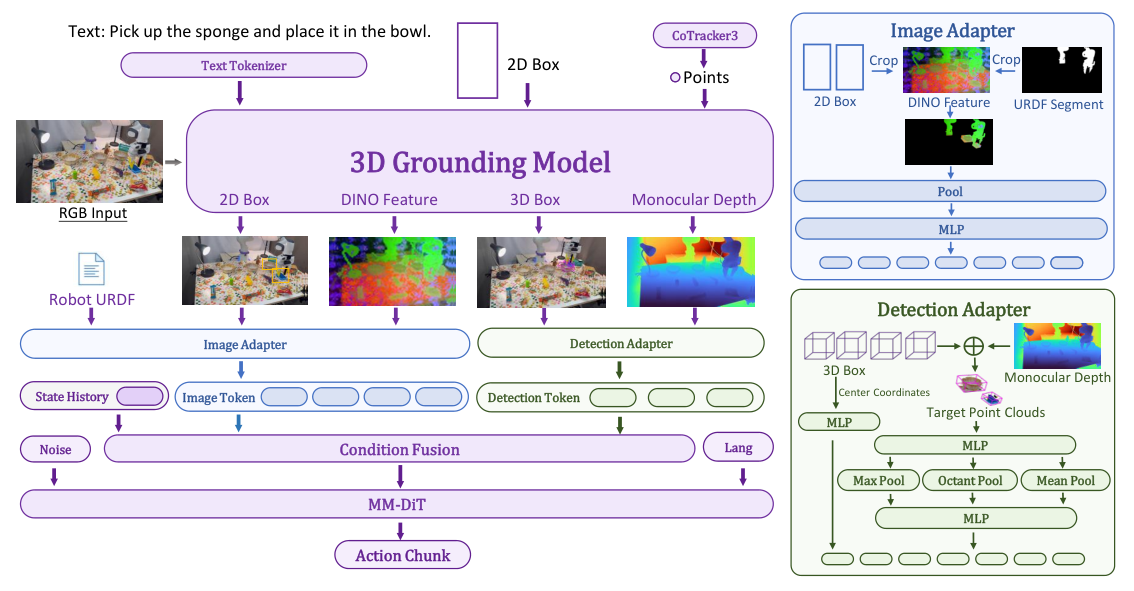
Figure 2 — GAM 아키텍처
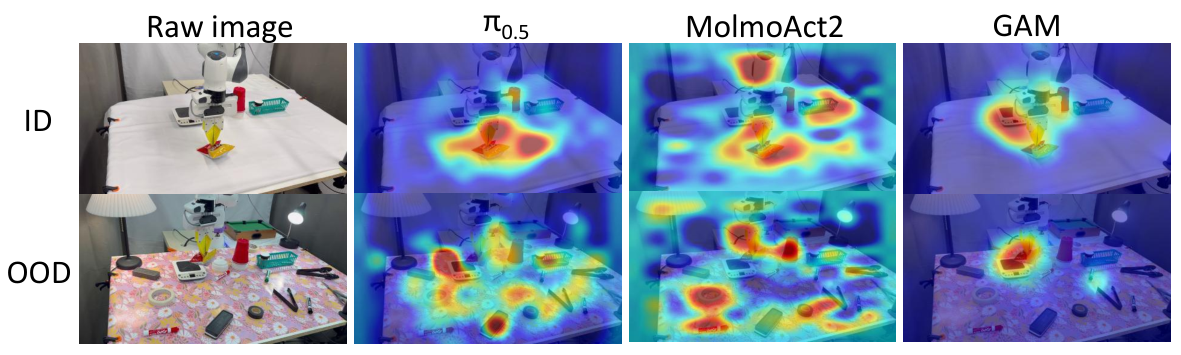
Figure 4 — 분포 변화 시 어텐션
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Data Pyramid for Embodied Manipulation
- [논문리뷰] VLANeXt: Recipes for Building Strong VLA Models
- [논문리뷰] Ground Slow, Move Fast: A Dual-System Foundation Model for Generalizable Vision-and-Language Navigation
- [논문리뷰] Harnessing CLIP and DINO: An Uncertainty-Aware Cascaded Fusion Network for Generalizable Deepfake Image Detection
- [논문리뷰] Beyond Data Scaling: Representation-Centric Continued Pre-training for Vision-Language-Action Models
Review 의 다른글
- 이전글 [논문리뷰] GameHorizon Suite: Multi-Horizon Data and Evaluation in Gameplay
- 현재글 : [논문리뷰] Grounded Action Model: 3D Grounding as a Foundation for Robotics
- 다음글 [논문리뷰] Harness-Zero: Harness Distillation via Agent-as-Harness
댓글