[논문리뷰] GameHorizon Suite: Multi-Horizon Data and Evaluation in Gameplay
링크: 논문 PDF로 바로 열기
저자: Yiran Wang, Xingyilang Yin, Junfu Pu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Multi-Horizon Instructions: 게임 플레이 태스크를 다양한 시간 스케일로 정의한 계층적 명령어 집합으로, short-horizon operations (L1), medium-horizon goals (L2), 그리고 long-horizon strategies (L3)를 포함한다.
- GameHorizon-Annotator: 게임 플레이 비디오와 플레이어 액션으로부터 multi-horizon instructions를 자동으로 생성하는 확장 가능하고 자동화된 주석 파이프라인이다.
- GameHorizon-Data: GameHorizon-Annotator를 통해 구축된 대규모 AAA gameplay 데이터셋으로, temporally aligned된 비디오, 플레이어 액션, 그리고 multi-horizon instructions를 포함한다.
- GameHorizon-Bench: 다양한 모델 패밀리의 게임 플레이 능력을 평가하기 위한 통합 벤치마크 스위트로, 재현 가능한 offline evaluation과 단계별 stepwise online testing을 제공한다.
- AAA Games: 높은 개발 비용과 마케팅 예산을 가진 대형 비디오 게임 타이틀을 지칭하며, 복잡한 환경과 다양한 플레이 메커니즘을 특징으로 한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 현대 비디오 게임 환경에서 AI 모델의 복합적인 능력(시각적 이해, 명령어 분해, 목표 계획, 정밀한 액션 제어)을 평가하는 데 있어 기존 데이터셋과 벤치마크의 한계를 해결하고자 한다. 기존 연구들은 주로 협소한 범위의 게임만을 다루거나 (Minecraft, GameWorld, WildWorld 등), 언어 명령어가 부족하거나 (NitroGen, GameVerse, Open-P2P 등), 또는 높은 분산(variance)을 가지는 온라인 롤아웃(rollouts)에 의존하는 문제점을 가지고 있다. 특히, 대부분의 전용 게임 에이전트(dedicated game agents)는 고주파 액션 제어에 최적화되어 장기적인 계획 및 추론 능력이 부족하며, 범용 모델(general-purpose models)은 계획 능력은 뛰어나지만 체계적인 액션 실행 평가가 이루어지지 않고 있다. 또한, 기존 벤치마크들은 소규모 샘플로 인해 신뢰도가 낮고, 특정 게임 환경이나 에이전트 하네스(harnesses)에 민감하여 재현성이 떨어지며, 총체적인 성공률(aggregate success rate)만 제공하여 실패 모드를 세분화하지 못하는 한계가 있다. 따라서 저자들은 비전, 실행 가능한 액션, 그리고 다중 시간 스케일의 자연어 목표를 통합적으로 측정할 수 있는 단일의 표준화된, 저비용이며 재현 가능한 평가 기준의 필요성을 강조한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 다양한 모델 패밀리에 걸쳐 멀티-호라이즌 게임 플레이 능력을 측정하는 통합 데이터 및 평가 스위트인 GameHorizon Suite를 제안한다 [Figure 2, cite: 1]. 이 스위트는 GameHorizon-Annotator, GameHorizon-Data, 그리고 GameHorizon-Bench 세 가지 핵심 구성 요소로 이루어져 있다 [Figure 2, cite: 1, 3].
먼저, GameHorizon-Annotator는 확장 가능하고 자동화된 멀티-호라이즌 명령어 주석 파이프라인이다 [Figure 3, cite: 1, 3]. 이 파이프라인은 Action-Aware Video Segmentation을 통해 비디오를 short-horizon clips (L1)으로 분할하고, 이를 VLM(Vision-Language Model)으로 주석 처리한 후, Bottom-Up Temporal Merging을 통해 medium-horizon goals (L2)와 long-horizon strategies (L3)로 점진적으로 병합한다 [Figure 3, cite: 1, 3]. 이 bottom-up 방식은 기존의 수동 주석의 비효율성을 극복하며, L1 (1-5초), L2 (1-2분), L3 (5-8분) 범위의 시간적 길이를 가지는 명령어를 생성한다.
다음으로, GameHorizon-Annotator를 활용하여 저자들은 GameHorizon-Data를 구축했다. 이 데이터셋은 21개의 AAA 게임 타이틀에서 100명의 인간 전문 플레이어가 수집한 5,000시간의 게임 플레이 녹화본으로 구성되며, 시간적으로 정렬된 비디오, 플레이어 액션, 그리고 멀티-호라이즌 명령어를 제공한다. 전체적으로 4억 1,103만 개의 키보드-마우스 액션 이벤트와 6,184,036개의 고유한 명령어가 포함되어 있으며, 각 프레임은 세 가지 호라이즌의 명령어로 밀도 있게 주석 처리되어 있다. 평균 명령어 지속 시간은 L1이 2.63초, L2가 82.6초, L3가 330.4초이다.
마지막으로, GameHorizon-Data를 기반으로 GameHorizon-Bench를 개발했다. 이 벤치마크는 재현 가능한 offline evaluation과 단계별 stepwise online testing을 통합한다 [Figure 4, Figure 5, cite: 1, 4, 5]. Offline track은 Single-horizon action (T1), Multi-horizon instruction decomposition (T2), Cross-horizon consistency (T3)의 세 가지 주요 태스크와 진단용 변형 태스크(variant tasks)로 구성된 수천 개의 Multiple-Choice Questions (MCQs)를 통해 표준화된 평가를 제공한다 [Figure 4, cite: 1, 4]. Online track은 장기적인 게임 플레이 능력을 평가하기 위해 순서 의존적인 causal tasks와 순서 유연한 thematic tasks로 이루어진 단기 서브태스크(short-horizon subtasks)를 사용하며, 환경 리셋을 통해 실패 지점을 정확히 찾아낼 수 있다 [Figure 5, cite: 1, 5].
실험 결과, GameHorizon-Bench는 47개 모델을 대상으로 1백만 건 이상의 모델 호출을 통해 평가되었으며, 평균 정확도는 64.7%로, 25%의 무작위 기준보다 훨씬 높았다. 태스크 난이도 계층은 T1 (57.3%) < T2 (65.1%) < T3 (71.6%) 순으로 나타났으며, GPT-6-Astra가 80.2%의 종합 정확도로 최고 성능을 기록했다. 특히, 멀티-호라이즌 명령어를 통합하면 비전 전용 입력 대비 미래 액션 계획(future-action planning) 정확도가 7.2%p 향상되어, 제안된 명령어의 효과를 입증했다. 또한, online track 결과는 offline scores와 긍정적인 상관관계를 보여, offline track이 실제 게임 플레이 능력을 효과적으로 예측함을 시사한다. 사고(thinking) 기능을 활성화했을 때, GLM-5V-Turbo와 Doubao-Seed-2.1-Pro와 같은 고성능 모델은 T2 태스크에서 각각 +5.6%p 및 +9.3%p의 정확도 향상을 보였으나, 경량 모델에서는 hallucinated reasoning으로 인해 성능이 저하되었다. 액션 디코딩(action decoding) 오류는 미미하여 (0.6%p 감소), 현재 모델의 주요 병목 현상이 목표 계획 및 정렬에 있음을 밝혔다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 GameHorizon Suite를 통해 다양한 모델 패밀리와 AAA 게임 환경에서 멀티-호라이즌 게임 플레이 능력을 체계적으로 평가하기 위한 통합적인 접근 방식을 제시한다. GameHorizon-Annotator는 스케일러블한 방식으로 Dense한 멀티-호라이즌 명령어 피라미드를 구축하며, 이를 통해 생성된 GameHorizon-Data는 21개의 AAA 게임에 걸쳐 대규모의 정렬된 비디오, 액션, 그리고 멀티-호라이즌 명령어를 제공한다. 또한, GameHorizon-Bench는 재현 가능한 offline evaluation과 단계별 stepwise online testing을 결합하여 모델 간의 표준화된 비교와 세분화된 실패 진단(failure diagnosis)을 가능하게 한다. 이러한 연구는 현재 모델들의 역량 차이와 주요 병목 현상을 명확히 밝혀냈으며, 학계와 산업계에서 복잡하고 인터랙티브한 환경에서 AI를 발전시키는 데 중요한 데이터 기반과 통합된 평가 기준을 제공할 것으로 기대된다.
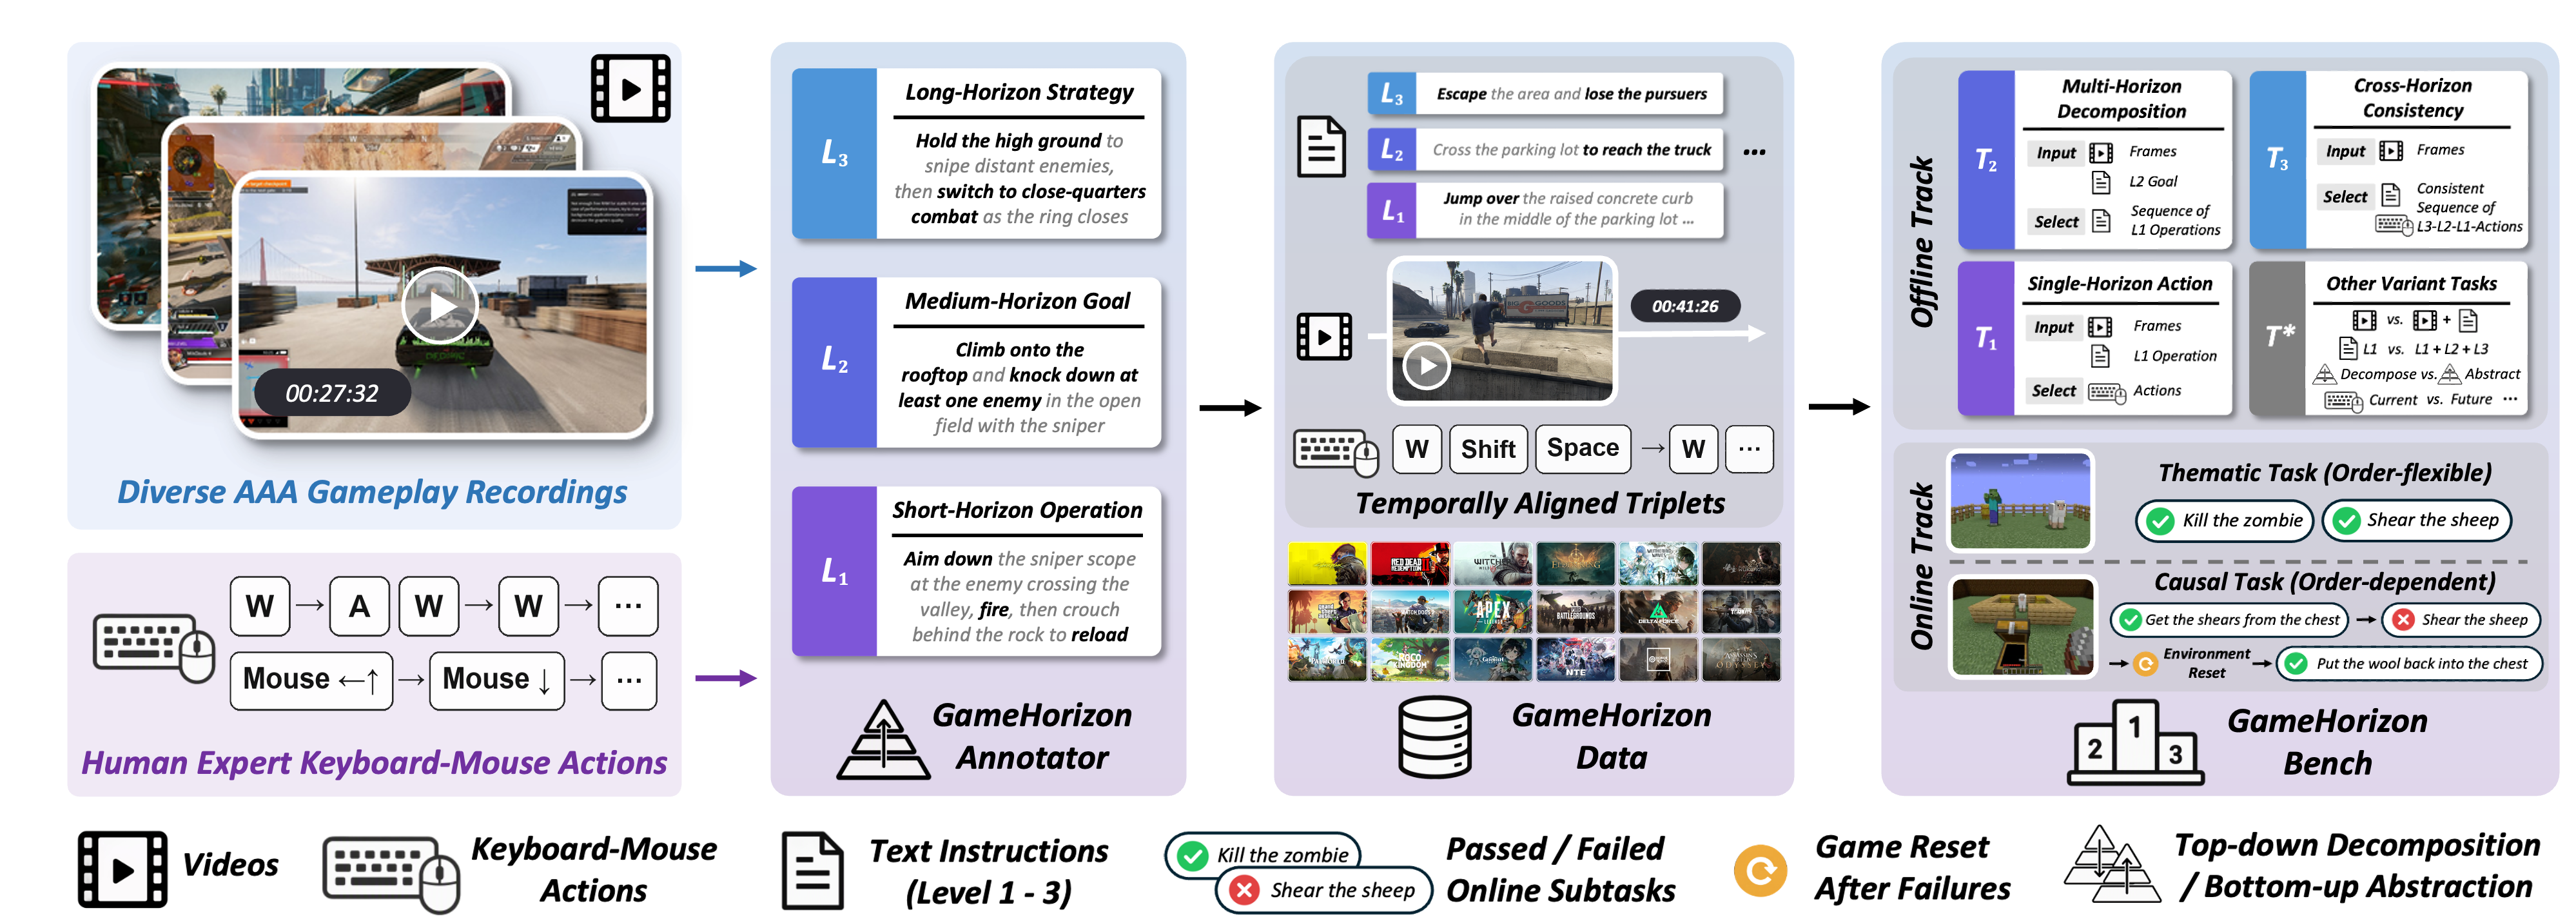
Figure 2 — GameHorizon Suite 개요
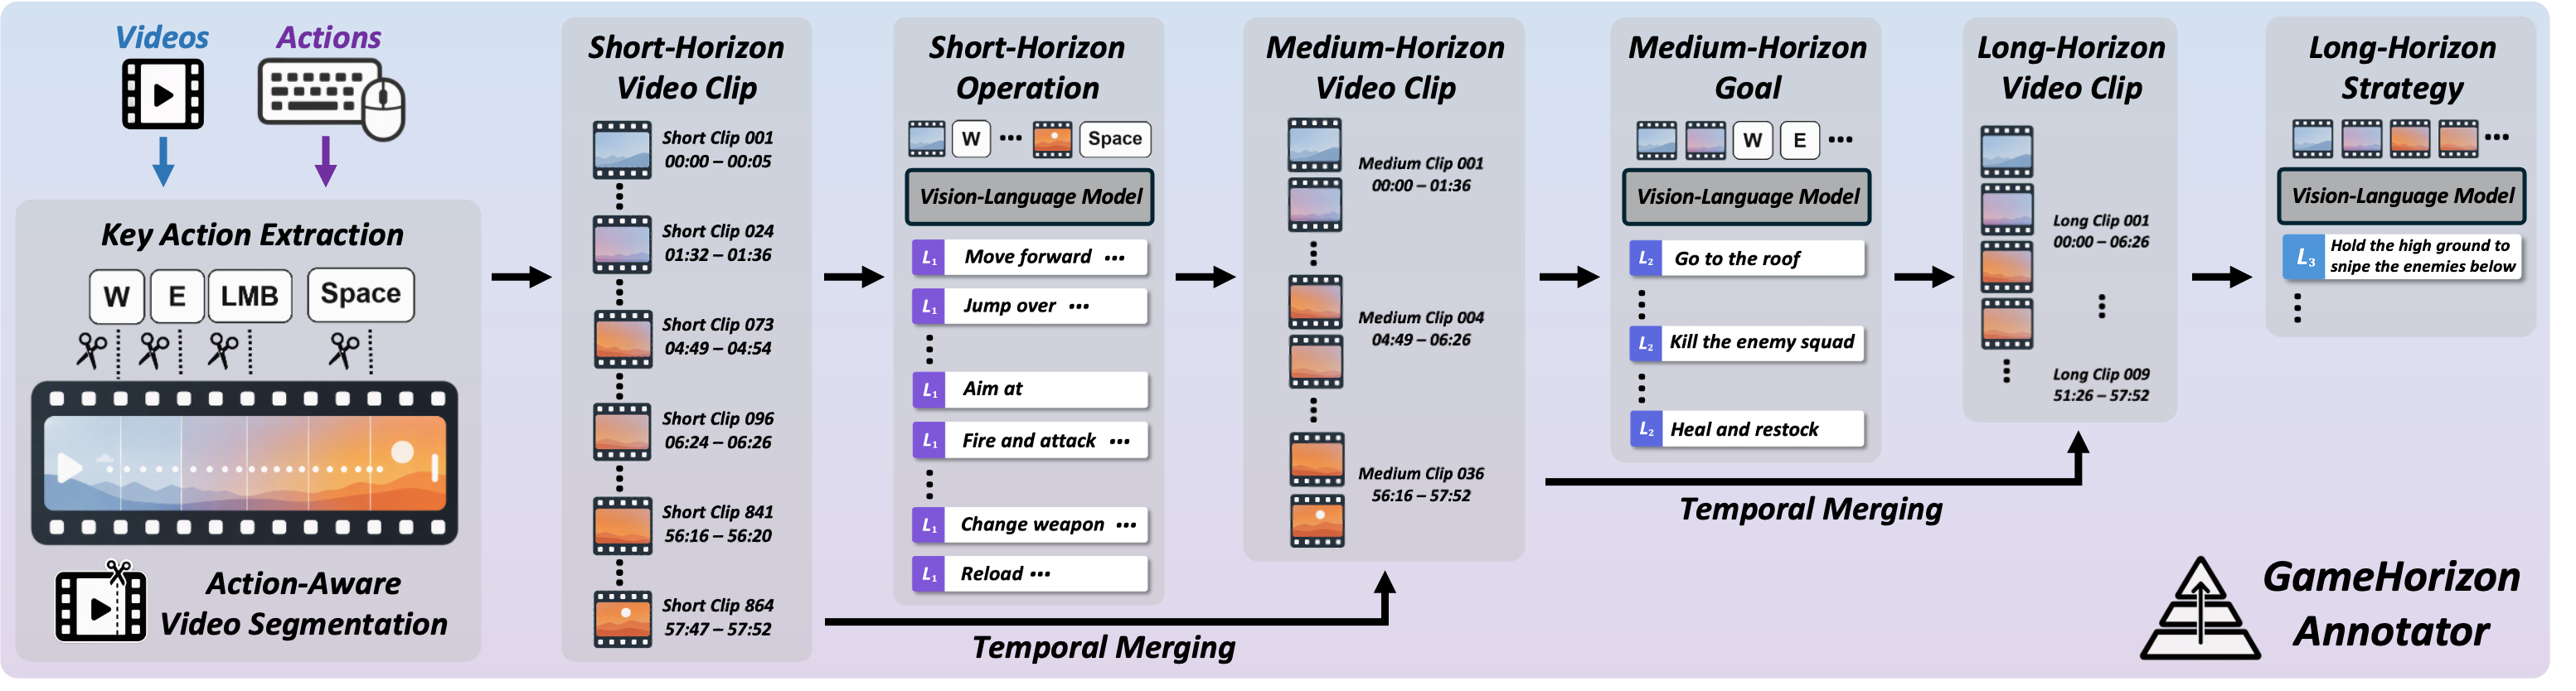
Figure 3 — Annotator 워크플로우
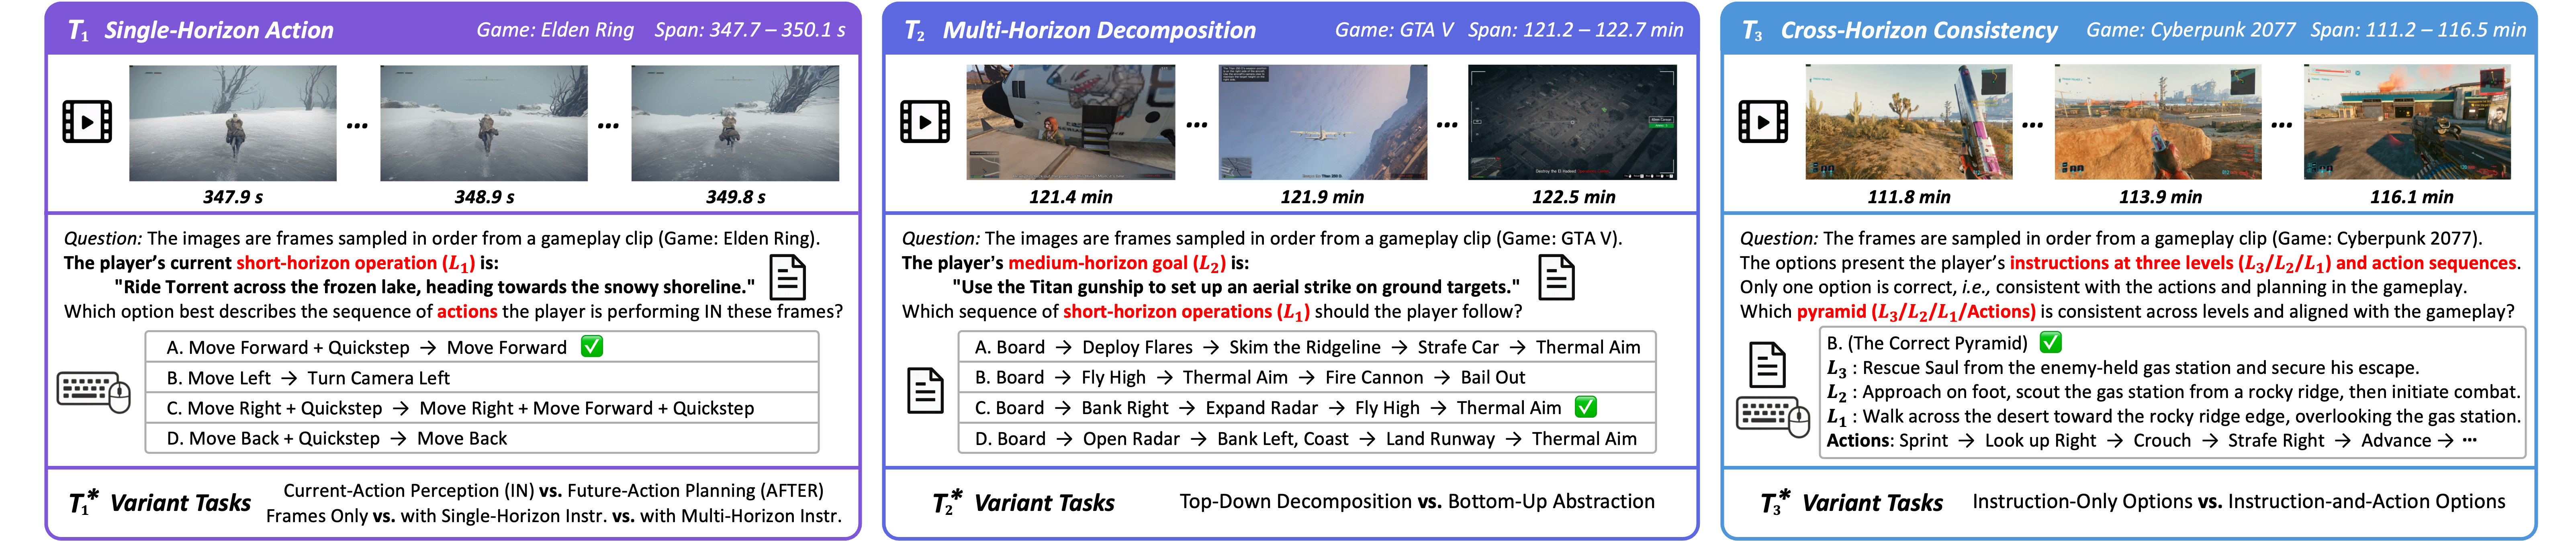
Figure 4 — Offline 벤치마크 태스크
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Principia: Relational Physics Tests for Video Models
- [논문리뷰] RobotValues: Evaluating Household Robots When Human Values Conflict
- [논문리뷰] Benchmarking Composed Image Retrieval for Applied Earth Observation
- [논문리뷰] MemEye: A Visual-Centric Evaluation Framework for Multimodal Agent Memory
- [논문리뷰] DeepImageSearch: Benchmarking Multimodal Agents for Context-Aware Image Retrieval in Visual Histories
Review 의 다른글
- 이전글 [논문리뷰] EDGEGEN: Improving Tool-Calling Agents Beyond Happy Paths with Synthetic Edge Case Generation
- 현재글 : [논문리뷰] GameHorizon Suite: Multi-Horizon Data and Evaluation in Gameplay
- 다음글 [논문리뷰] Grounded Action Model: 3D Grounding as a Foundation for Robotics
댓글