[논문리뷰] OmniHarness: Harnessing Generalizable Visual Generation via Symbolic Policy Learning
링크: 논문 PDF로 바로 열기
저자: Xu Xu, Jinxiu Liu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- MLLMs (Multimodal Large Language Models): 텍스트와 이미지 등 여러 모달리티 데이터를 이해하고 생성하는 대규모 언어 모델.
- Symbolic Policy Learning: 검증된 실행(executions) 경험을 추상화하여 시각 생성 태스크 패밀리에 재사용 가능한 symbolic policies로 변환하는 학습 메커니즘.
- Self-Directed Inquiry: 다운스트림 목표가 명시되기 전에 시스템이 자율적으로 연습 태스크(practice tasks)를 생성하고 실행하여 자신의 역량 한계를 탐색하고 정책 학습을 위한 경험을 축적하는 과정.
- Feedback-Guided Execution: 실행 중 발생하는 중간 결과(intermediate outputs)에 대한 검증(verification)을 통해 워크플로우(workflow)를 정교화하고 실패를 복구하는 메커니즘.
- ComfyBench: 자율적인 ComfyUI 워크플로우 구성 및 실행 능력을 평가하는 벤치마크.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 MLLMs 및 multi-agent systems의 시각 생성(visual generation) 역량을 일반화 가능하고(generalizable), 실행 중 자체 수정(self-correction)하며, 사전 탐색적 학습(proactive learning)을 가능하게 하는 프레임워크인 OmniHarness를 제안합니다. 기존 방법론들은 세 가지 주요 한계를 가집니다. 첫째, 기존 MLLMs는 제한된 Generalizability를 가진 태스크별 경험(task-specific experience)을 주로 학습하며 [Figure 2(a)], 복잡한 추론 태스크에서 어려움을 겪을 수 있습니다. 둘째, 기존 multi-agent systems은 Reflection이 태스크 완료 후에야 이루어지므로 중간 단계의 오류 전파(error propagation)를 막기 어렵습니다 [Figure 2(b)]. 셋째, 지식(knowledge) 습득이 다운스트림 태스크 요구에 반응적으로 이루어져 잠재적인 역량 격차(capability gaps)가 발생합니다. 이러한 한계는 시스템이 개별 사례를 넘어 일반화하고, 행동하면서 Reflection하며, 자기 주도적 탐색을 통해 학습하는 방안을 모색하게 합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 일반화 가능한 시각 생성을 위해 Symbolic Policy Learning 기반의 OmniHarness 프레임워크를 제안합니다. [Figure 3]에서 볼 수 있듯이, OmniHarness는 Self-Directed Inquiry와 Feedback-Guided Execution을 통합하여 재사용 가능한 symbolic policies를 학습합니다. Self-Directed Inquiry 단계에서는 시스템이 자체 역량 공간(capability space)을 탐색하며 연습 태스크를 자율적으로 생성하고 실행합니다. 이때, Capability Novelty와 Competence Frontier Score를 기준으로 학습 가능한 새로운 태스크를 우선적으로 선택합니다. [Figure 2(c)]에서와 같이, Feedback-Guided Execution은 계획(planning), Code-as-Policy 합성, 실행, 중간 검증(intermediate verification) 및 국소적 복구(localized recovery) 과정을 포함하며, 각 단계에서 오류를 식별하고 수정하여 오류 전파를 제한합니다. 성공적으로 검증된 실행은 workflow library에 symbolic policies로 추상화되어 저장되며, 실패 사례는 failure library에 기록되어 재사용 가능한 교정 전략(corrective strategies)으로 활용됩니다.
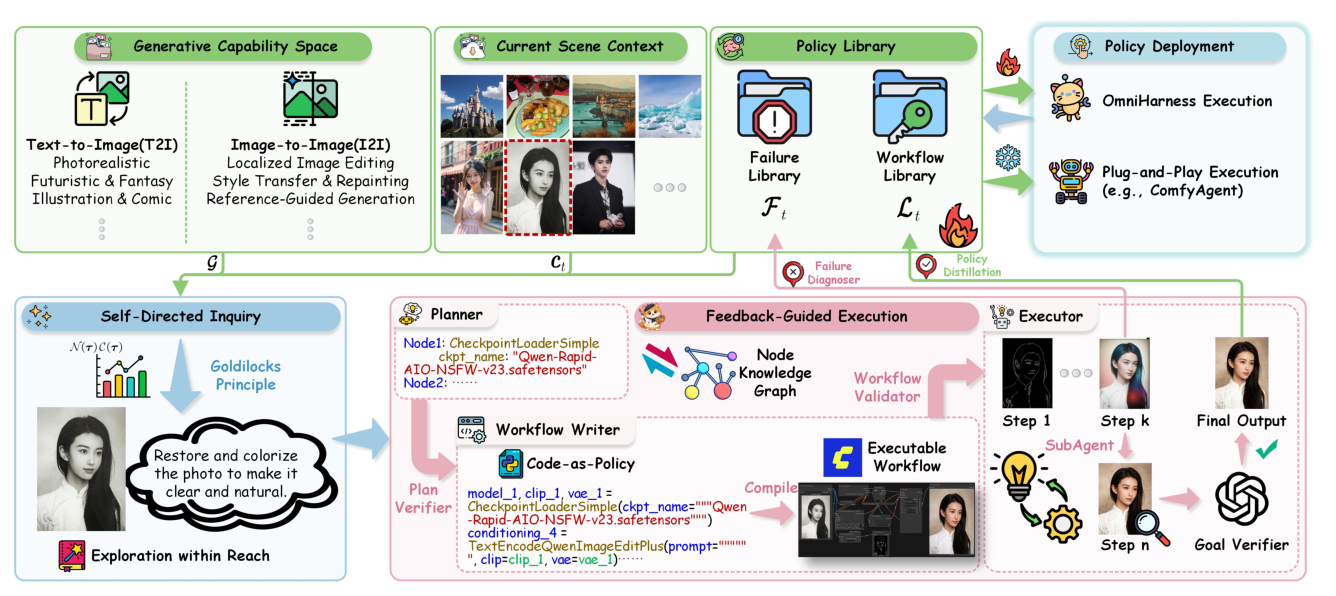
Figure 3 — OmniHarness의 내부 구성 요소와 Self-directed inquiry 및 Feedback-guided execution의 작동 방식을 상세히 보여주는 핵심 아키텍처 다이어그램.
실험 결과, OmniHarness는 다양한 시각 생성 벤치마크에서 뛰어난 성능과 지속적인 역량 확장(continual capability expansion)을 입증했습니다. ComfyBench [Table 1]에서 OmniHarness는 Creative 태스크에서 95.0%의 Resolve rate를 달성하여 가장 강력한 Baseline 대비 27.5 percentage points를 초과하는 성능을 보였습니다. Total Resolve rate는 GPT-4o + OmniHarness가 89.5%, Codex GPT-4o + OmniHarness가 92.5%를 기록했습니다. 특히, self-directed inquiry를 제거했을 때 Creative Total Resolve는 95.0%에서 72.5%로 크게 감소하여 사전 정책 학습의 중요성을 강조했습니다 [Table 6]. 또한, Reason-Edit 벤치마크 [Table 5]의 Understanding Scenarios에서 OmniHarness는 PSNR 23.89 dB, SSIM 0.86, LPIPS 0.05, CLIP Score 24.55로 모든 4가지 Metric에서 선두를 차지했습니다.
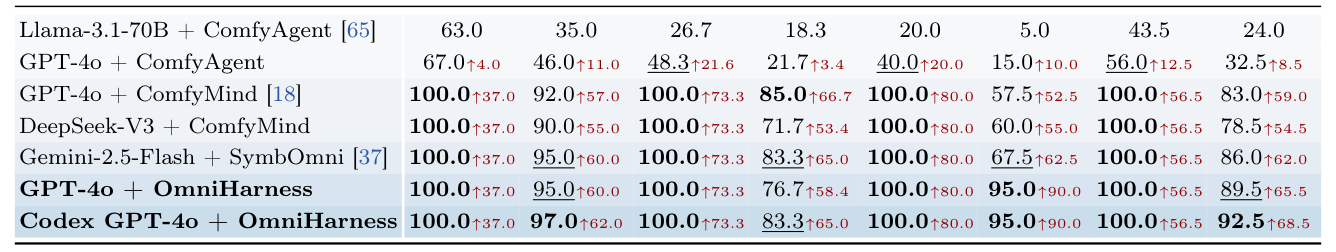
Table 1 — ComfyBench 벤치마크에서 OmniHarness의 정량적 성능(Pass↑, Res.↑)을 다양한 Baseline 및 Reasoning Agent와 비교한 핵심 결과 테이블.
4. Conclusion & Impact (결론 및 시사점)
OmniHarness는 시각 Agent들이 태스크 전반에 걸쳐 일반화하고(generalize across tasks), 실행 중 오류를 수정하며(correct errors during execution), 새로운 태스크 요구가 발생하기 전에 학습할 수 있도록 하는 강력한 프레임워크입니다. Symbolic policy learning을 통해 검증된 실행을 재사용 가능한 정책으로 추상화하고, feedback-guided execution으로 중간 검증 및 국소적 복구를 수행합니다. 또한, self-directed inquiry를 통해 다운스트림 목표 없이도 사전에 정책을 습득하며, 모델 파라미터를 고정(fixed)한 채 실행 Feedback을 통해 지속적으로 정책을 개선합니다. 이 연구는 기존 시각 Agent 시스템의 Generalizability, 강건성(robustness), 학습 효율성을 크게 향상시키며, plug-and-play reuse를 통해 외부 Agent 시스템에 적용될 수 있는 frozen policy snapshots를 제공함으로써 AI 시스템의 자율 학습 및 적응 능력 발전에 중요한 시사점을 제공합니다.
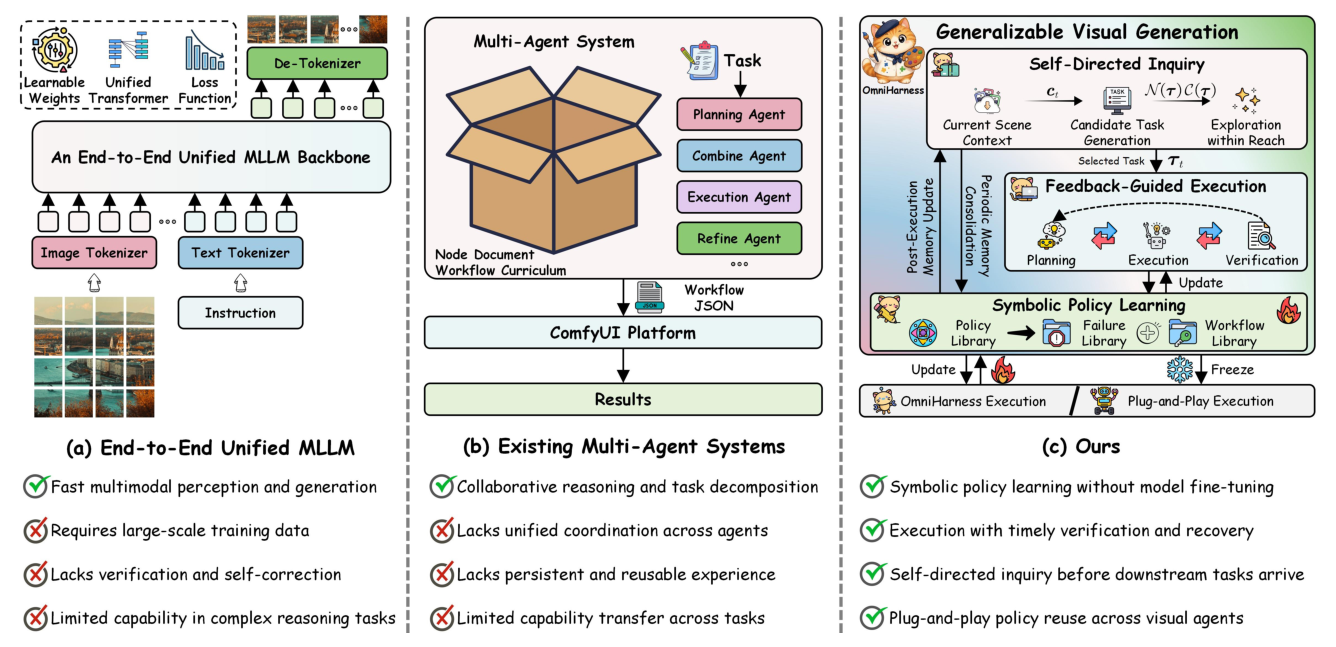
Figure 2 — OmniHarness의 핵심 개념과 기존 방법론들과의 차이를 보여주는 아키텍처 비교 다이어그램.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Agentic Visual Generation: From Generative Models to Agentic Control
- [논문리뷰] Emergence World: Adversarial Stress-Testing of Long-Horizon Multi-Agent Systems
- [논문리뷰] AgentGrad: Intervention-guided Prompt Optimization for Multi Agent Systems
- [논문리뷰] Agents Catching Agents: Shortcut Cascades and Benchmark Gaming in Clinical Multi-Agent Systems
- [논문리뷰] Scaling Properties of Text Conditioning in Visual Generation
Review 의 다른글
- 이전글 [논문리뷰] ModularRSI: Modular and Generalizable Recursive Harness Self-Improvement
- 현재글 : [논문리뷰] OmniHarness: Harnessing Generalizable Visual Generation via Symbolic Policy Learning
- 다음글 [논문리뷰] PhysStream: Streaming Physics-Grounded Video Generation with Structured Scene Memory and Fine-Grained Motion Control
댓글