[논문리뷰] ProgramDistill: From Interactive Web Apps to Verifiable Reference-Guided SWE Tasks
링크: 논문 PDF로 바로 열기
메타데이터
저자: Jeonghye Kim, Minseon Kim, Young Jin Kim, Matheus Pereira, Marc-Alexandre Côté, Alessandro Sordoni, Xingdi Yuan, Zhengyan Shi
1. Key Terms & Definitions (핵심 용어 및 정의)
- Application-to-Task Factorization: 웹 애플리케이션의 복잡한 기능을 서로 다른 Granularity를 가진 개별적인 feature로 분해하여, 각 기능을 수행하는 독립적인 SWE Tasks를 생성하는 과정입니다.
- Reference-to-Current Distillation: Coding agent가 기능이 완전한 Reference instance를 관찰하고, 이를 통해 얻은 지식을 바탕으로 결함이 있는 Current instance의 소스 코드를 복구하는 정보 추출 및 이전 과정을 의미합니다.
- Restoration Depth: 한 애플리케이션의 lineage에서 동시에 복구해야 하는 target 기능의 개수를 의미하며, 이는 작업의 난이도를 조절하는 축으로 사용됩니다.
- Replay-verified Behaviors: Playwright 기반의 Browser Helper를 통해 기록되고 검증된 자동화된 브라우저 상호작용 trace로서, 성공적인 코드 복구 여부를 판별하는 ground truth 역할을 합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 Coding agent 평가 방식이 가진 정적인 문제 정의의 한계를 극복하고, 실제 소프트웨어 개발 환경과 유사한 Reference-guided 환경을 도입하고자 합니다 [Figure 1]. 기존 연구들은 대부분 명시적인 이슈나 명령을 통해 해결해야 할 behavior를 사전에 지정해 주지만, 실제 웹 개발 환경에서는 개발자가 동작하는 Reference application을 통해 필요한 기능을 직접 추론하고 구현해야 하는 경우가 많습니다. 본 연구는 애플리케이션을 단일한 복구 대상이 아닌, 계층적이고 상태 의존적인 기능들로 factorizing하여 확장 가능하고 통제된 난이도를 가진 벤치마크를 구축하는 것을 목표로 합니다.
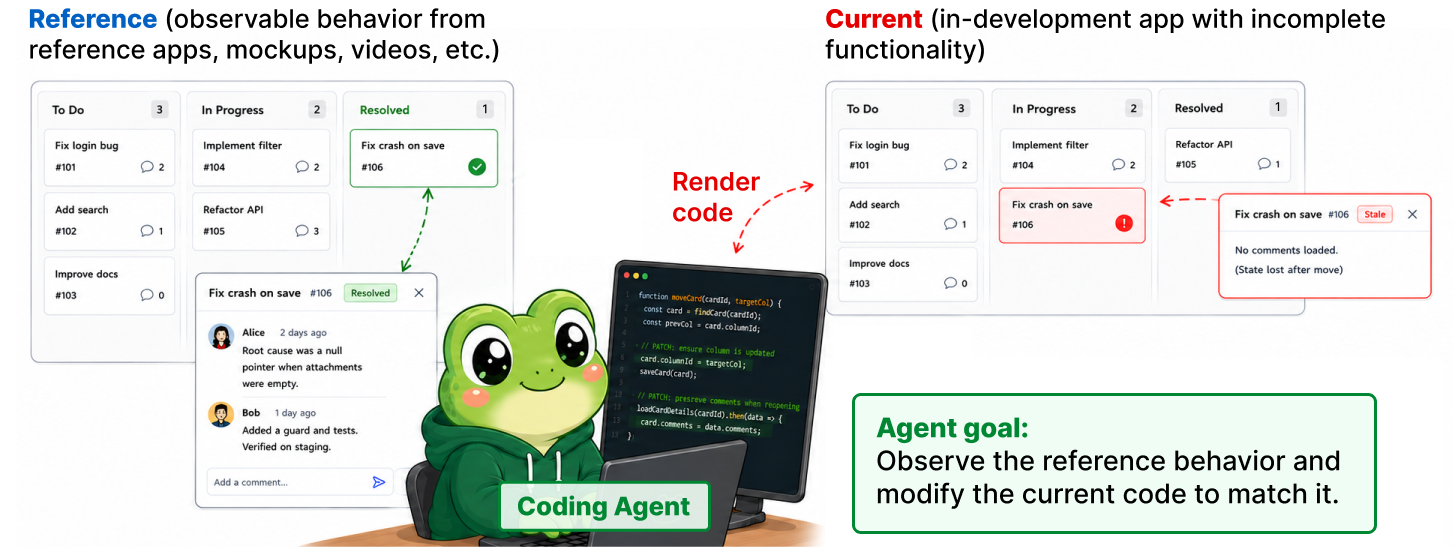
Figure 1 — 참조 기반 SWE 개념
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Mine–Craft–Patch 파이프라인을 제안하여 human-in-the-loop 없이 4,063개의 SWE tasks를 자동으로 생성하였습니다 [Figure 2]. Mining 단계에서는 LLM agents가 애플리케이션을 탐색하여 replay 가능한 behavior trace를 수집하고, Crafting 단계에서는 이를 기반으로 소스 코드를 마스킹하여 난이도별 task를 생성하며, Patching 단계에서는 Coding agent가 Reference를 참조하여 마스킹된 기능을 복구합니다 [Figure 2]. 각 task는 정밀한 counterfactual validation을 거쳐 atomic repair부터 full-application reconstruction까지의 난이도를 확보합니다 [Figure 4].
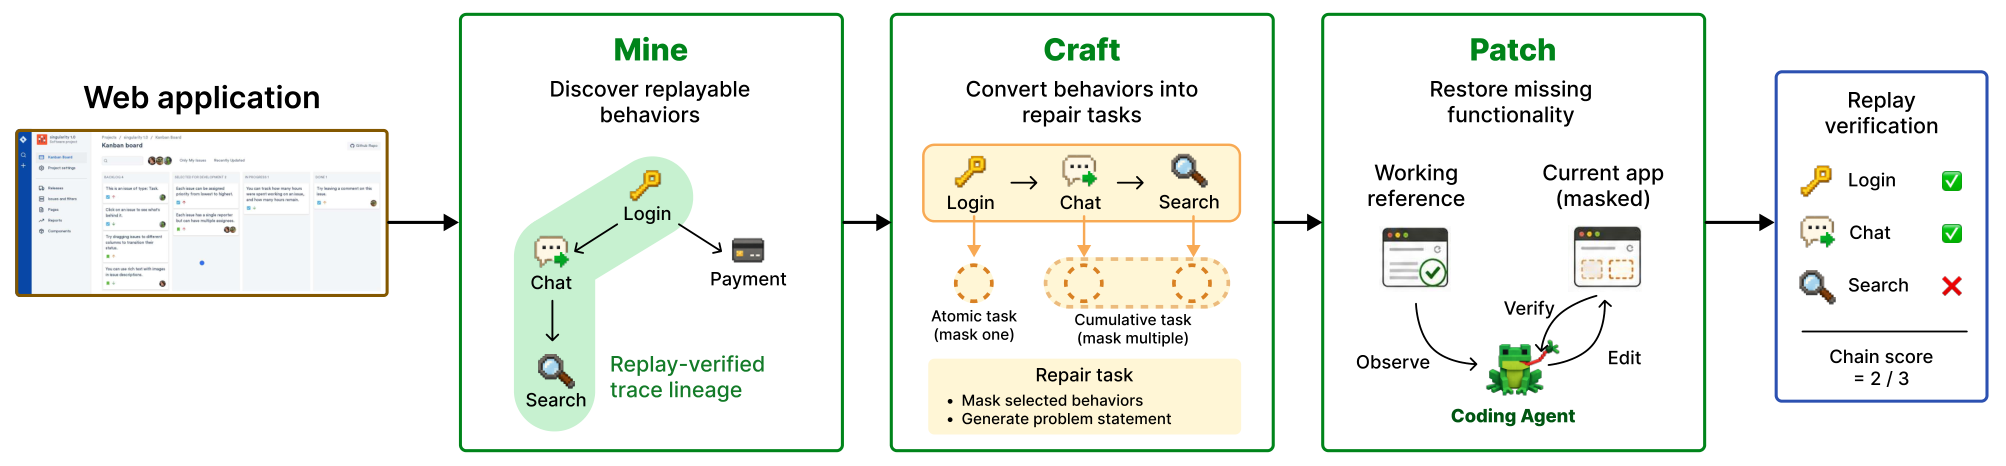
Figure 2 — 전체 파이프라인 구조
실험 결과, GPT-6 Astra와 Claude Opus 5가 full-application reconstruction에서 각각 49.2%와 28.8%의 success rate를 기록하였습니다. 또한, restoration depth가 1에서 8로 증가함에 따라, partial-application reconstruction에서의 success rate는 GPT-6 Astra의 경우 100%에서 64.0%로, Claude Opus 5의 경우 96%에서 32%로 급격히 하락하여, 기능 복구의 난이도와 agent 노력 사이의 유의미한 상관관계를 확인하였습니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 웹 애플리케이션의 동작을 기능별로 분해하고 이를 reference 기반의 복구 task로 변환하는 ProgramDistill 프레임워크를 통해 Coding agent의 실무 능력을 평가하는 새로운 지평을 열었습니다. 특히 Restoration depth를 통한 체계적인 난이도 제어는 Coding agent의 학습과 평가에 필수적인 curriculum을 제공합니다. 이 연구는 단순히 코드를 수정하는 능력을 넘어, 동작 중인 소프트웨어로부터 기능을 관찰하고 이해하며 복구하는 고차원적인 Reference-guided 능력을 요구함으로써 향후 자동화된 소프트웨어 엔지니어링 분야의 발전에 크게 기여할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RealSWE: A Compositional Evaluation of Coding Agents under Realistic User Requests
- [논문리뷰] NL2Repo-Bench: Towards Long-Horizon Repository Generation Evaluation of Coding Agents
- [논문리뷰] Φ-Bench: Can Large Language Models Engineer the Infrastructure That Powers Them?
- [논문리뷰] HarnessDev: Can LLMs Create and Evolve Their Own Agent Harness?
- [논문리뷰] GameXpert-Bench: How Far Are Coding Agents from Expert Game Development?
Review 의 다른글
- 이전글 [논문리뷰] PANORAMA: Panoptic Grounded Captioning via Mask Proposal Selection
- 현재글 : [논문리뷰] ProgramDistill: From Interactive Web Apps to Verifiable Reference-Guided SWE Tasks
- 다음글 [논문리뷰] Rethinking Critic Learning in PPO: Understanding and Mitigating Value Flattening
댓글