[논문리뷰] When EOS Tokens Disagree: Understanding Length Inflation in On-Policy Distillation
링크: 논문 PDF로 바로 열기
메타데이터
저자: Yuxiao Yang, Tianrun Yu, Shangzhe Li, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- On-Policy Distillation (OPD): 학생 모델(Student)이 자신의 Rollout 데이터를 사용하여 교사 모델(Teacher)로부터 토큰 단위의 지식을 학습하는 강화 학습 기반의 파인튜닝 프레임워크입니다.
- Length Inflation: 학생 모델이 응답을 적절히 종료하지 못하고 불필요하게 긴 답변이나 반복적인 출력을 생성하여 정해진 Generation Budget을 소진하는 현상입니다.
- Termination-Token Mismatch: 학생 모델과 교사 모델이 문장 종료(EOS)를 의미하는 토큰을 서로 다르게 정의하거나, 동일한 종료 세트를 가지더라도 학습된 종료 확률 분포가 일치하지 않는 현상을 의미합니다.
- Semantic EOS Aggregation: 서로 다른 EOS 토큰들을 하나의 'Stop'이라는 의미적 행동(Semantic Action)으로 묶어, 교사 모델이 어떤 형태의 종료 토큰을 선호하든 학생 모델이 이를 총체적 종료 확률로 학습하도록 보정하는 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 On-policy distillation 과정에서 발생하는 심각한 Length Inflation 현상의 원인을 규명하고 이를 완화하는 것을 목표로 합니다 [Figure 1]. 기존 연구들은 이 현상을 주로 목적 함수(Objective)의 한계나 훈련 불안정성으로 설명했으나, 저자들은 이 현상의 핵심 원인이 모델 간 Termination-token mismatch에 있음을 밝혀냈습니다. 특히, 베이스 모델과 포스트 트레이닝된 교사 모델 사이에서 동일한 종료 토큰 세트를 선언하더라도 실제로 모델이 할당하는 종료 확률이 달라, 학생 모델이 자신의 종료 토큰을 제대로 활용하지 못하는 문제가 발생합니다. 이러한 불일치는 단순한 디코딩 설정 변경만으로는 해결되지 않으며, 모델의 생성 효율성을 크게 저하시킵니다.
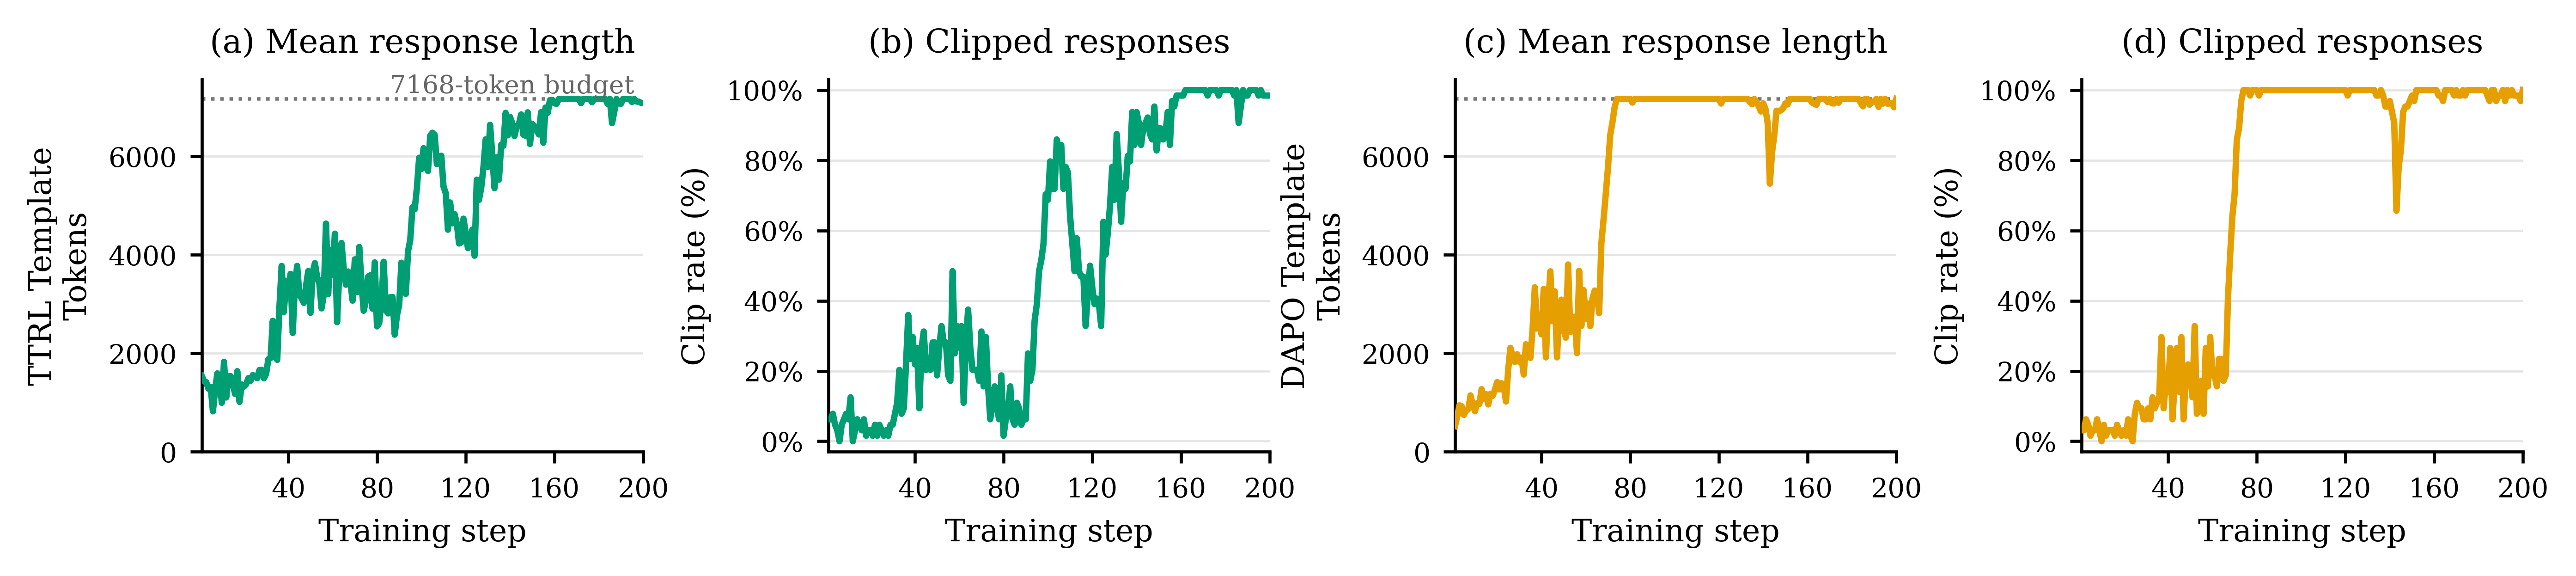
Figure 1 — OPD 환경의 길이 팽창 현상
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Semantic EOS Aggregation을 제안하여 종료 확률 분포의 불일치를 근본적으로 해소합니다 [Figure 3]. 이 방법론은 단순히 EOS 토큰을 추가하는 것이 아니라, 여러 EOS 토큰의 확률 질량을 하나의 의미적 'stop' 행동으로 합산하여 모델을 학습시킵니다. 실험 결과, 이 방식은 Qwen3, Llama 3.2, Gemma 3 모델군 모두에서 Length Inflation을 유의미하게 억제하고 응답 길이와 Clipping 비율을 교사 모델 수준으로 회복시키는 효과를 보였습니다 [Figure 4]. 특히, 기존의 단순 디코딩 설정 변경(Fix 1)이 효과가 없었던 것과 달리, 제안하는 기법은 훈련 전반에 걸쳐 종료 확률의 붕괴(collapse)를 방지하였습니다. 또한, K2-Horizon을 이용한 단계별 분석을 통해 모델의 종료 선호도가 훈련 과정에서 진화하며, 정렬 이후에도 발생할 수 있는 후기 단계의 길이 팽창 현상을 통해 추가적인 최적화 과제를 식별하였습니다.
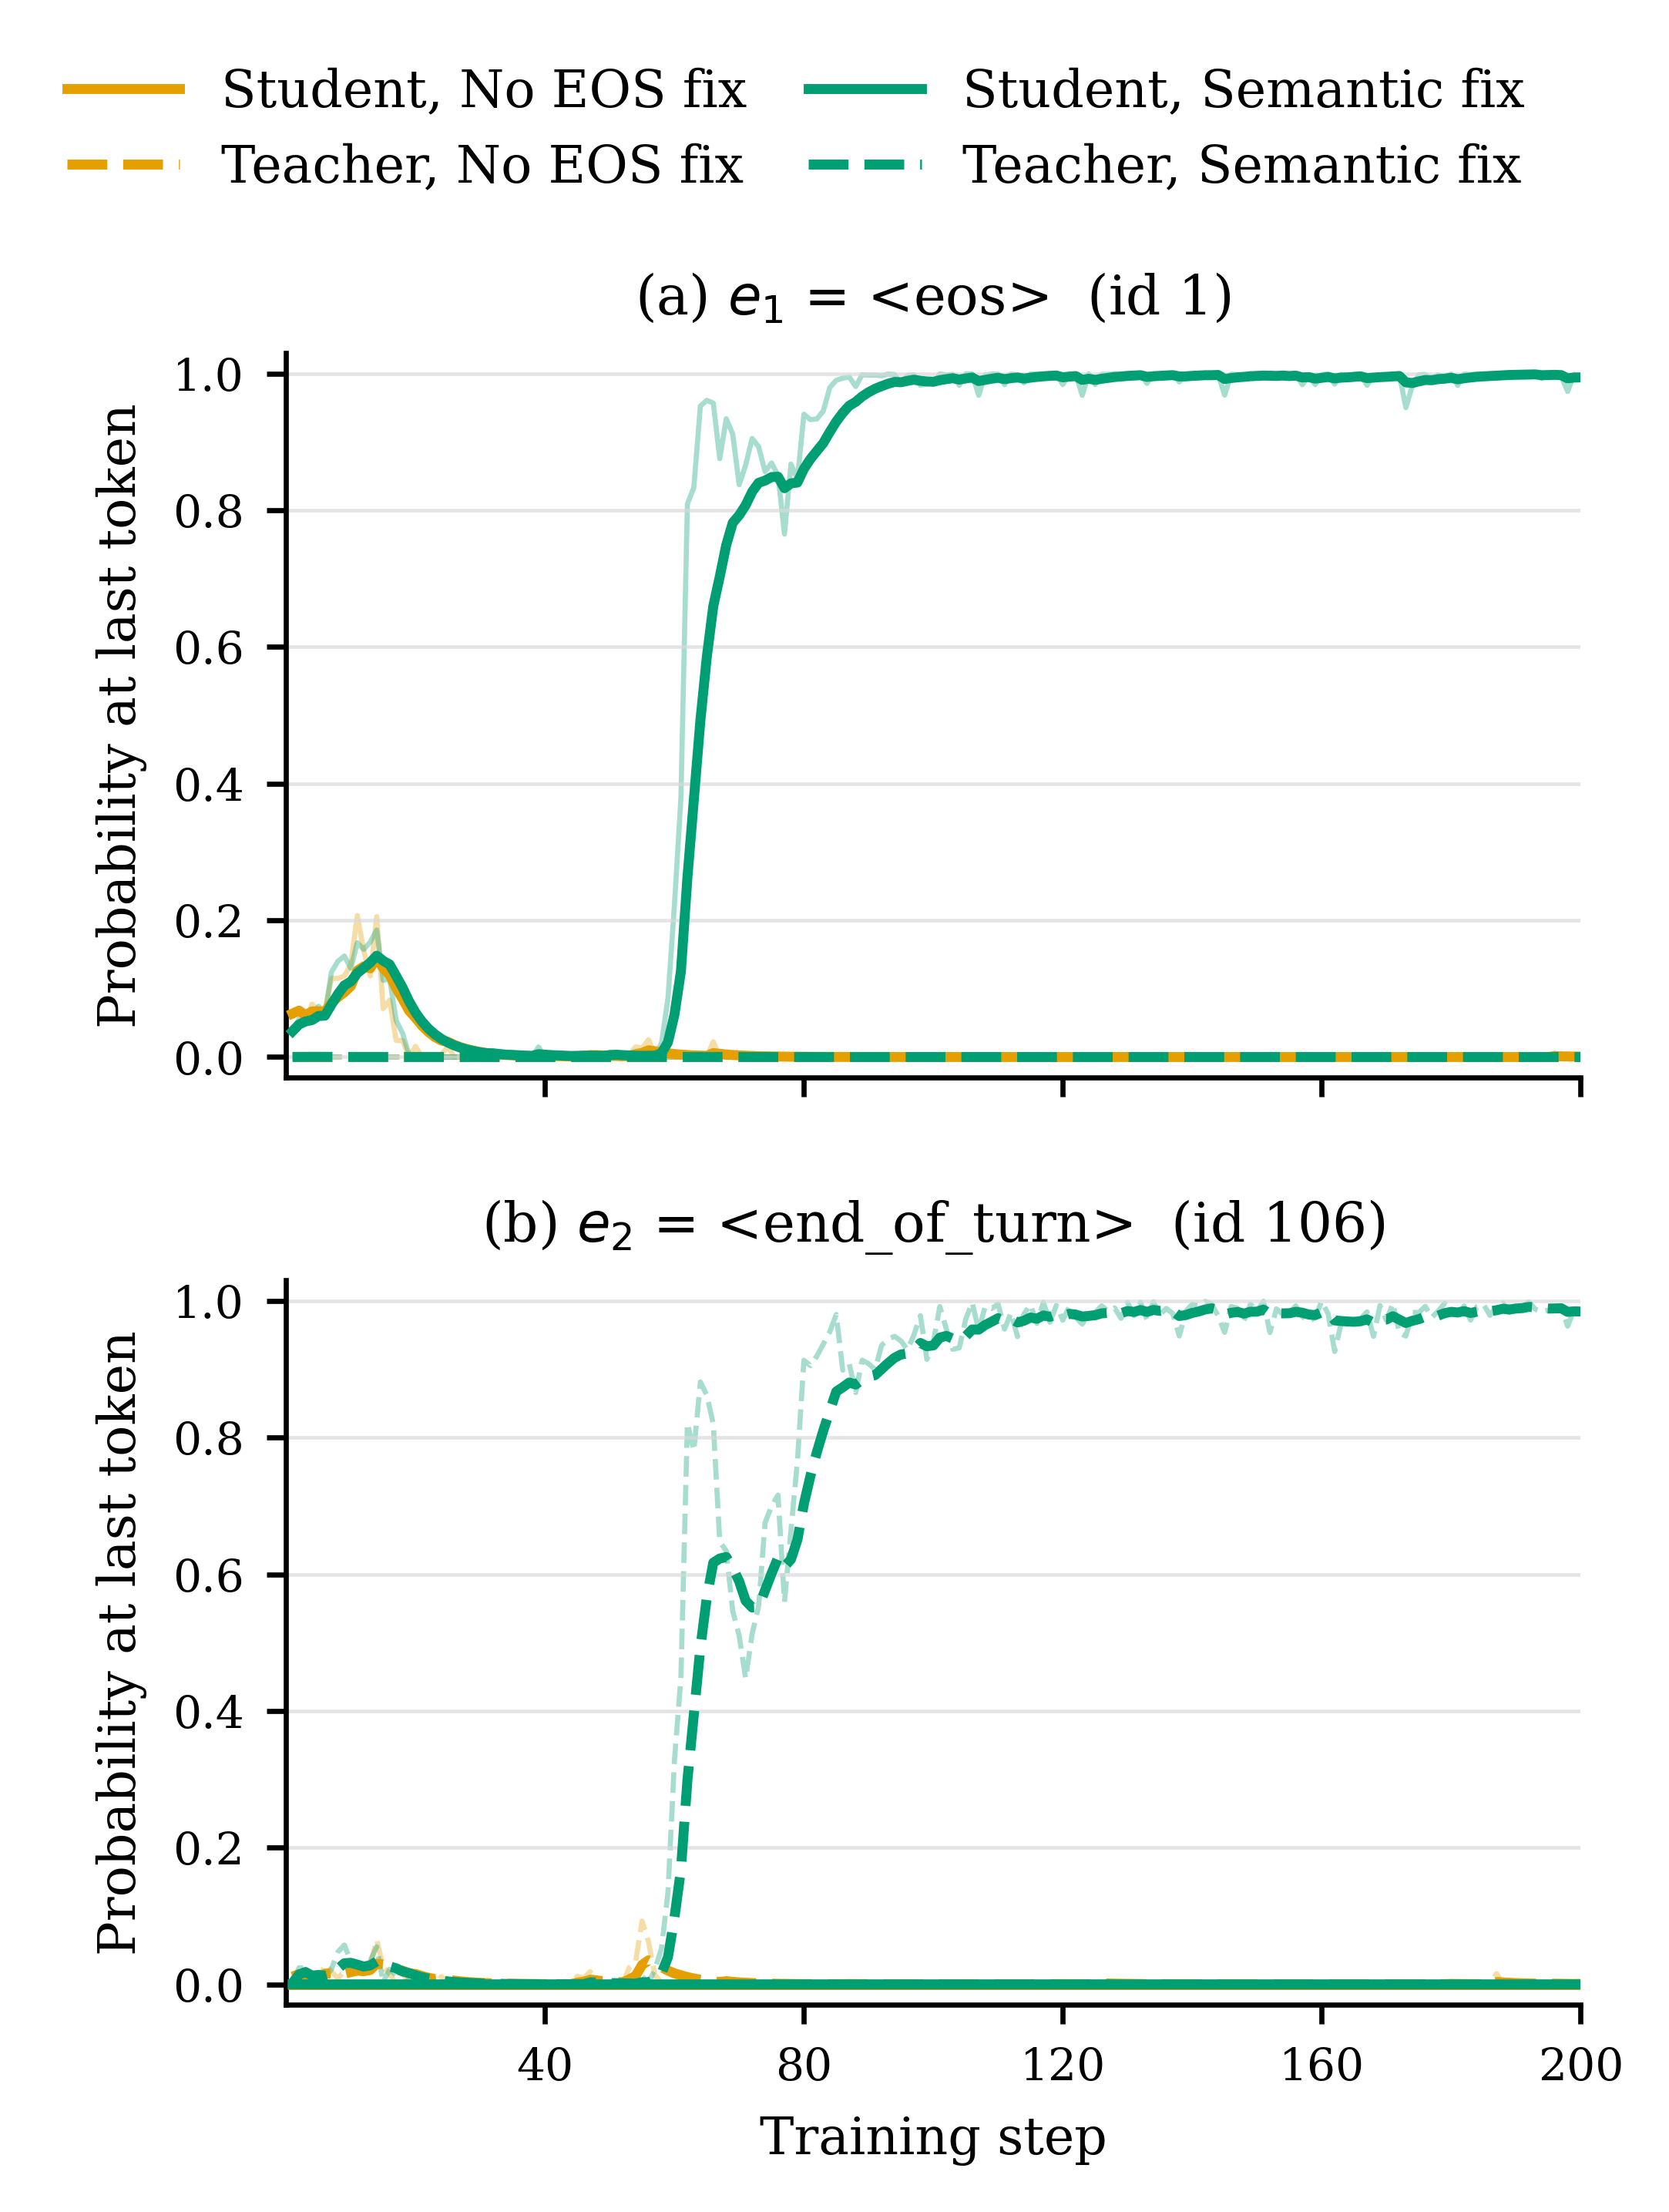
Figure 3 — Gemma 3 모델의 EOS 선호도 차이
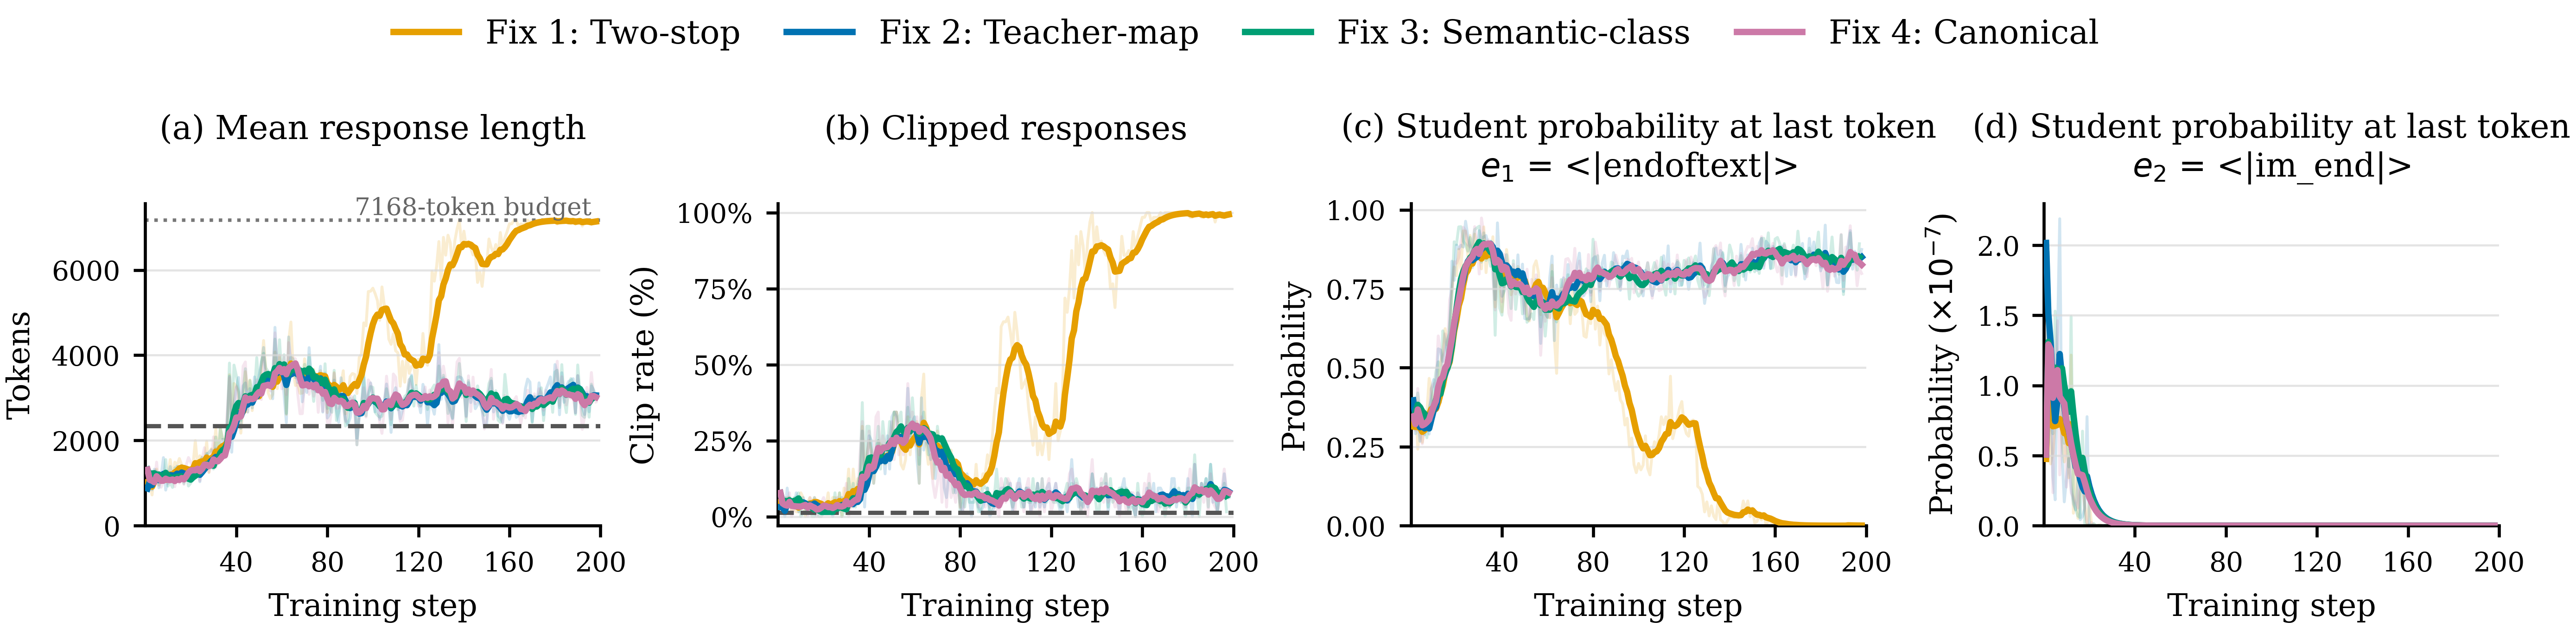
Figure 4 — 모델군별 EOS 보정 결과 비교
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Termination-token mismatch가 OPD 환경에서 발생하는 길이 팽창의 주요 원인임을 입증하고, 이를 해결하기 위한 효과적인 보정 프레임워크를 제시했습니다. 이 연구는 모델의 종료 행동이 토큰 수준의 정렬을 넘어 의미론적 정렬을 필요로 함을 시사하며, 더 나아가 모델 간 혹은 학습 단계 간의 종료 편향성을 진단하는 표준적인 방법을 제공합니다. 이러한 성과는 향후 대규모 언어 모델의 효율적인 파인튜닝과 보다 안정적인 생성 제어 모델 설계에 중요한 지침이 될 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] On-Policy Delta Distillation for Multilingual Math Reasoning
- [논문리뷰] Distilled Reinforcement Learning for LLM Post-training
- [논문리뷰] On-Policy Delta Distillation
- [논문리뷰] Demystifying On-Policy Distillation: Roles, Pathologies, and Regulations
- [논문리뷰] MOPD-Router: Rethinking Teacher Routing in Multi-Teacher On-Policy Distillation
Review 의 다른글
- 이전글 [논문리뷰] What Does Privileged Information Add to On-Policy Self-Distillation?
- 현재글 : [논문리뷰] When EOS Tokens Disagree: Understanding Length Inflation in On-Policy Distillation
- 다음글 [논문리뷰] When2Think: Learning Difficulty-Aware Length Control for Efficient Hybrid Reasoning Models
댓글