[논문리뷰] What Does Privileged Information Add to On-Policy Self-Distillation?
링크: 논문 PDF로 바로 열기
메타데이터
저자: XiuYu Zhang, Wei Chow, Junfeng Fang, Zhenkai Liang, Tat-Seng Chua
1. Key Terms & Definitions (핵심 용어 및 정의)
- OPSD (On-policy Self-distillation): 모델이 자기 자신의 고정된 복사본(Teacher)으로부터 학습하는 방식으로, Teacher가 문제에 대한 해답이나 논리적 과정을 보고 학생 모델(Student)의 응답을 평가하여 학습을 유도하는 기법입니다.
- Privileged Information (PI): Student가 추론 시에는 접근할 수 없지만, 학습 과정에서 Teacher에게 제공되는 추가적인 정보(예: 풀이 과정, 해답)를 지칭합니다.
- AMPLE-Math: 5,319개의 수학 문제로 구성된 벤치마크 데이터셋으로, 동일한 정답을 공유하면서도 난이도와 reasoning 방식이 다른 6가지의
Privileged View를 제공하여 PI의 기여도를 정밀하게 측정할 수 있도록 설계되었습니다. - Correctness Alignment: Student의 정답/오답 샘플에 대해 Teacher가 얼마나 차별적으로 log-probability shift를 적용하는지를 측정하는 지표로, Teacher의 피드백이 학생의 정답 생성을 얼마나 효과적으로 강화하는지 평가합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 OPSD 과정에서 Teacher에게 제공되는 Privileged Information이 실제로 distillation 그 이상의 추가적인 학습 이득을 제공하는지, 그 기여도를 명확히 분리하고자 합니다. 기존 연구들은 distillation 자체만으로도 성능 향상이 가능함을 시사했으나, PI가 구체적으로 어떤 원리로 Student의 성능을 개선하는지에 대한 체계적인 분석은 부족했습니다 [Figure 1]. 저자들은 단순히 성능이 향상되는 것만으로는 PI의 진정한 가치를 판단하기 어렵다고 보며, 특히 Teacher의 평가 방식과 Student의 학습 궤적(Training Trajectory) 사이의 상호작용이 성능 변화에 어떤 영향을 미치는지 규명하고자 합니다.
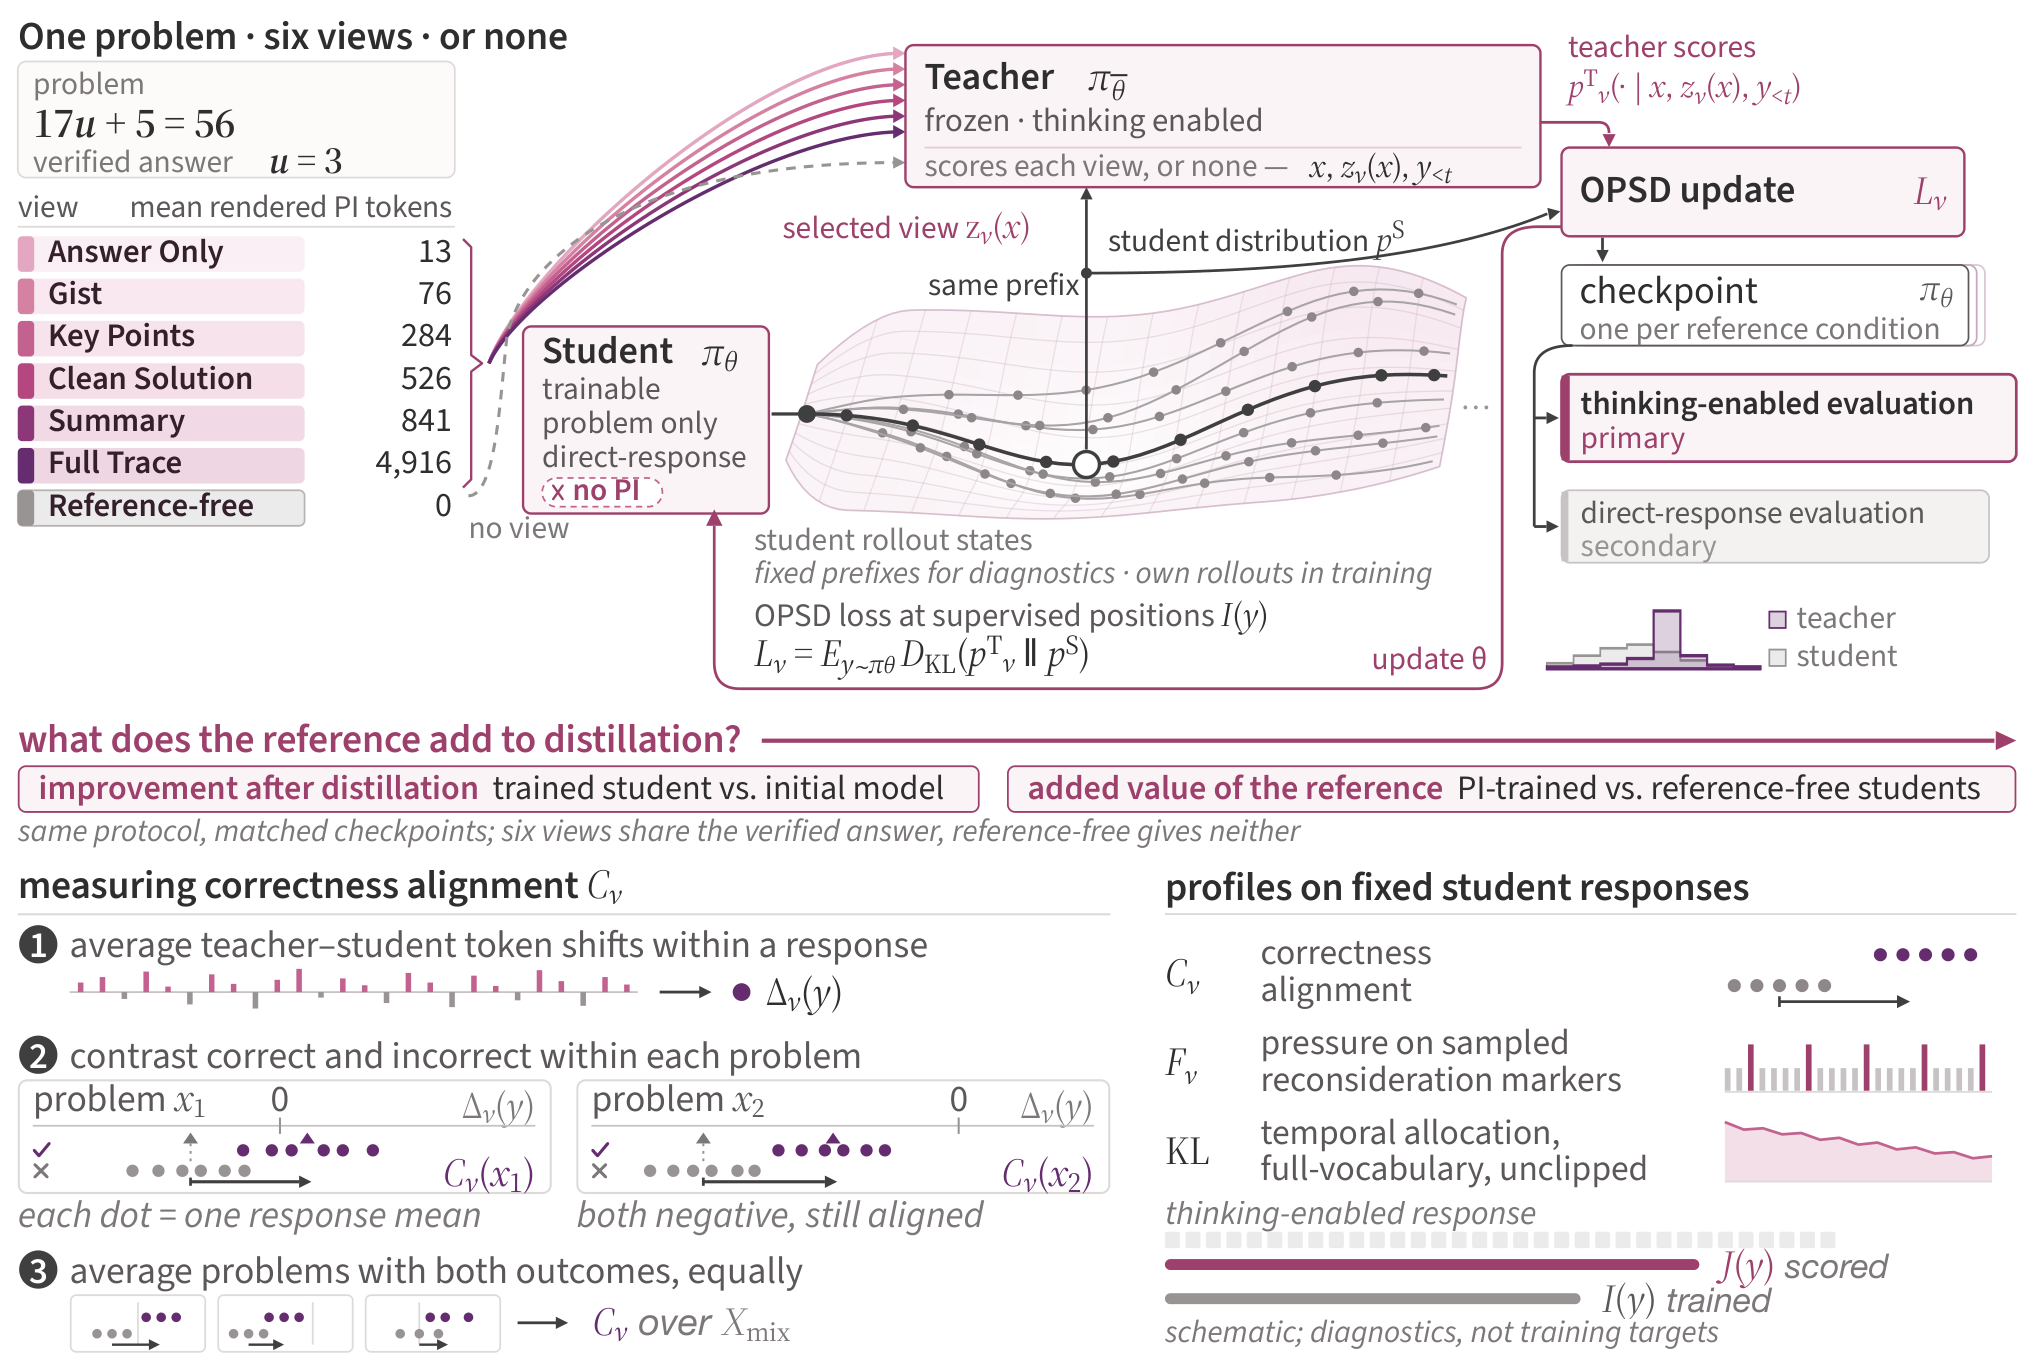
Figure 1 — distillation에서 reference의 역할 개념도
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 AMPLE-Math를 활용하여 6가지의 answer-matched view를 생성하고, 이를 reference-free distillation 결과와 비교함으로써 PI의 순수한 추가 가치를 고립시켰습니다 [Table 1]. 실험 결과, Qwen3-1.7B 모델에서 나타나는 성능 향상의 상당 부분은 reference가 없는 상태에서도 발생하는 것으로 나타났으며, PI를 포함한 경우 추가적인 이득은 Clean Solution을 사용할 때 가장 긍정적이나 그 효과는 제한적이었습니다. 또한, Student의 학습 궤적을 제어하기 위해 직접 응답(direct-response) rollout 대신 thinking-enabled rollout을 사용할 경우, 동일한 reference를 사용하더라도 성능 향상이 오히려 손실로 반전되는 결과를 확인했습니다 [Figure 3]. 이는 OPSD의 성패가 Teacher의 reference 내용 자체보다는, 그 피드백이 Student의 어떤 응답 분포(prefix)에 적용되는지에 깊게 의존함을 의미합니다. 마지막으로, Teacher 프로파일링과 손실 함수 개입 실험을 통해, 기존에 알려진 손실 범위 확대(loss-window coverage)의 이점 중 대부분은 단순히 학습 조기 종료(stopping time) 효과에 의한 것임을 증명했습니다 [Figure 5].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 OPSD에서의 성능 향상이 단순히 reference가 제공하는 정보량에 비례하지 않으며, Student가 학습 과정에서 생성하는 prefix와 Teacher의 피드백이 결합되는 방식이 핵심임을 입증했습니다. 연구진은 reference 기반의 학습이 단지 distillation 과정을 보조하는 도구를 넘어, Student의 기존 reasoning 역량을 더 쉽게 활성화하는 경로를 제공한다는 결론을 내렸습니다. 이러한 발견은 향후 LLM 정렬(Alignment) 및 데이터 효율적 학습 분야에서 reference 설계와 학습 궤적 관리가 어떻게 통합되어야 하는지에 대한 중요한 지침을 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] One Symptom, Three Levers: A Critical Review of On-Policy Self-Distillation
- [논문리뷰] Calibrating Teacher--Student Discrepancy for On-Policy Distillation
- [논문리뷰] SPOT: Sparse Probing and Outcome Calibration for On-Policy Distillation
- [논문리뷰] Visual Contrastive Self-Distillation
- [논문리뷰] dOPSD: On-Policy Self-Distillation for Diffusion Language Models
Review 의 다른글
- 이전글 [논문리뷰] WeVisDoc: From Coverage to Capability for Robust End-to-End Document Parsing
- 현재글 : [논문리뷰] What Does Privileged Information Add to On-Policy Self-Distillation?
- 다음글 [논문리뷰] When EOS Tokens Disagree: Understanding Length Inflation in On-Policy Distillation
댓글