[논문리뷰] Calibrating Teacher--Student Discrepancy for On-Policy Distillation
링크: 논문 PDF로 바로 열기
메타데이터
저자: Qiangqiang He, Jin Li, MingCai Chen, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- On-Policy Distillation (OPD): 학생 모델이 생성한 trajectory 상에서 교사(Teacher) 모델과 학생 모델 간의 토큰 단위 likelihood 차이를 활용하여 학습하는 지식 증류 기법입니다.
- Teacher Self-Deviation (TSD): 교사 모델의 likelihood가 입력된 문맥이나 설정에 따라 토큰 수준에서 변화하는 현상으로, 이는 학생의 실제 역량 차이와 무관한 교사 모델 자체의 변동성을 포함합니다.
- Privileged OPD: 교사 모델에게 정답지나 참고 풀이와 같은 추가적인 정보(Privileged Context)를 제공하여 지식 증류를 시도하는 방식입니다.
- Cal-OPD (Calibrated On-Policy Distillation): 교사의 TSD 영역을 추정하고, 전체 교사-학생 discrepancy 중 TSD 영역에 속하는 부분을 제외한 나머지 잔차(Residual)만을 학습 신호로 사용하여 증류 성능을 최적화하는 기법입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 On-Policy Distillation에서 교사와 학생 간의 discrepancy가 교사 모델 자체의 변동성인 TSD를 포함하고 있어 효율적인 학습을 방해한다는 점을 문제로 제기합니다 [Figure 1]. 기존 연구들에서 활용하는 Privileged OPD는 추가적인 문맥 정보가 교사 측의 likelihood 편향(Shift)을 증폭시켜, 학생 모델이 교사의 불필요한 변동성까지 학습하게 만드는 부작용을 초래합니다. 이러한 현상은 특히 긴 CoT(Chain-of-Thought) 추론 과정에서 모델의 성능을 저하시키는 원인이 됩니다. 따라서 저자들은 이러한 교사 측의 변동성을 격리하고, 순수한 지식 차이만을 학습 신호로 추출하는 새로운 교정 기법의 필요성을 강조합니다.
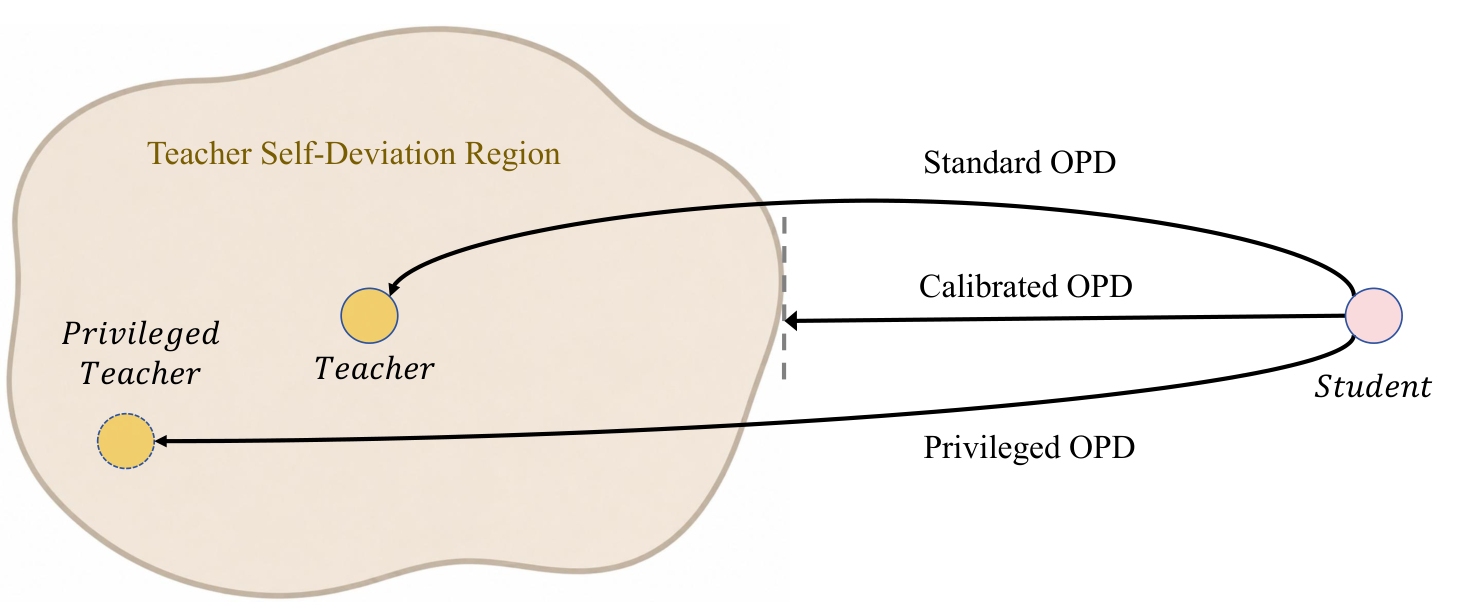
Figure 1 — Cal-OPD의 개념적 구조
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 저자들이 제안하는 Cal-OPD는 긍정적/부정적 Privileged Interventions를 통해 교사의 TSD 영역을 경험적으로 추정하고, 이를 기반으로 학습 신호를 필터링합니다 [Figure 1]. 구체적으로, 교사 모델에 contrasting 문맥을 제공하여 토큰별 최대 하향 및 상향 편향을 측정하고, 이를 바탕으로 정의된 TSD 영역 내의 discrepancy를 0으로 설정하여 무시합니다 [Table 1]. 본 방법론은 원본 discrepancy의 약 52~65%만을 학습에 활용함에도 불구하고, 수학적 추론 벤치마크에서 기존의 standard OPD 및 Privileged OPD 대비 일관된 성능 우위를 보입니다 [Table 3]. 실험 결과, Cal-OPD는 Qwen3-1.7B와 Qwen3-4B 모델 등 다양한 스케일에서 평균 성능이 각각 53.1점과 69.0점으로 측정되어, 베이스라인 대비 유의미한 성능 향상을 달성했습니다 [Table 3]. 또한, TSD가 주로 수학적 지식보다는 언어적 표현(예: "maybe", "however")에 집중되어 있음을 데이터 분석을 통해 정량적으로 입증했습니다 [Table 2].
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 교사 모델의 토큰 수준 likelihood가 모든 경우에 신뢰할 수 있는 학습 지표가 아님을 밝히고, TSD의 개념을 새롭게 정립하여 모델 학습의 질을 개선했습니다. Cal-OPD를 통한 지식 증류 기법은 교사 모델의 불필요한 문맥 의존성을 제거함으로써 더욱 견고하고 안정적인 학습이 가능함을 입증하였습니다. 이 연구는 대형 언어 모델의 지식 증류 과정에서 발생하는 정보 왜곡을 해결하고, 모델의 추론 능력을 극대화할 수 있는 새로운 최적화 전략을 제시했다는 점에서 높은 학계 및 실무적 가치를 지닙니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Pass the Baton: Trajectory-Relayed On-Policy Distillation
- [논문리뷰] OPRD: On-Policy Representation Distillation
- [논문리뷰] What Does Privileged Information Add to On-Policy Self-Distillation?
- [논문리뷰] RetireOPD: Self-Retiring On-Policy Distillation for Agentic Reinforcement Learning
- [논문리뷰] One Symptom, Three Levers: A Critical Review of On-Policy Self-Distillation
Review 의 다른글
- 이전글 [논문리뷰] CADWorld: Computer-Use Benchmark for Long-Horizon Computer-Aided Design
- 현재글 : [논문리뷰] Calibrating Teacher--Student Discrepancy for On-Policy Distillation
- 다음글 [논문리뷰] CodeMidas: Scaling Agentic Coding RL Environments from Code Itself
댓글