[논문리뷰] RetireOPD: Self-Retiring On-Policy Distillation for Agentic Reinforcement Learning
링크: 논문 PDF로 바로 열기
메타데이터
저자: Yan Yu, Zhengxi Lu, Yizhou Liu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- GRPO (Group Relative Policy Optimization): Agent의 trajectory 그룹에서 얻은 보상을 기반으로 advantage를 계산하여 Policy를 최적화하는 효율적인 RL 방식입니다.
- OPD (On-Policy Distillation): Teacher 모델이 생성한 dense한 token-level 지도 신호를 사용하여 Student 모델을 학습시키는 기법입니다.
- Privileged Teacher: 학습 과정에서만 사용 가능한 추가적인 task 관련 skill context를 입력받아 Student에게 지식을 전수하는 역할을 하는 모델입니다.
- Adaptive Retirement: 학습 과정 중 Teacher와 Student 간의 discrepancy와 Student의 상대적 역량을 실시간으로 모니터링하여, Teacher의 지도가 더 이상 도움 되지 않는 시점에 학습에서 배제하는 기술입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Agentic task에서 사용되는 기존의 On-Policy Distillation (OPD) 방식이 가지는 고질적인 한계들을 해결하고자 합니다 [Figure 1]. 기존 연구들은 단순히 privileged context가 제공되면 Teacher가 자동적으로 신뢰할 수 있는 가이드가 될 것이라고 가정하지만, 실제로는 최적화되지 않은 Teacher는 불충분한 감독 신호를 제공합니다. 또한, 학습이 진행됨에 따라 Student가 특정 수준의 역량에 도달하면, Teacher의 행동을 모방하는 OPD 신호가 GRPO에 의한 보상 극대화 방향과 충돌하여 오히려 성능 향상을 저해하는 현상이 발생합니다 [Figure 2]. 따라서 고정된 스케줄에 의존하지 않고, 학습 신호 자체를 기반으로 Teacher의 역할을 동적으로 조절하는 새로운 방법론이 필요합니다.
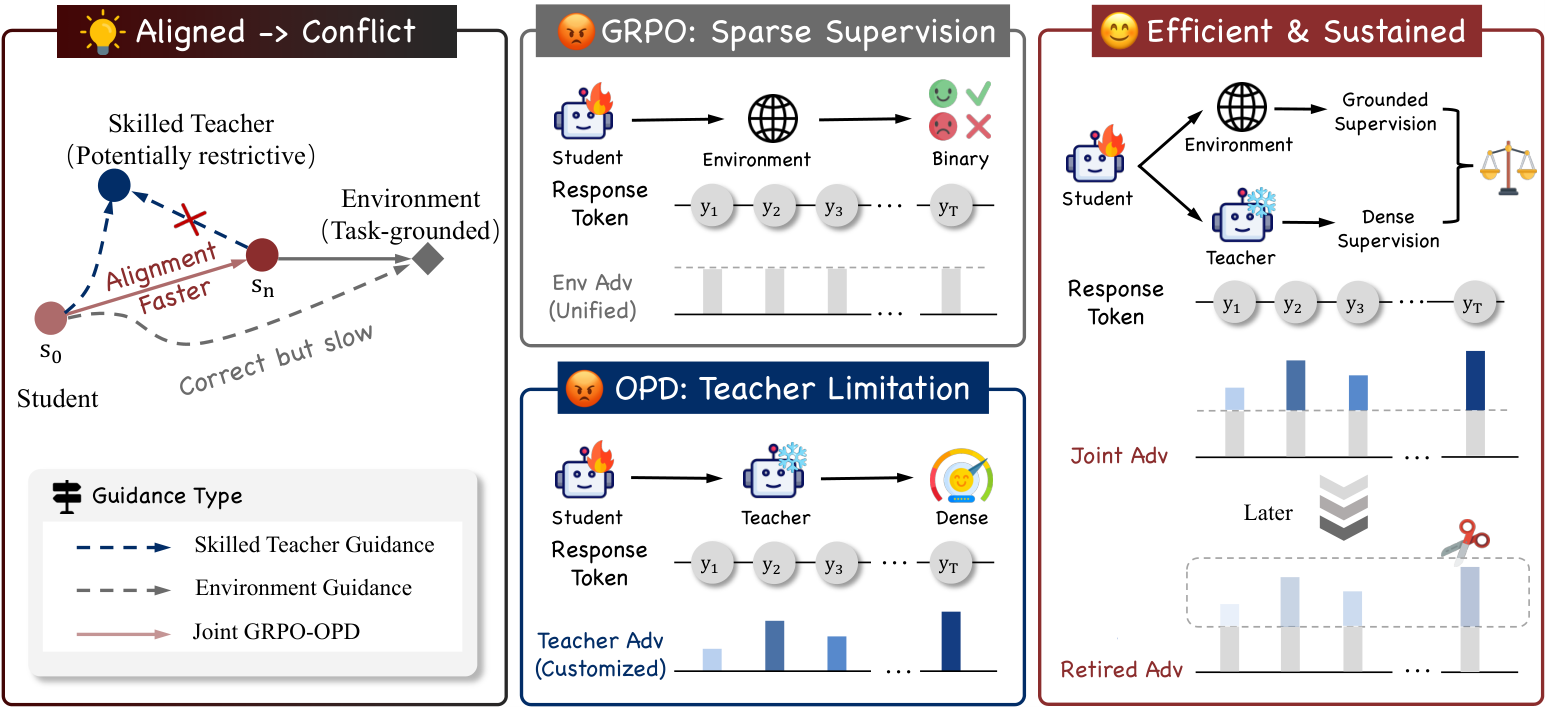
Figure 1 — RetireOPD의 핵심 개념 및 문제 인식
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 RetireOPD라는 3단계 프레임워크를 제안하여 위 문제들을 해결합니다 [Figure 3]. 첫째, privileged skill을 충분히 학습하도록 환경 보상을 사용하여 Teacher를 별도로 최적화합니다. 둘째, GRPO와 OPD를 결합하여 Student를 공동 학습(joint training)시킵니다. 셋째, 학습 과정 중 Teacher와 Student의 분포 차이(discrepancy)가 더 이상 줄어들지 않고 Student의 성공률이 일정 기준에 도달하면, Teacher를 스스로 은퇴(self-retiring)시킵니다. 실험 결과, RetireOPD는 ALFWorld 환경에서 GRPO 베이스라인 대비 14.1%~18.8%의 성공률 향상을 보였으며, WebShop에서는 11.8%~19.0%의 정확도 개선을 달성했습니다 [Table 1]. 특히, 적응형 은퇴 메커니즘을 통해 Teacher가 계속 학습에 관여하는 GRPO+OPD 조합보다 일관되게 우수한 성능을 입증하였습니다 [Figure 4].
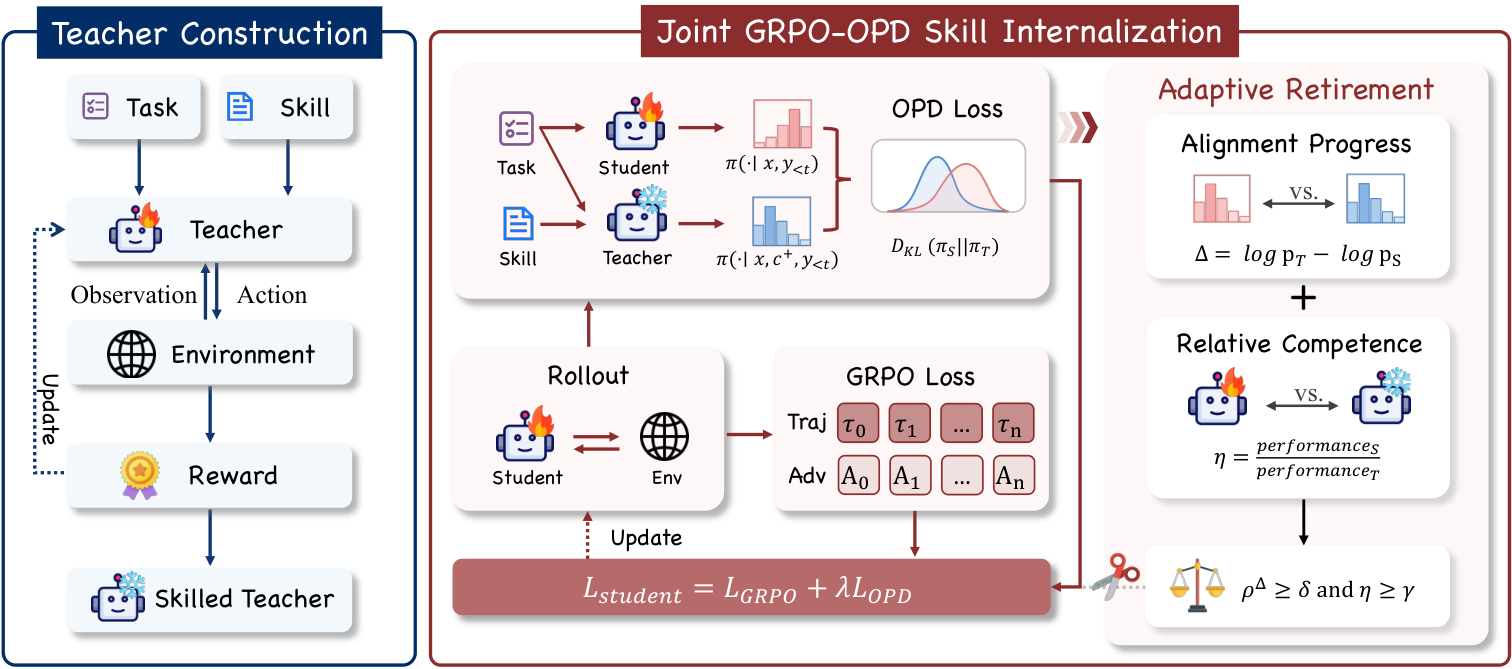
Figure 3 — RetireOPD의 전체 프레임워크
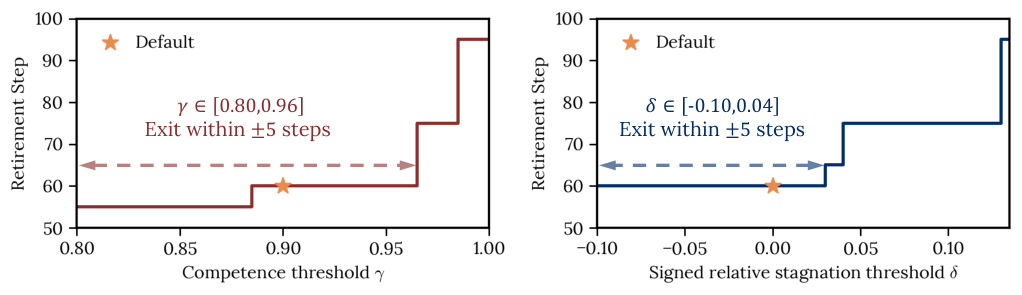
Figure 4 — 학습 동학 및 은퇴 전략 비교
4. Conclusion & Impact (결론 및 시사점)
RetireOPD는 Agentic RL 학습에서 Teacher의 감독 신호를 초기 단계의 스캐폴딩(scaffolding)으로 활용하고, 적절한 시점에 이를 제거함으로써 보상 최적화의 제약을 해소하는 혁신적인 접근 방식을 제시합니다. 본 연구는 privileged information을 통한 초기 학습의 효율성과 장기적인 정책 수렴의 극대화라는 두 마리 토끼를 잡음으로써, Agent 학습의 안정성과 성능을 동시에 끌어올렸습니다. 이러한 적응형 은퇴 메커니즘은 향후 다양한 지식 증류 기반 강화학습 연구에 중요한 지침을 제공하며, LLM 기반 Agent 설계의 새로운 표준이 될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Agent-G^2: Gaussian Guidance for Agentic Reinforcement Learning
- [논문리뷰] Calibrating Teacher--Student Discrepancy for On-Policy Distillation
- [논문리뷰] Reference-Free Post-Training of Open Large Language Models for Multilingual Machine Translation
- [논문리뷰] Distill Where You Fail: Recovering Learning Signals of Negative RL-Groups from Adaptive Teacher Guidance
- [논문리뷰] Progressive Agent Skill Generation via Reinforcement Learning
Review 의 다른글
- 이전글 [논문리뷰] Region-Level Policy Optimization for Fine-grained MLLM Perception
- 현재글 : [논문리뷰] RetireOPD: Self-Retiring On-Policy Distillation for Agentic Reinforcement Learning
- 다음글 [논문리뷰] RiskChainBench: A Benchmark for Obfuscated Platform Message Restoration and Evidence-Grounded Web Investigation
댓글