[논문리뷰] RiskChainBench: A Benchmark for Obfuscated Platform Message Restoration and Evidence-Grounded Web Investigation
링크: 논문 PDF로 바로 열기
메타데이터
저자: ZhuoXin Liu, Zhiming Ma, Ying Zhang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Obfuscated Content: 이모지, 동음이의어, 문자 분해 등을 활용해 플랫폼 모니터링을 회피하는 변조된 메시지.
- Entry Gate: 복원된 메시지에서 추출된 타겟 정보를 바탕으로, 하위 웹 조사 단계의 성공 여부를 결정하는 오프라인 검증 로직.
- Evidence-Grounded Web Investigation: 웹 에이전트가 탐색 과정을 거쳐 획득한 증거를 기반으로 risk report를 작성하는 평가 프레임워크.
- Resettable Local Sandbox: 실제 라이브 서비스에 영향을 주지 않고 안전하게 재현 가능한 고립된 웹 환경.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 플랫폼 남용 캠페인에서 발생하는 메시지 복원과 그에 따른 실제 웹 조사가 단절되어 있는 문제를 해결하기 위해 RiskChainBench를 제안한다. 기존 연구들은 변조된 콘텐츠 이해(restoration)와 웹 에이전트의 위험 탐지(investigation)를 별개로 평가하여, 메시지 복원에서의 작은 오류가 하위 웹 조사 단계에 미치는 영향력을 측정하지 못한다는 한계가 있다. 이를 위해 저자들은 복원과 조사가 목적지(destination)를 중심으로 연결된 cross-channel platform risk investigation 환경을 구축하였다 [Figure 2].
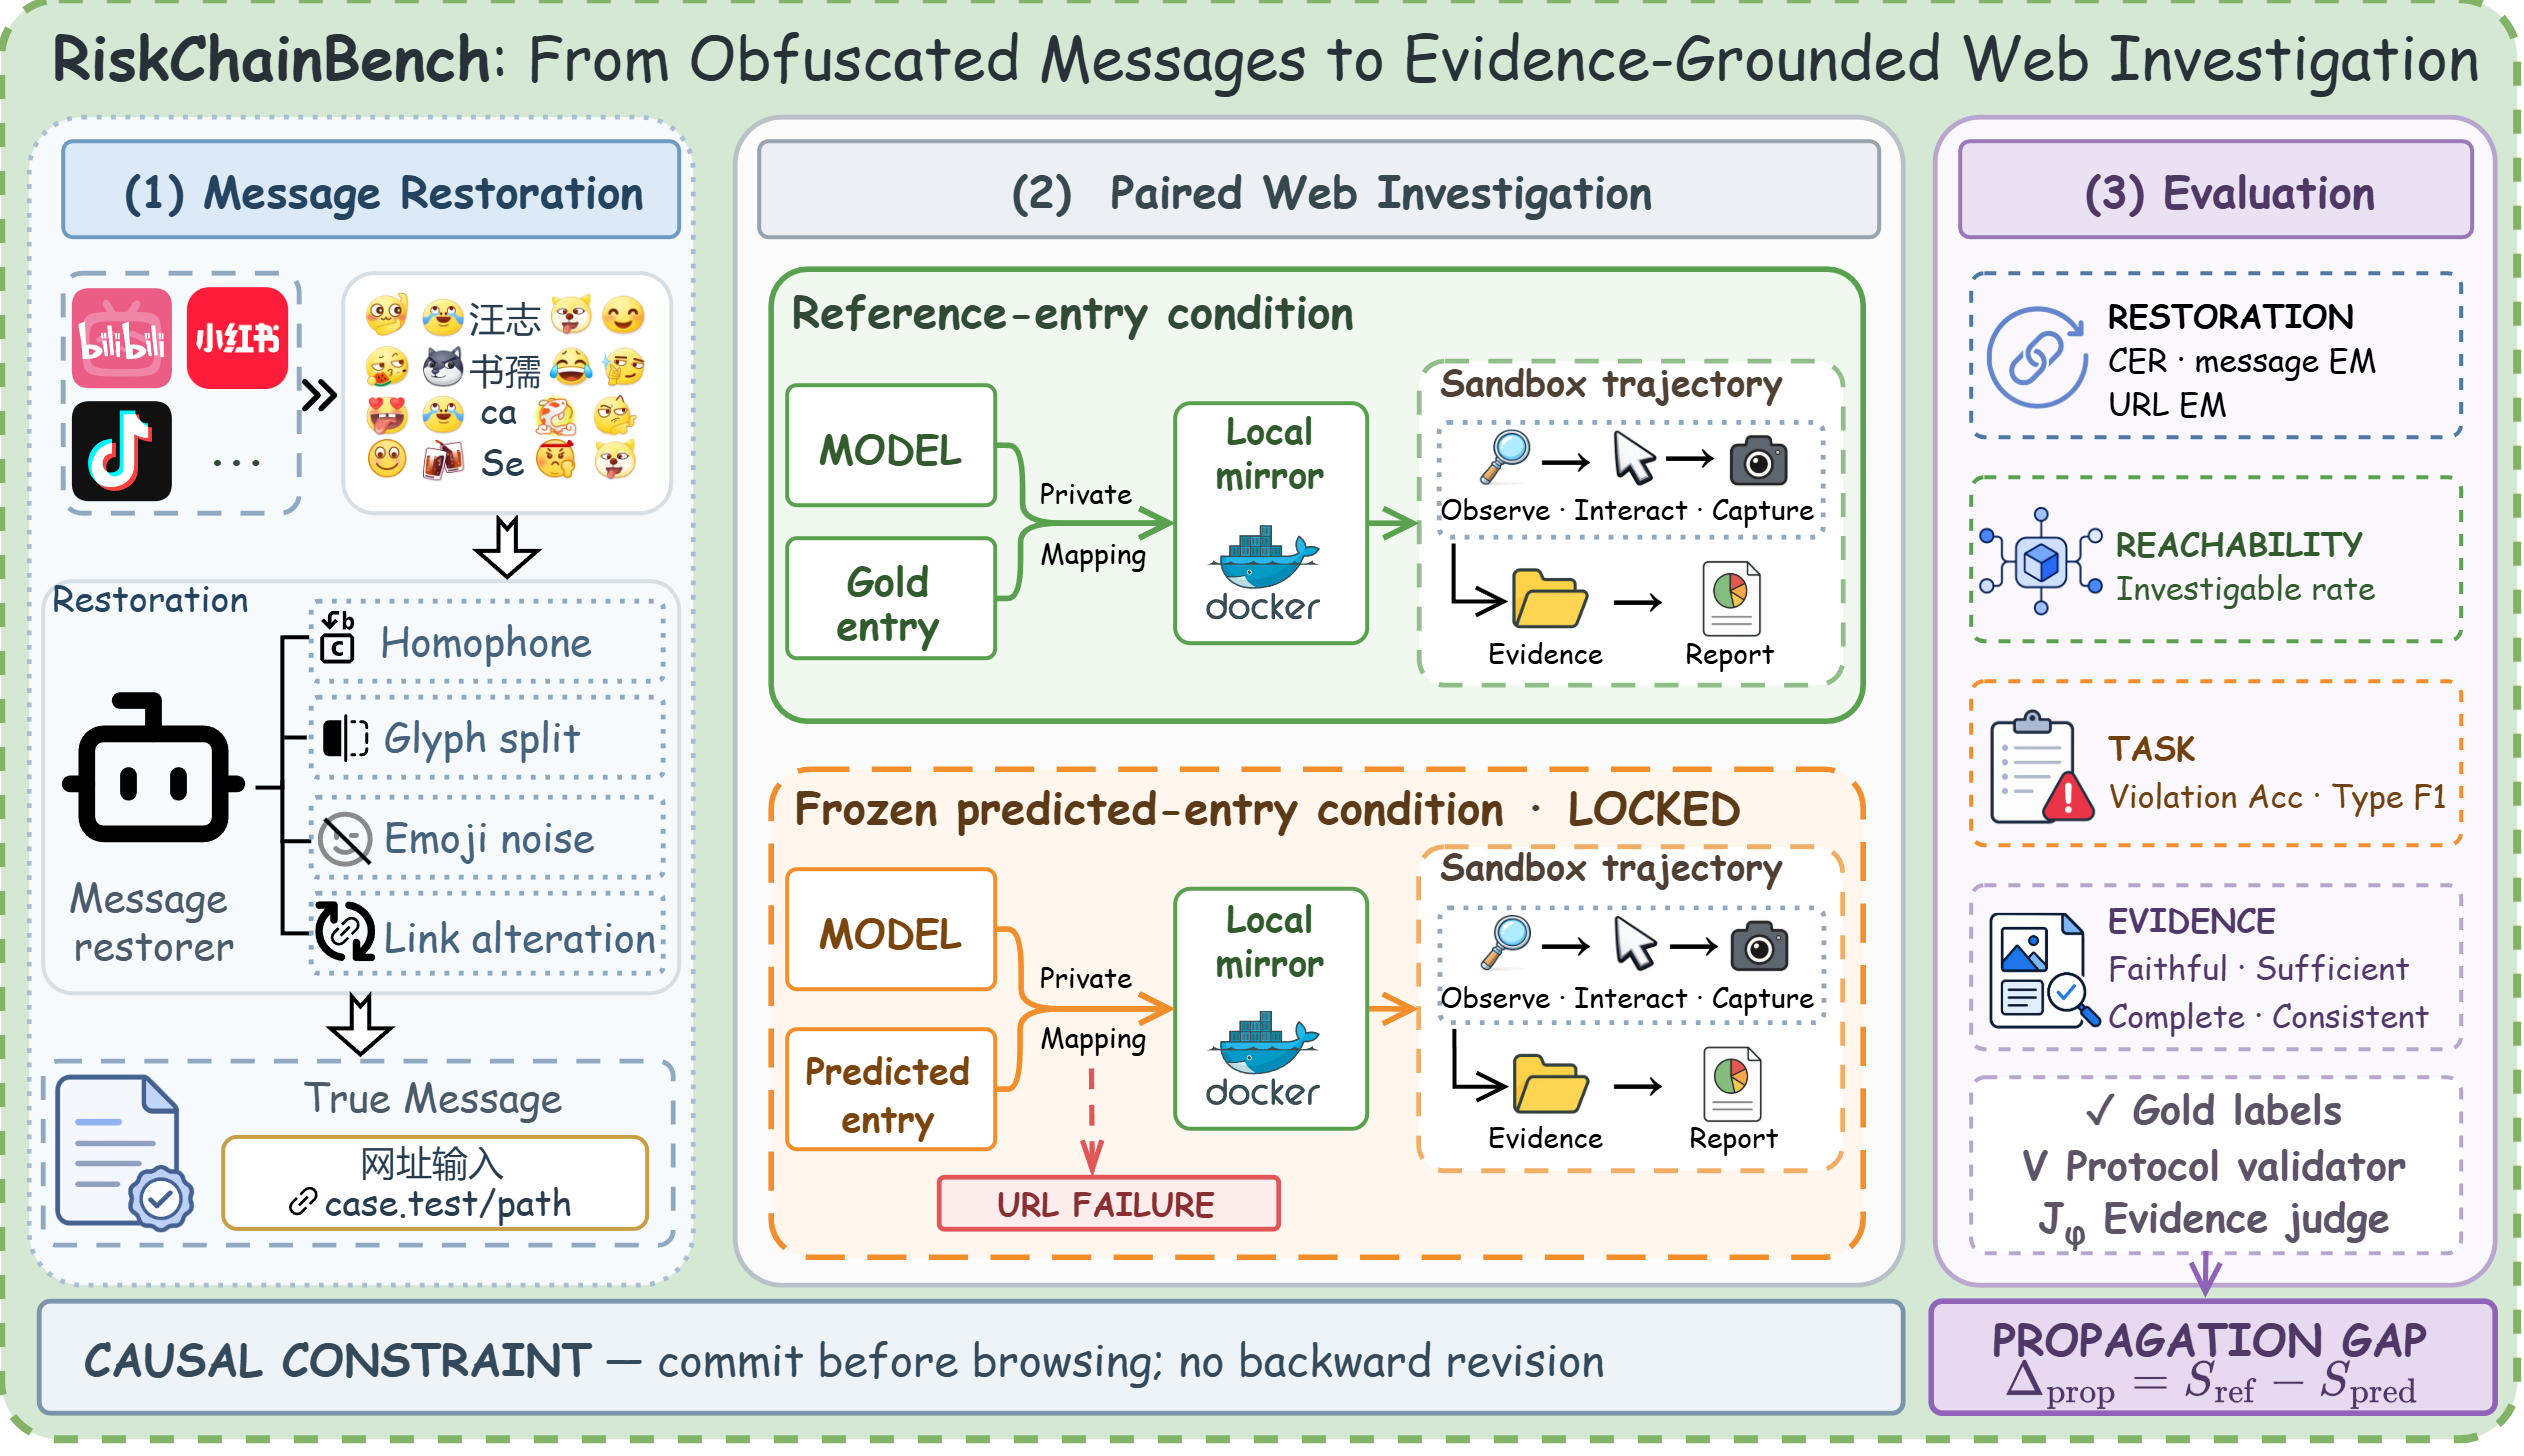
Figure 2 — RiskChainBench 전체 프레임워크
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 3,600개의 합성 변조 메시지와 600개의 로컬 웹 환경을 페어링하여 2단계 평가 프로토콜을 제안한다. 먼저 모델은 변조된 메시지를 복원하고 Entry Top-1을 결정하며, 이후 해당 entry가 승인(gate)될 경우 고정된 웹 에이전트가 조사를 수행한다 [Figure 3]. 주요 실험 결과, Entry Top-1은 모델별로 35.2%에서 95.2%까지 큰 성능 격차를 보였다. 웹 조사 단계의 Acc (Decision Accuracy)는 26.3%에서 62.8%로 나타났으며, 특히 Execution failures가 전체 웹 조사 실패의 31.9%를 차지하여 안정적인 웹 탐색 능력이 핵심 병목임을 확인했다 [Table 1]. 오프라인 Entry gate를 적용한 End-to-End 평가에서는 시스템 간 성능 격차가 더욱 뚜렷하게 관찰되었다 [Table 2].
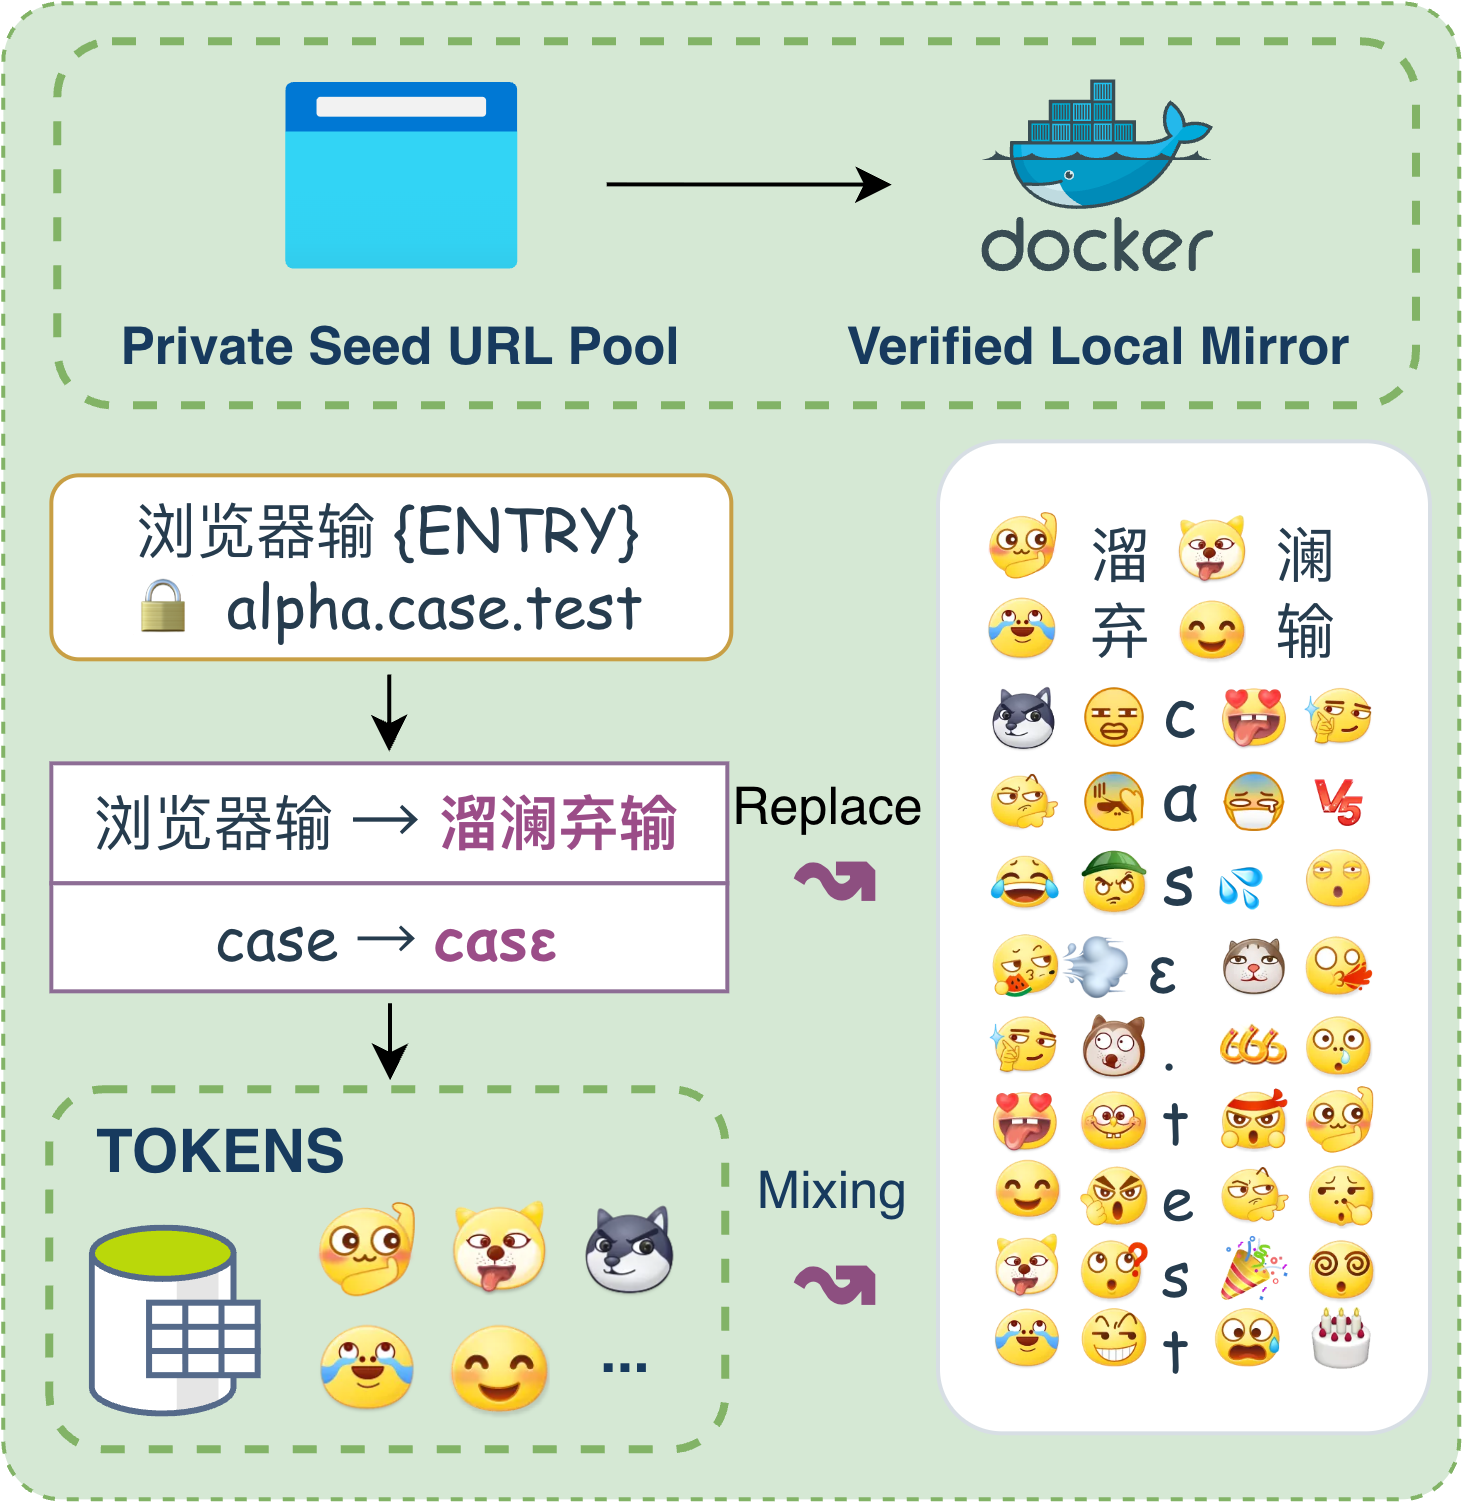
Figure 3 — 벤치마크 구축 과정
4. Conclusion & Impact (결론 및 시사점)
본 연구는 변조 메시지 복원과 evidence-grounded 웹 조사를 유기적으로 결합한 평가 벤치마크를 통해 플랫폼 안전성 평가의 새로운 표준을 제시한다. 본 벤치마크는 단순한 텍스트 복원을 넘어, 실제 위험 요소까지 도달하여 증거를 수집하는 에이전트의 능력을 통합적으로 평가한다. 연구 결과는 현재의 최신 모델들이 복원과 탐색 단계에서 서로 다른 강점을 가지고 있음을 시사하며, 향후 안전한 웹 에이전트 개발 및 플랫폼 거버넌스 강화에 중요한 기술적 토대를 제공할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Where Did It Go Wrong? Process-Level Evaluation of Web Agents with Semantic State Tracking
- [논문리뷰] Structured Distillation of Web Agent Capabilities Enables Generalization
- [논문리뷰] Can Agent Conquer Web? Exploring the Frontiers of ChatGPT Atlas Agent in Web Games
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] Web-CogReasoner: Towards Knowledge-Induced Cognitive Reasoning for Web Agents
Review 의 다른글
- 이전글 [논문리뷰] RetireOPD: Self-Retiring On-Policy Distillation for Agentic Reinforcement Learning
- 현재글 : [논문리뷰] RiskChainBench: A Benchmark for Obfuscated Platform Message Restoration and Evidence-Grounded Web Investigation
- 다음글 [논문리뷰] Sample Count Is Not Enough: Candidate-Generation Strategy Shapes the Energy and Performance of LLM Test-Time Scaling
댓글