[논문리뷰] Sample Count Is Not Enough: Candidate-Generation Strategy Shapes the Energy and Performance of LLM Test-Time Scaling
링크: 논문 PDF로 바로 열기
메타데이터
저자: Mobina Kashaniyan, Ali Jannesari
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Test-Time Scaling: LLM 추론 단계에서 여러 후보(candidate) 응답을 생성하고 조합하여 추론 능력을 향상시키는 기법입니다.
- Candidate Count ($N$): 추론 시 생성되는 전체 후보 응답의 개수를 의미합니다.
- Generation Schedule: 후보 응답을 생성하는 방식(전체 생성 요청 횟수와 호출당 배치 크기의 조합)을 정의하며, 본 논문에서는 $\mathcal{S}=(b_1, \dots, b_C)$로 표기합니다.
- Gross GPU-device Energy: 특정 추론 작업 동안 GPU에서 소비되는 총 에너지를 의미하며, 추론의 전체 시스템 비용을 평가하는 주요 지표입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 LLM의 Test-Time Scaling 연구에서 흔히 사용하는 Candidate Count ($N$) 만으로는 추론의 실제 시스템 비용을 충분히 설명할 수 없다는 문제를 제기합니다. 기존 연구들은 단순히 몇 개의 후보를 생성했는지만 보고할 뿐, 이를 어떤 Generation Schedule로 실행했는지에 대한 상세 정보가 누락되어 있습니다. 동일한 **$N$**을 생성하더라도 이를 한 번의 배칭 호출로 처리하는지, 혹은 다수의 순차적 호출로 나누어 처리하는지에 따라 Latency, Throughput, GPU-hours, Energy 소모량에서 극명한 차이가 발생합니다 [Figure 1]. 이러한 보고 관행의 부재는 시스템 효율성을 정확히 비교하고 재현하는 데 걸림돌이 되고 있습니다.
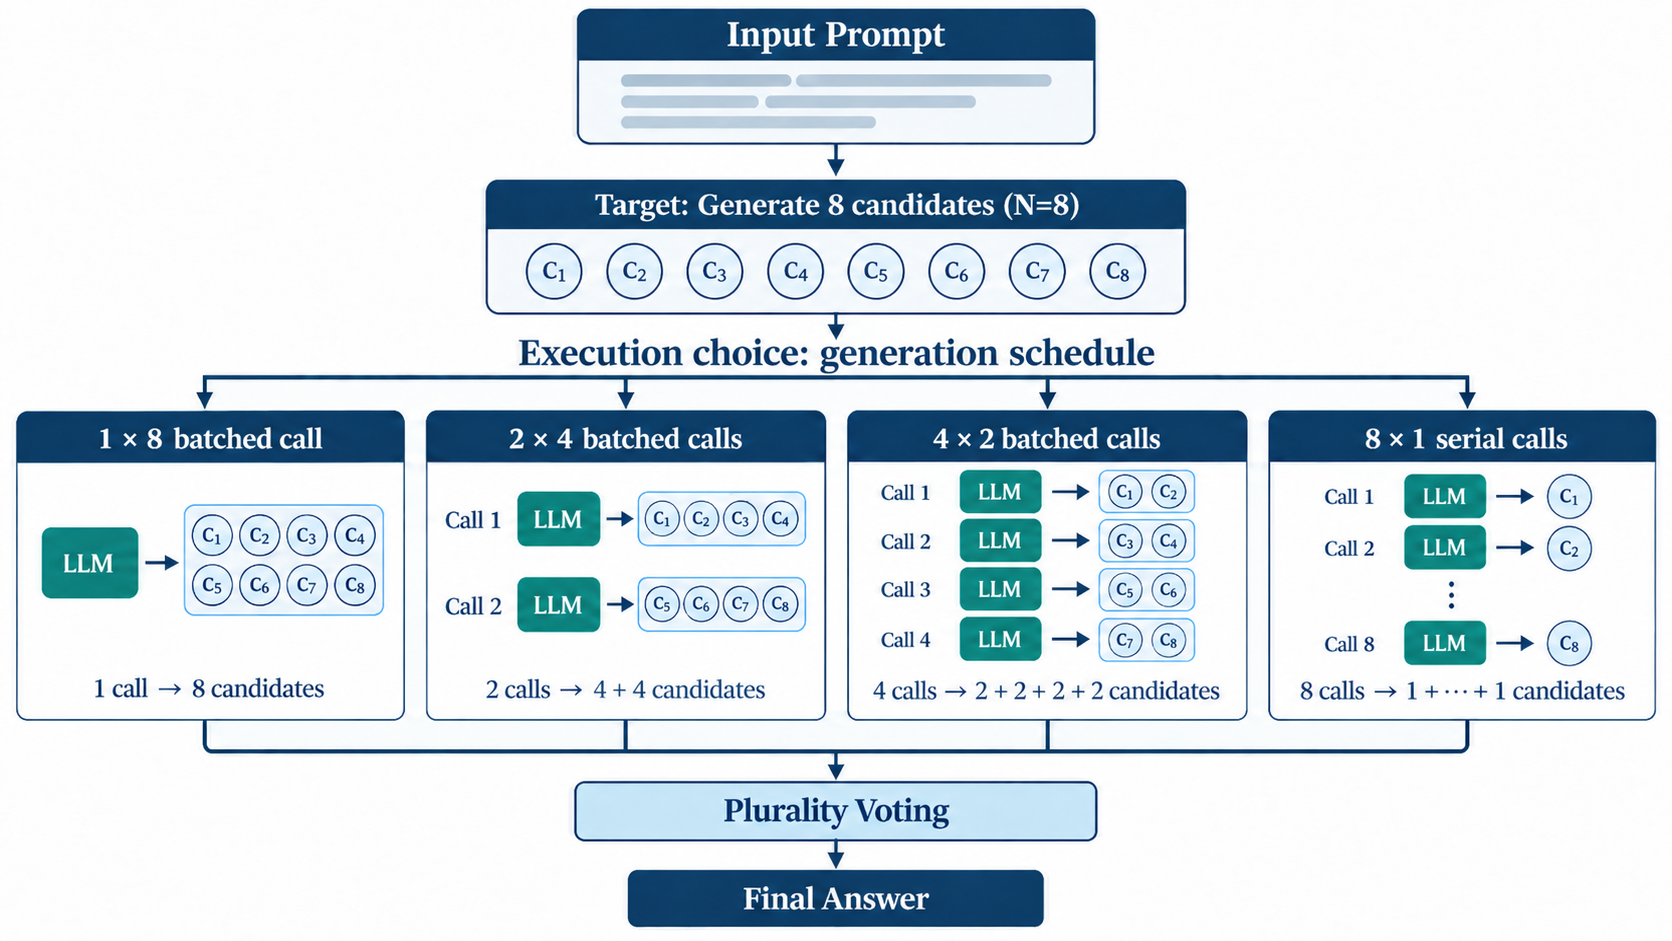
Figure 1 — N=8 시 생성 스케줄 예시
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 **$N=8$**로 고정된 후보군을 생성할 때 1×8, 2×4, 4×2, 8×1의 네 가지 Generation Schedule을 비교하여 시스템 비용을 분석했습니다. 실험 결과, 후보 생성 단위를 쪼개어 호출 횟수를 늘릴수록 시스템 효율성이 급격히 저하되는 경향이 관찰되었습니다 [Table VI]. A100 GPU 기반 환경에서 8×1 스케줄은 1×8 스케줄 대비 4.64~4.86배 더 많은 Gross GPU-device Energy를 소모하며, P95 Latency 또한 5.77~6.12배 증가하는 결과를 보였습니다. 이러한 현상은 다양한 노드 환경 및 SciQ와 같은 짧은 출력 워크로드에서도 일관되게 나타났습니다 [Table VIII]. 정량적 지표 분석 결과, Batch Size를 크게 가져가는 것이 Token당 에너지 효율을 높이고 총 실행 시간을 최적화하는 데 유리함이 입증되었습니다.
## 4. Conclusion & Impact (결론 및 시사점) 본 연구는 Test-Time Scaling의 시스템 비용이 단순히 후보 개수만이 아닌 Generation Schedule에 의해 결정됨을 입증했습니다. 따라서 독립적인 후보 생성 환경에서는 가능한 한 배치 크기를 최대화하여 생성 호출 횟수를 줄이는 방식이 가장 효율적입니다. 향후 학계 및 산업계의 연구는 단순한 정확도 지표뿐만 아니라, Generation Schedule과 Systems Metrics를 투명하게 공개하여 추론 비용의 재현성과 비교 가능성을 높여야 할 것입니다.
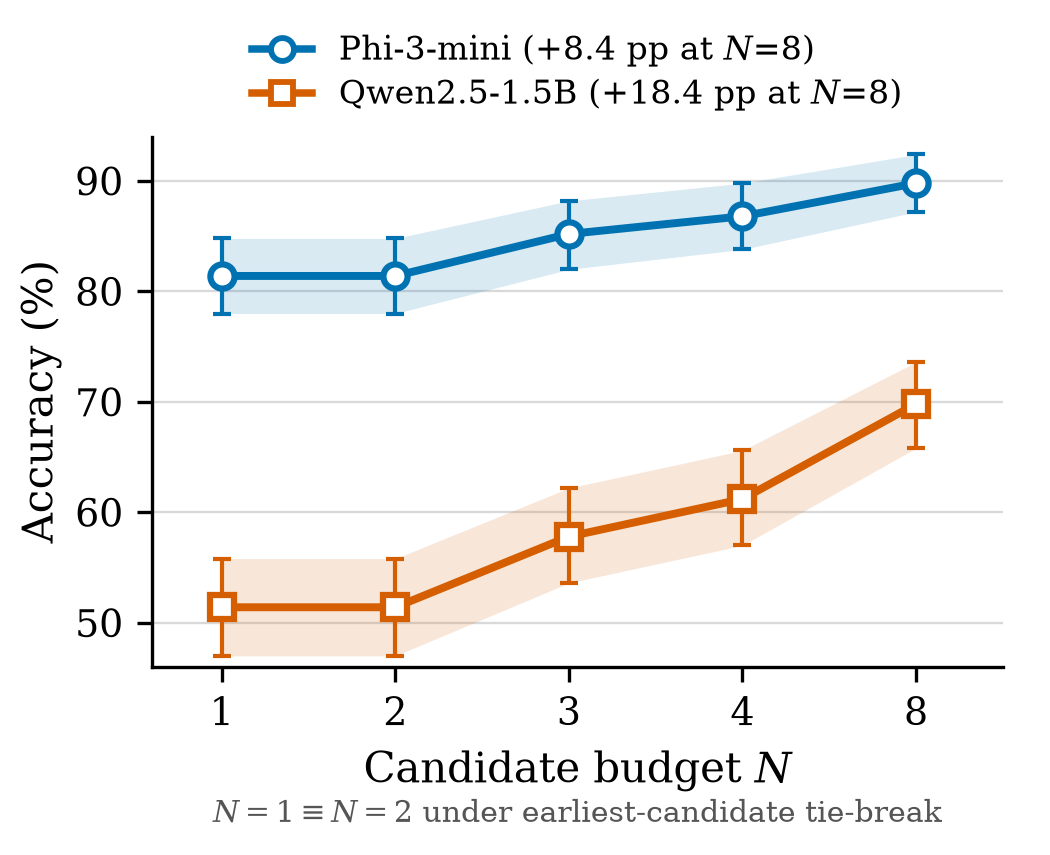
Figure 2 — 후보군 수에 따른 정확도
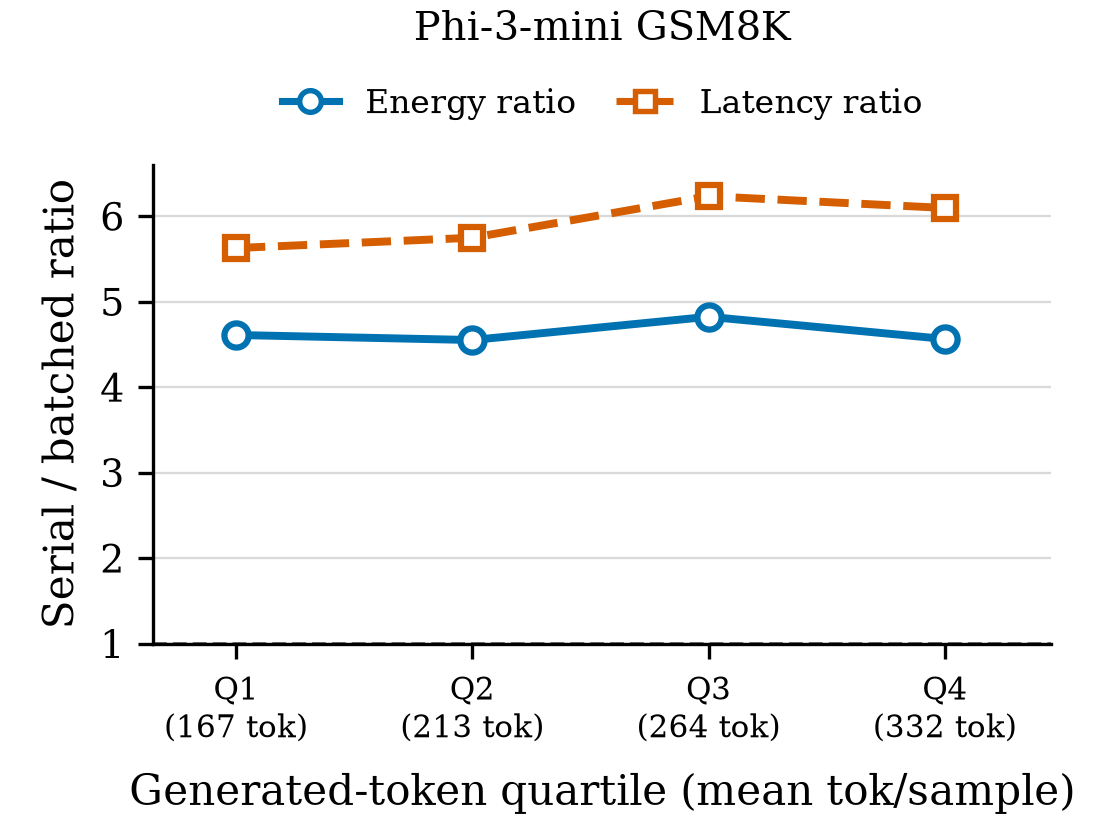
Figure 3 — Phi-3 길이별 에너지 비율
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ParaTempo: Efficient Parallel Reasoning via Temporal Confidence
- [논문리뷰] Small RL Controller, Large Language Model: RL-Guided Adaptive Sampling for Test-Time Scaling
- [논문리뷰] Depth-adaptive Inference of Looped Language Models via Continuous Depth Batching
- [논문리뷰] The Other Half of the Memory Wall: Serving 35B MoEs from SSD with Trained Routing Prediction
- [논문리뷰] Fathom: Per-Query Read Depth for Sparse Decoding over Offloaded KV Caches
Review 의 다른글
- 이전글 [논문리뷰] RiskChainBench: A Benchmark for Obfuscated Platform Message Restoration and Evidence-Grounded Web Investigation
- 현재글 : [논문리뷰] Sample Count Is Not Enough: Candidate-Generation Strategy Shapes the Energy and Performance of LLM Test-Time Scaling
- 다음글 [논문리뷰] SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness
댓글