[논문리뷰] Region-Level Policy Optimization for Fine-grained MLLM Perception
링크: 논문 PDF로 바로 열기
저자: Yuheng Shi, Xiaohuan Pei, Minjing Dong, Chang Xu et al.
1. Key Terms & Definitions
- MLLM (Multimodal Large Language Models): 시각 및 언어 정보를 통합적으로 이해하고 처리하는 대규모 언어 모델을 지칭합니다.
- Fine-grained Perception: 이미지 내의 작은 텍스트, 멀리 있는 객체, 또는 복잡한 고해상도 장면과 같은 미세한 시각적 디테일을 정확하게 인지하는 능력을 의미합니다.
- RoI (Region of Interest): 이미지에서 특정 질문이나 작업에 가장 관련성이 높은 영역을 식별하는 것을 말합니다.
- SD-RPN (Self-Distilled Region Proposal Network): MLLM의 내부 어텐션에서 잠재된 접지 신호(grounding signal)를 효율적인 Region of Interest(RoI) 예측기로 증류(distill)하는 방법론입니다.
- Vision-RL^2^: 본 논문에서 제안하는 Region-Level Reinforcement Learning 방법으로, RoI 예측기를 학습시켜 MLLM이 정답에 필요한 시각적 증거를 더 효과적으로 식별하고 활용하도록 합니다.
2. Motivation & Problem Statement
본 논문은 MLLM의 Fine-grained Perception 능력 향상을 위해 해상도를 높이는 기존 방식이 Visual Token 및 Language Model Pre-filling 비용을 과도하게 증가시키는 문제를 해결하고자 합니다. MLLM이 미세한 디테일 인식에 어려움을 겪는 주된 원인은 입력 이미지 해상도 증가 시 시각 토큰 수가 급증하여 연산 비용이 비효율적으로 사용되기 때문입니다. Fine-grained Visual Question Answering(VQA)은 일반적으로 관심 영역(RoI)을 localizing하고 그 내용을 recognizing하는 두 가지 작업으로 구성되는데, 저자들은 localization이 recognition보다 약 3-4배 더 강한 Token Compression을 허용한다는 비대칭성을 진단했습니다 [Figure 1]. 기존 SD-RPN과 같은 효율적인 RoI Predictor들은 MLLM 어텐션으로부터 Pseudo-label을 Self-distill하여 훈련되지만, 이 Surrogate Objective는 스퓨리어스(spurious) 활성화를 포함하거나 필요한 증거를 누락할 수 있으며, 정답과의 직접적인 연관성 검증이 부족하다는 한계가 있습니다. 이러한 한계는 Predictor가 정답 수준의 신호를 Region-level 크레딧과 함께 받지 못하기 때문에 발생하며, 이는 새로운 최적화 접근 방식의 필요성을 제기합니다.
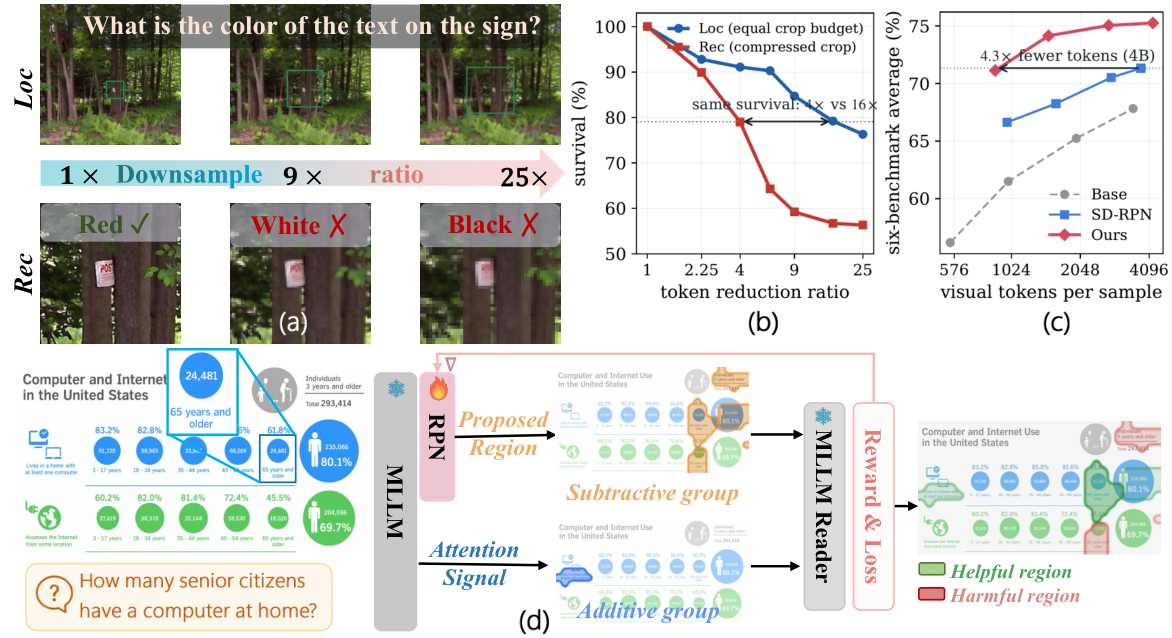
Figure 1 — Localization vs. Recognition 압축 내성 및 Vision-RL^2^ 개요
3. Method & Key Results
저자들은 SD-RPN Predictor의 단일 패스(single-pass) 효율성을 유지하면서 Fine-grained MLLM Perception을 최적화하기 위해 **Vision-RL^2^**를 제안합니다 [cite: 1, Figure 2]. 이 방법론은 일관된 시각적 영역(coherent visual regions)을 액션(actions)으로 간주하고, Frozen MLLM Reader가 각 영역을 제거했을 때 정답(gold answer)의 Teacher-forced Likelihood 변화를 기반으로 기능적 기여도(functional contribution)를 평가합니다. Vision-RL^2^는 두 가지 주요 정책 그룹을 통해 RoI Map을 최적화합니다. 첫째, Subtractive Policy는 기여도가 노이즈 마진(noise margin) 이하인 예측된 영역을 제거하여 불필요한 Distracting Proposal을 억제합니다. 둘째, Additive Policy는 Reader가 긍정적인 기여도를 보고한 누락된 증거(missing evidence)를 복구합니다. 이러한 과정은 Region Annotation, Response Sampling 또는 Reasoning Trajectory 없이 Predictor만 업데이트합니다.
또한, 저자들은 예측된 RoI를 활용하는 Sparse Visual Encoding을 제안하여, Visual-token Budget을 이미지 영역이 아닌 실제 증거(evidence)에 집중시킵니다 [cite: 1, Figure 3]. 이는 배경 토큰을 제외하고 전경 토큰(foreground tokens)만 더 높은 해상도로 재인코딩함으로써 효율성을 극대화합니다. 실험 결과, Vision-RL^2^는 6개의 Fine-grained 벤치마크와 4개의 MLLM 백본에 걸쳐 Base Model 대비 모든 Token Budget에서 정확도를 향상시켰습니다 [cite: 1, Figure 4]. 특히, Qwen3.5-4B 모델에서 Base Model의 최대 Budget 정확도를 약 4.2배 더 적은 Visual Token으로 능가했습니다 [cite: 1, Figure 1]. 최고 성능을 보인 Qwen3.5-9B 모델은 평균 80.1%의 정확도를 달성하며 Gemini-3.1-Pro (79.3%) 및 Vision-OPD-9B를 포함한 기존 SoTA 모델들을 상회했습니다 [cite: 1, Table 1]. 효율성 분석에서는 Vision-RL^2^의 4B 모델이 1,024-token Limit에서 SD-RPN의 4,096-token Limit보다 2.1배 낮은 Latency로 더 높은 정확도를 달성하며 Accuracy-Latency Trade-off에서 우위를 입증했습니다 [cite: 1, Figure 4]. Ablation Study는 Region-level RL이 SD-RPN 대비 평균 +3.0점, Sparse Visual Encoding이 추가로 +1.5점의 성능 향상에 기여했음을 보여주었습니다 [cite: 1, Table 2].
4. Conclusion & Impact
본 논문은 시각적 증거의 localization이 recognition보다 훨씬 더 큰 Token Compression을 감당할 수 있다는 중요한 비대칭성을 정량적으로 입증했습니다. Vision-RL^2^는 이 비대칭성을 활용하여 Lightweight RoI Predictor를 Reinforcement Learning 기반으로 최적화하며, Frozen MLLM Reader로부터 얻은 Functional Contribution Signal을 통해 정답에 대한 책임감(answer-accountability)을 부여합니다. 이 방법론은 Region Annotation이나 Response Sampling 없이 작동하며, 다양한 Fine-grained 벤치마크와 MLLM 백본에서 Base Model 및 기존 Supervised Predecessor보다 우수한 정확도와 효율성을 달성합니다. Vision-RL^2^는 재사용 가능하고 Decode-free한 Localizer를 제공하며, 이는 향후 컴퓨테이션 자원 할당을 결정하는 다른 인터페이스에도 유사한 원칙을 적용할 수 있는 중요한 시사점을 제공합니다.
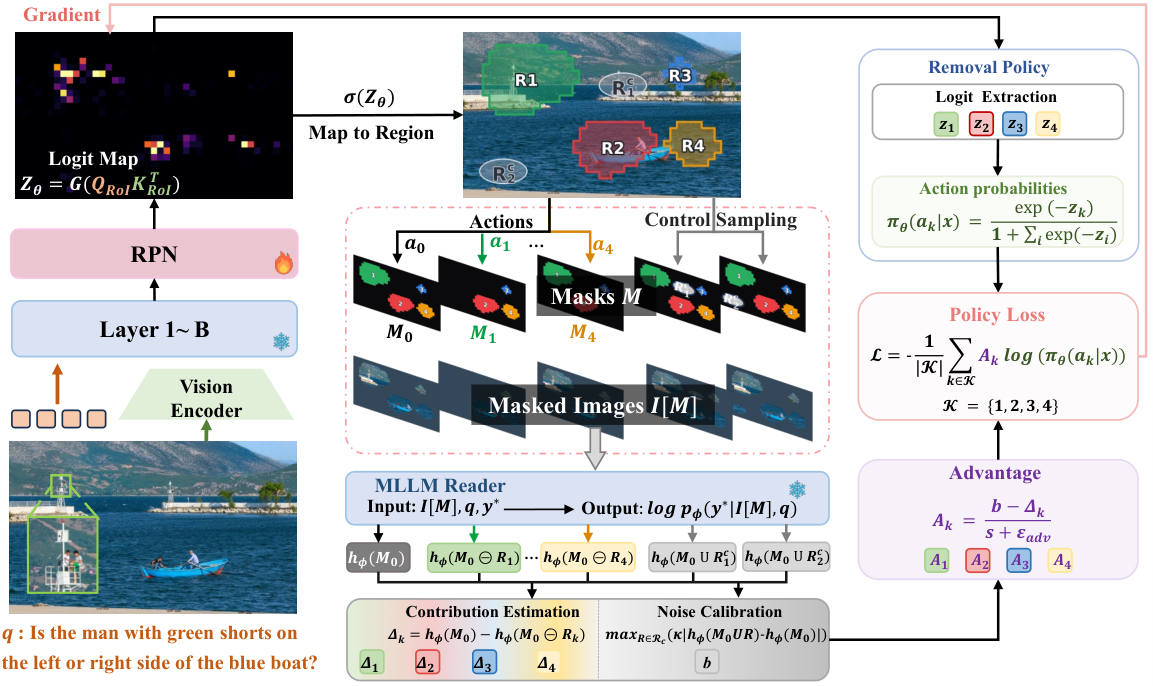
Figure 2 — 제안된 Region-Level RL 방법론 개요
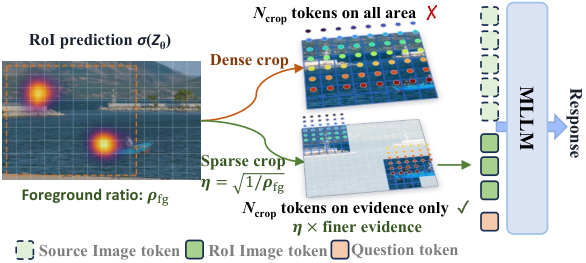
Figure 3 — Sparse Visual Encoding 방식
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Read It Back: Pretrained MLLMs Are Zero-Shot Reward Models for Text-to-Image Generation
- [논문리뷰] Towards One-to-Many Temporal Grounding
- [논문리뷰] EVA: Efficient Reinforcement Learning for End-to-End Video Agent
- [논문리뷰] ProactiveBench: Benchmarking Proactiveness in Multimodal Large Language Models
- [논문리뷰] Trust Your Critic: Robust Reward Modeling and Reinforcement Learning for Faithful Image Editing and Generation
Review 의 다른글
- 이전글 [논문리뷰] Reflect, Revise, Reuse: Training-Free Skill Evolution for GUI Agents
- 현재글 : [논문리뷰] Region-Level Policy Optimization for Fine-grained MLLM Perception
- 다음글 [논문리뷰] RetireOPD: Self-Retiring On-Policy Distillation for Agentic Reinforcement Learning
댓글