[논문리뷰] CADWorld: Computer-Use Benchmark for Long-Horizon Computer-Aided Design
링크: 논문 PDF로 바로 열기
메타데이터
저자: Zihan Dong, Yuanzhe Liu, Zhiyuan Ma, Qishi Zhan, Dehan Kong, Guohao Li, Kaixin Li
1. Key Terms & Definitions (핵심 용어 및 정의)
- Computer-Use Agents (CUA): 자연어 지시사항을 해석하여 GUI 환경에서 마우스, 키보드 등의 UI 명령을 통해 실제 소프트웨어를 조작하는 자율 에이전트입니다.
- Artifact-Grounded Evaluation: 단순한 텍스트 답변이나 시각적 유사성을 넘어, 최종 결과물인 CAD 파일이 구조적, 기하학적, 기능적으로 유효한지 검증하는 평가 방식입니다.
- Long-Horizon Workflow: 수십에서 수백 단계의 복잡한 조작을 요구하며, 이전 단계의 조작이 후속 단계의 결과에 영향을 미치는 상태 의존적(State-dependent) 작업 과정을 의미합니다.
- FreeCAD: 본 논문에서 벤치마크 환경으로 채택한 오픈소스 파라메트릭 3D CAD 모델러로, 자동화된 검증을 지원하고 편집 가능한 결과물을 생성합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 일반적인 GUI 작업에 특화된 기존 Computer-Use Benchmark들이 기계공학 분야의 전문적인 CAD 워크로드를 충분히 다루지 못한다는 문제의식에서 출발합니다. 기존 연구들은 주로 웹 탐색이나 단순 데스크탑 작업에 집중되어 있어, 엔지니어링 설계의 핵심인 기하학적 제약 조건 유지, 상태 추적, 그리고 결과물의 검증 가능성을 보장하지 못합니다. 실제 CAD 작업은 단순히 버튼을 클릭하는 수준을 넘어, Feature History와 Parametric Structure를 보존해야 하는 정교한 공정입니다 [Figure 1]. 따라서 저자들은 전문적인 설계 워크로드를 수행하고, 그 결과가 엔지니어링 표준을 준수하는지 확인할 수 있는 새로운 벤치마크 시스템이 필요하다고 판단했습니다.
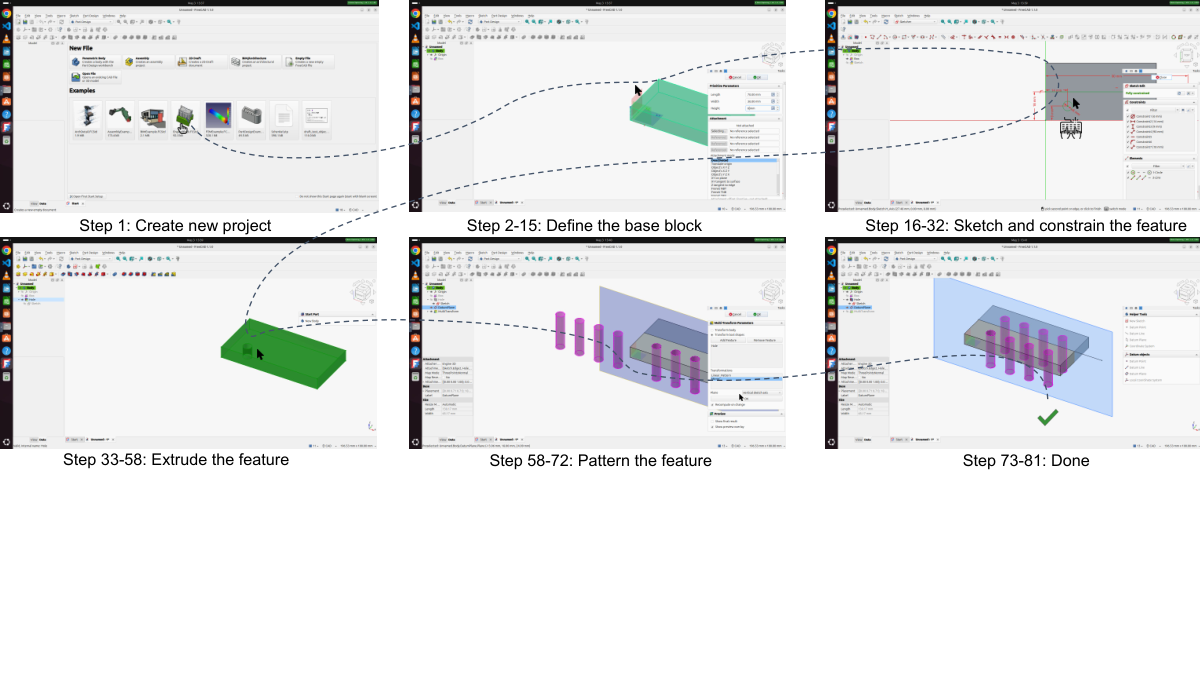
Figure 1 — FreeCAD 워크로드 과정
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 11개의 기계공학 CAD 워크로드 범주(스케치, 파트 모델링, 조립, CAM, FEM 등)를 아우르는 200개의 태스크로 구성된 CADWorld 벤치마크를 제안합니다. 각 태스크는 자연어 지시사항으로 시작하며, 에이전트는 GUI 스크린샷과 UI 조작을 통해 FreeCAD 환경에서 작업을 수행합니다 [Figure 2]. 에이전트의 성과를 평가하기 위해, 저자들은 스케치 엔티티, 치수 제약 조건, 모델 기하학적 특성, CAM 경로, FEM 해석 결과 등을 프로그램 방식으로 직접 검증하는 Artifact-Grounded Evaluators를 도입했습니다 [Figure 3]. 실험 결과, 최상위 모델인 GPT5.4(CUA)는 17.5%의 성공률을 기록했으며, 이는 전문가 수준인 87.0%의 참조 통과율과 큰 격차를 보입니다 [Table 3]. 성능이 낮은 모델들은 주로 초기 GUI 탐색 단계에서 '데스 루프(Death-loop)'에 빠져 결과물을 저장하지 못하는 반면, 상위 모델들은 작업을 끝까지 수행하더라도 구조적, 기하학적 요구사항을 충족하지 못하는 '하류(Downstream) 실패'를 보이는 경향이 확인되었습니다 [Figure 4].
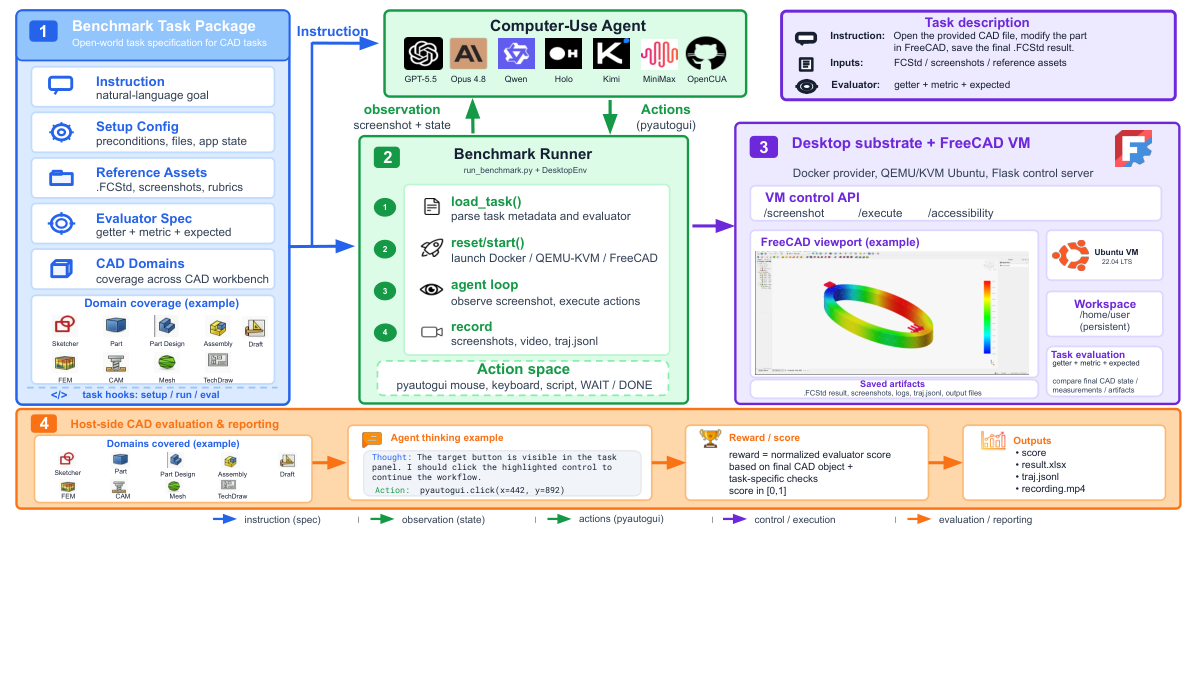
Figure 2 — CADWorld 워크플로우
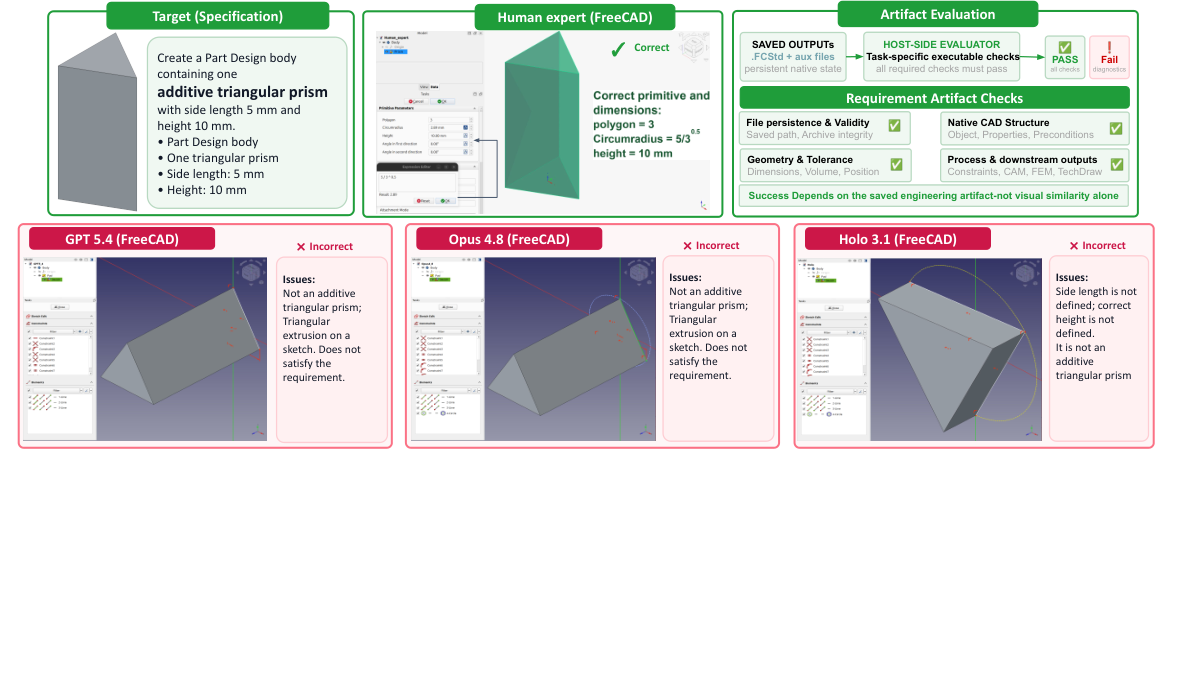
Figure 3 — 태스크 및 평가 예시
4. Conclusion & Impact (결론 및 시사점)
본 논문은 전문 기계공학 CAD 환경에서 Computer-Use Agent의 성능을 측정하는 최초의 종합적인 벤치마크 CADWorld를 확립했습니다. 연구 결과는 현재의 일반적인 GUI 에이전트가 고도의 상태 의존적인 엔지니어링 워크로드를 수행하기에는 여전히 역부족임을 시사합니다. 이 연구는 단순히 버튼을 클릭하는 능력을 넘어, 설계 의도를 파악하고 지속 가능한 엔지니어링 결과물을 생성하는 방향으로 에이전트 개발이 나아가야 할 필요성을 제시합니다. 향후 학계와 산업계에서는 CADWorld를 통해 에이전트의 시각적 Grounding 능력과 논리적 추론 능력, 그리고 공학적 정밀성을 통합적으로 평가할 수 있을 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Emergence World: Adversarial Stress-Testing of Long-Horizon Multi-Agent Systems
- [논문리뷰] E-Commerce Bench: Evaluating LLM Agents on Long-Horizon Autonomous Business Operation
- [논문리뷰] CAST: Critique-Aware Supervision for Training Reliable Long-Horizon Tool-Calling Agents
- [논문리뷰] Long-Horizon Audio-Visual Generation for Persistent Stories and Interactive Worlds
- [논문리뷰] GUI-Primitives: Diagnosing Spatial Reasoning Failures in Vision-Language GUI Grounding
Review 의 다른글
- 이전글 [논문리뷰] BI-Agent and BI-Bench: Towards Automating End-to-End Business Intelligence
- 현재글 : [논문리뷰] CADWorld: Computer-Use Benchmark for Long-Horizon Computer-Aided Design
- 다음글 [논문리뷰] Calibrating Teacher--Student Discrepancy for On-Policy Distillation
댓글