[논문리뷰] When AI Reviews Train AI Reviewers: Scientific-Judgment Collapse and Mitigation
링크: 논문 PDF로 바로 열기
저자: Sy-Tuyen Ho, Minghui Liu, Furong Huang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Scientific-Judgment Collapse: 모델이 생성한 리뷰로 모델을 반복 학습시킬 때, 평가 척도(Rating distribution)가 압축되고 의미적 다양성(Semantic diversity)이 감소하며 판단의 범위가 좁아지는 현상입니다.
- TrustReviewer: Scientific-judgment collapse를 완화하기 위해 제안된 LLM 기반 피어 리뷰 생성 시스템으로, 데이터 선별 및 테스트 시점의 활성화 조정을 포함합니다.
- Paired Activation Steering: 모델이 생성한 리뷰와 실제(Official) 리뷰의 hidden state 차이를 contrastive하게 분석하여, 생성 과정 중 모델의 판단을 보정하는 테스트 시점의 추론 기법입니다.
- Recursive AI Review Training: 앞선 세대의 모델이 생성한 리뷰가 다음 세대 모델의 학습 코퍼스로 유입되어, 판단의 편향이 강화되거나 모델 간의 유사성이 증폭되는 순환 학습 구조를 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM이 과학적 피어 리뷰에 도입되면서 발생하는 recursive training 기반의 판단 편향 문제를 해결하고자 합니다. 기존 연구들은 생성 데이터에 의존한 반복 학습이 데이터 분포를 왜곡하고 저확률 영역을 소멸시키는 모델 붕괴(model collapse)를 유발함을 지적해 왔습니다. 학계에서는 이러한 AI 리뷰가 미래의 학습 코퍼스로 유입될 경우, 과학적 판단의 다양성이 위협받을 수 있다는 우려가 제기되고 있습니다. 하지만 구체적으로 LLM 기반 리뷰어의 판단이 얼마나 어떻게 편향되는지에 대한 실증적 분석은 부족한 실정입니다. 저자들은 이를 정량적으로 측정하기 위해 통제된 환경에서 recursive AI 리뷰어 학습 프레임워크를 설계하였습니다 [Figure 1].
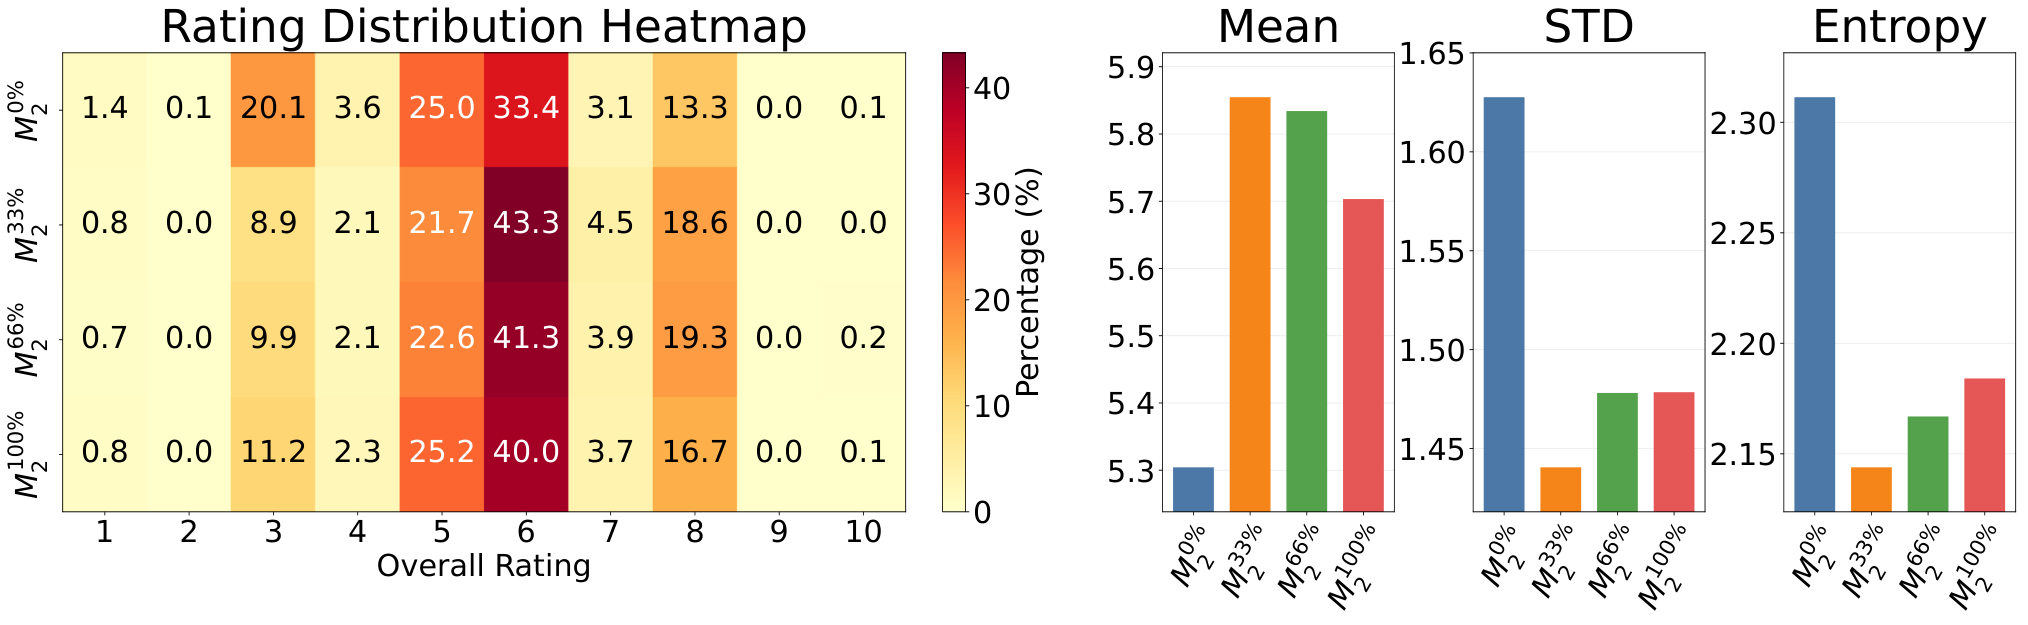
Figure 1 — 학습 프레임워크
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Scientific-judgment collapse를 완화하기 위해 데이터 품질 관리와 추론 시점의 제어를 결합한 TrustReviewer를 제안합니다. 우선 TrustReviewer는 2018년부터 2025년까지의 공식 ICLR 리뷰 코퍼스를 정교하게 필터링하여 저품질 및 중복 데이터를 배제한 뒤 Llama 3.1 8B 모델을 단일 단계(one-stage) SFT로 학습시킵니다. 이후, 테스트 시점에서는 Paired Activation Steering 기법을 사용하여 생성된 리뷰와 실제 리뷰 간의 hidden state 차이를 학습하고, 이를 디코딩 과정에 반영하여 판단의 다양성을 보존합니다. 실험 결과, 100% 합성 데이터로 학습된 모델은 기존 모델 대비 rating entropy를 약 0.15~0.25 가량 낮추며 심각한 판단 압축을 보여주었으나, TrustReviewer는 최적의 Exact Match 비율인 75.40%와 가장 높은 Rating Entropy(2.18)를 기록하며 판단의 보편성과 다양성을 동시에 확보했습니다 [Table 1]. 또한, TrustReviewer는 corpus-level semantic spread와 same-paper semantic distance 측면에서 기존 베이스라인 모델들을 상회하는 성능을 입증하였습니다 [Figure 4].
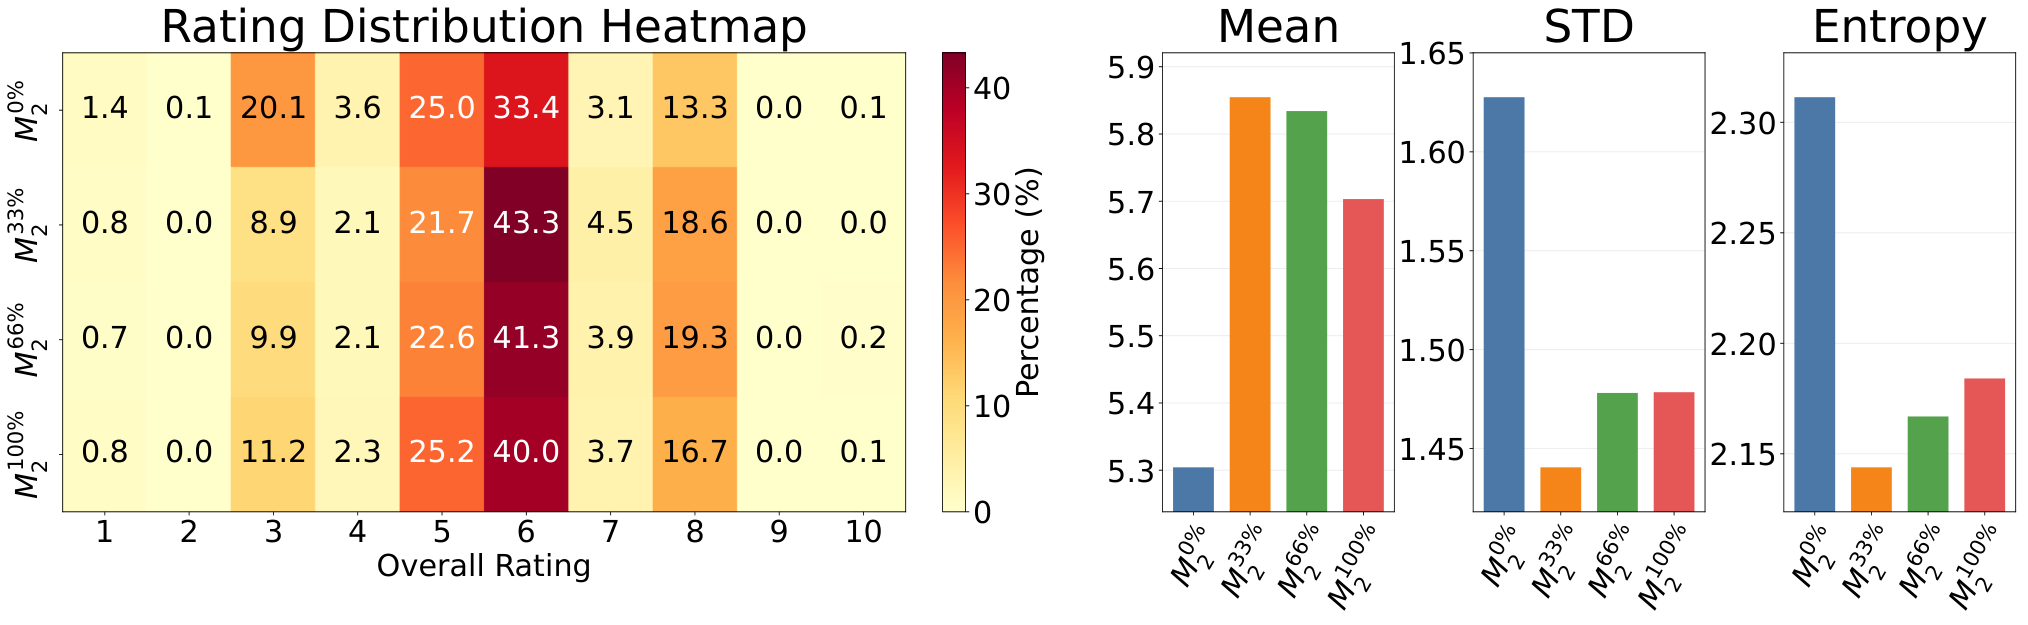
Figure 4 — 리뷰어 간 의미적 다양성 비교
4. Conclusion & Impact (결론 및 시사점)
본 논문은 recursive AI 학습이 과학적 평가의 다양성을 저해하는 Scientific-judgment collapse를 유발함을 입증하고, 이에 대한 효과적인 완화 전략을 제시합니다. 연구 결과는 생성형 AI가 과학계의 동료 평가 체계에 통합되는 과정에서 데이터 오염과 판단의 균질화가 실질적인 위험 요소임을 시사합니다. 제안된 TrustReviewer는 추가적인 학습이나 전문가 주석 없이도 활성화 제어를 통해 모델의 판단력을 개선할 수 있음을 보여주었으며, 향후 AI 지원 과학 평가 시스템의 설계 원칙과 품질 관리에 중요한 기초 자료를 제공할 것으로 기대됩니다.
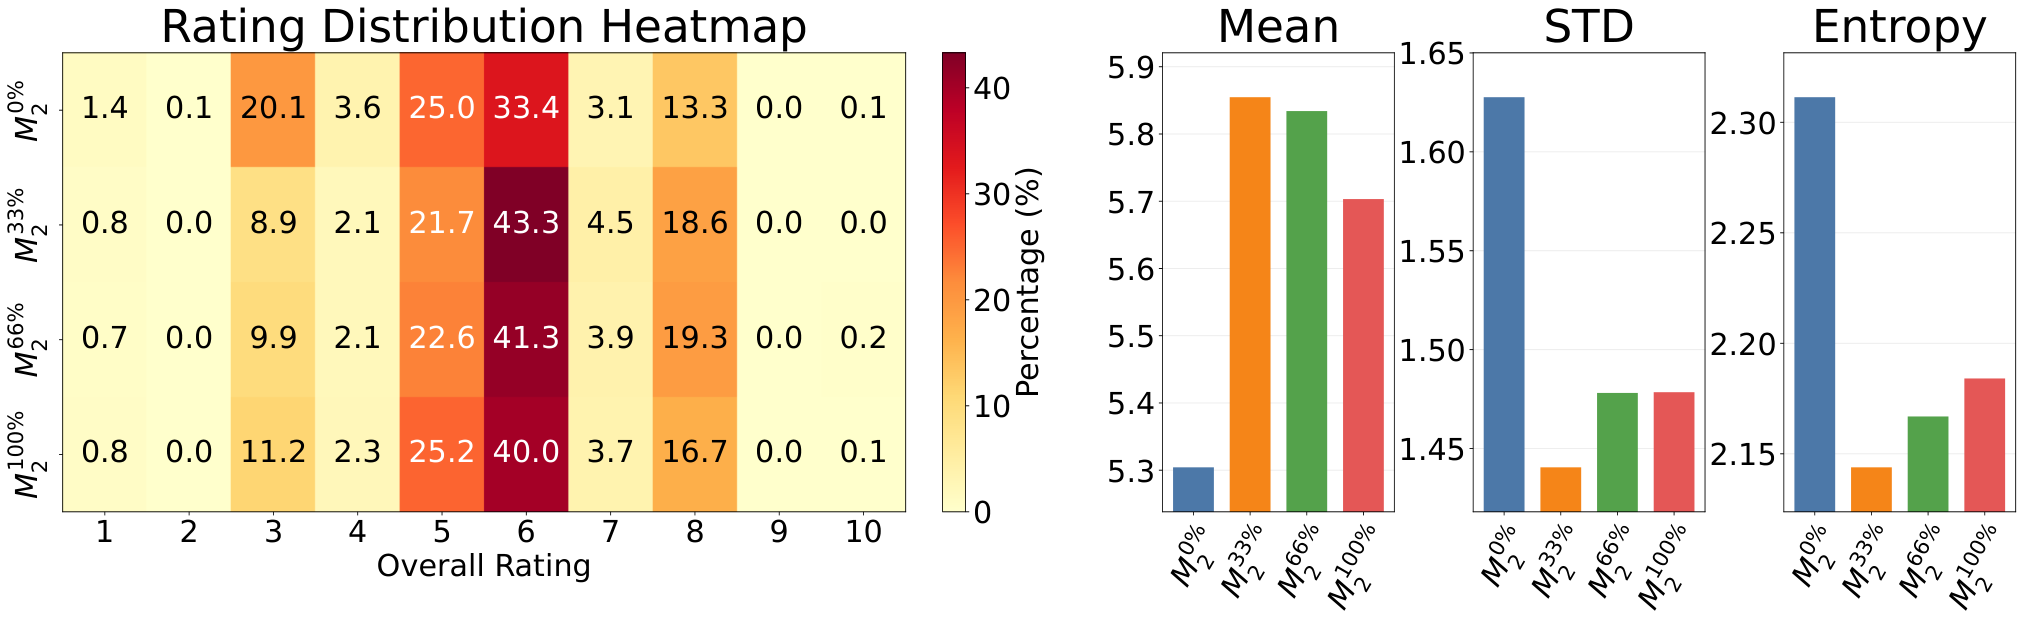
Figure 3 — 의미적 다양성 저하 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Prism-Δ: Differential Subspace Steering for Prompt Highlighting in Large Language Models
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] Game Arena: Strategic LLM Evaluation in Competitive Environments
- [논문리뷰] CodeGraph: Open-Taxonomy Knowledge Graph for Source Code with Wikidata Grounding
- [논문리뷰] From Pattern Recognizers to Personalized Companions: A Survey of Large Language Models in Mental Health
Review 의 다른글
- 이전글 [논문리뷰] Training-Adaptive Convolutional Sparse Coding via Information Bottleneck for Robust Visual Representation
- 현재글 : [논문리뷰] When AI Reviews Train AI Reviewers: Scientific-Judgment Collapse and Mitigation
- 다음글 [논문리뷰] 1% of Tokens Can Be Enough: On Gradient Estimation in On-Policy Distillation
댓글