[논문리뷰] 1% of Tokens Can Be Enough: On Gradient Estimation in On-Policy Distillation
링크: 논문 PDF로 바로 열기
The browse tool has finished its execution.
저자: Huanxin Sheng, Zhiling Ye, et al.
1. Key Terms & Definitions
- On-Policy Distillation (OPD): 학생 모델이 생성한 궤적(rollouts)에 대해 교사 모델이 다음 토큰의 점수를 매겨 학생 모델을 훈련하는 방법론을 지칭합니다.
- Sparse On-Policy Distillation (Sparse OPD): 교사 감독(teacher supervision)을 학생이 생성한 궤적 내의 토큰 중 작은 부분집합에만 할당하는 증류(distillation) 방식을 의미합니다.
- Information-Efficiency Ratio (IER): 정보 기하학(information geometry) 관점에서 기울기(gradient) 추정의 신뢰도를 측정하는 지표로, 최적의 스칼라 기준선(optimal scalar baseline) 하에서 신호 대 잡음비(signal-to-noise ratio)로 정의됩니다.
- Fisher Information Matrix (FIM): KL 발산(KL divergence)에 의해 유도되는 국소 기하학(local geometry)에서 기울기 추정 오차를 측정하는 데 사용되는 행렬입니다.
- Log-Likelihood Ratio (ρ(a)): 특정 토큰
a에 대한 학생 모델의 확률p_a와 교사 모델의 확률q_a의 비율에 로그를 취한 값(log(p_a/q_a))으로, 기울기 계산에 사용됩니다.
2. Motivation & Problem Statement
본 논문은 Sparse OPD에서 발생하는 기울기 추정의 신뢰성 문제를 해결하고자 합니다. 기존의 On-Policy Distillation(OPD) 방법론들은 학생 모델이 생성한 궤적의 모든 토큰에 대해 교사 감독을 적용하거나, 토큰의 '유용성(usefulness)'에 기반하여 중요한 토큰을 선별했습니다. 그러나 이러한 유용성 기반 접근 방식(예: TIP, TA-OPD, Entropy, Prefix)은 샘플링된 다음 토큰으로부터 기울기를 추정할 때 발생하는 큰 샘플링 오차(sampling error)를 고려하지 않아, 유용한 교사 지침이라 할지라도 잡음이 많은 업데이트를 초래할 수 있습니다.
저자들은 기존 연구들이 주로 '유용성' 측면에 초점을 맞추고 '기울기 추정의 신뢰성(gradient estimation reliability)'을 간과하고 있다는 한계를 지적합니다. 유용성 기반 선택은 잡음이 많은 기울기 추정치를 가진 위치를 유지할 수 있고, 반대로 신뢰성 기반 선택은 실용적 가치가 적은 기울기를 가진 위치를 유지할 수 있습니다. 따라서, 효과적인 토큰 선택은 두 가지 차원, 즉 토큰의 유용성과 기울기 추정의 신뢰성을 모두 고려해야 할 필요가 있습니다.
3. Method & Key Results
본 논문은 샘플링된 OPD에서 토큰 수준(token-level) 기울기 추정의 신뢰성을 연구하고, 이를 바탕으로 Sparse OPD를 위한 새로운 토큰 선택 방법론을 제안합니다. 제안하는 방법론은 고정된 접두사(fixed prefix)에서 정보 기하학(information geometry)을 활용하여 기울기 신호(gradient signal)와 샘플링 잡음(sampling noise)을 분해합니다. 이러한 분석을 통해 저자들은 최적의 스칼라 기준선(optimal scalar baseline) 하에서 분산(variance)을 최소화하는 신호 대 잡음비(signal-to-noise ratio)인 Information-Efficiency Ratio (IER)를 도출합니다. IER은 유한한 샘플로부터 기대 토큰 기울기를 얼마나 신뢰성 있게 추정할 수 있는지를 측정합니다.
계산 비용을 줄이기 위해, 저자들은 학생 및 교사 모델의 상위 K 로짓(logits)과 샘플링된 토큰을 포함하는 후보 집합(candidate set)을 구성하여 IER을 근사합니다. 이 근사된 IER을 단독으로 사용하거나, 기존의 유용성 지표(usefulness metrics)와 소프트 OR(IER-OR) 또는 소프트 AND(IER-AND) 연산자를 통해 결합하여 토큰을 선택합니다. IER-OR은 신뢰성 또는 유용성 중 하나라도 높은 토큰을 선호하며, IER-AND는 두 가지 모두 높은 토큰을 선택합니다.
수학적 추론(mathematical reasoning) 및 의료 추론(medical reasoning) 태스크에 대한 광범위한 실험을 통해 다음과 같은 핵심 결과가 도출되었습니다:
- IER은 단독 토큰 선택기로서 경쟁력 있는 성능을 보였습니다. 0.1%의 극히 적은 토큰 예산에서도 IER은 의료 추론 태스크에서 HealthBench 전체 점수 45.25를 달성하여, 모든 토큰을 사용하는 Full OPD의 45.77에 근접했습니다. [Table 1] 이는 기울기 신뢰도를 고려한 토큰 선택이 매우 효율적임을 시사합니다.
- IER은 기존의 유용성 기반 선택기들을 보완하여 작은 토큰 예산에서 성능을 크게 향상시켰습니다. 예를 들어, JustRL-Qwen3-4B → Qwen3-1.7B 모델 쌍의 수학적 추론에서 TIP+IER-AND는 0.1% 토큰 예산으로 Full OPD를 일관되게 능가하는 강력한 성능을 보였습니다. [Table 2] 특히, Prefix와 같은 약한 기준선(baseline)의 경우 Prefix+IER-OR은 의료 추론에서 HealthBench 전체/어려움 점수를 38.30/8.68에서 44.98/19.49로 크게 개선했습니다.
- 토큰 예산(token budget)을 높인다고 해서 항상 성능이 개선되는 것은 아니며, 때로는 성능이 저하될 수도 있음이 관찰되었습니다. 이는 잡음이 많은 기울기 추정치를 가진 토큰들이 학습에 부정적인 영향을 미칠 수 있음을 시사합니다. [Figure 2, Figure 3]
- Thinking-On 및 Thinking-Off 모드 모두에서 IER의 이점이 확인되었습니다. 특히 낮은 토큰 예산에서 유용성 점수와 IER을 결합했을 때 수학적 추론 성능이 일관되게 개선되었습니다. [Figure 4]
4. Conclusion & Impact
본 논문은 Sparse OPD에서 토큰 유용성 외에 기울기 추정의 신뢰성이라는 새로운 축을 도입함으로써, 제한된 감독(supervision) 예산 하에서 효율적이고 효과적인 Large Language Models(LLMs) 증류를 위한 중요한 통찰력을 제공합니다. 저자들은 정보 기하학을 통해 기울기 신호와 샘플링 잡음을 분해하고, 그 비율인 Information-Efficiency Ratio (IER)를 제안하여 기울기 추정의 신뢰도를 정량화했습니다.
실험 결과는 IER이 단독으로도 효과적인 토큰 선택 기준이 되며, 기존의 유용성 기반 선택기들과 결합될 때 0.1%~1%와 같은 극히 적은 토큰 예산으로도 Full OPD에 필적하거나 이를 능가하는 성능을 달성할 수 있음을 입증합니다. 이 연구는 토큰 유용성과 기울기 신뢰성이 증류를 위한 토큰을 선택하는 데 있어 상호 보완적인 두 가지 핵심 요소임을 명확히 합니다. 이는 LLM의 학습 효율성을 높이고, 잡음이 많은 데이터를 걸러내어 보다 견고한 모델을 구축하는 데 기여할 수 있는 중요한 시사점을 가집니다. 궁극적으로 이는 더 적은 컴퓨팅 자원으로도 강력한 LLM을 훈련할 수 있는 길을 열어줄 수 있습니다.
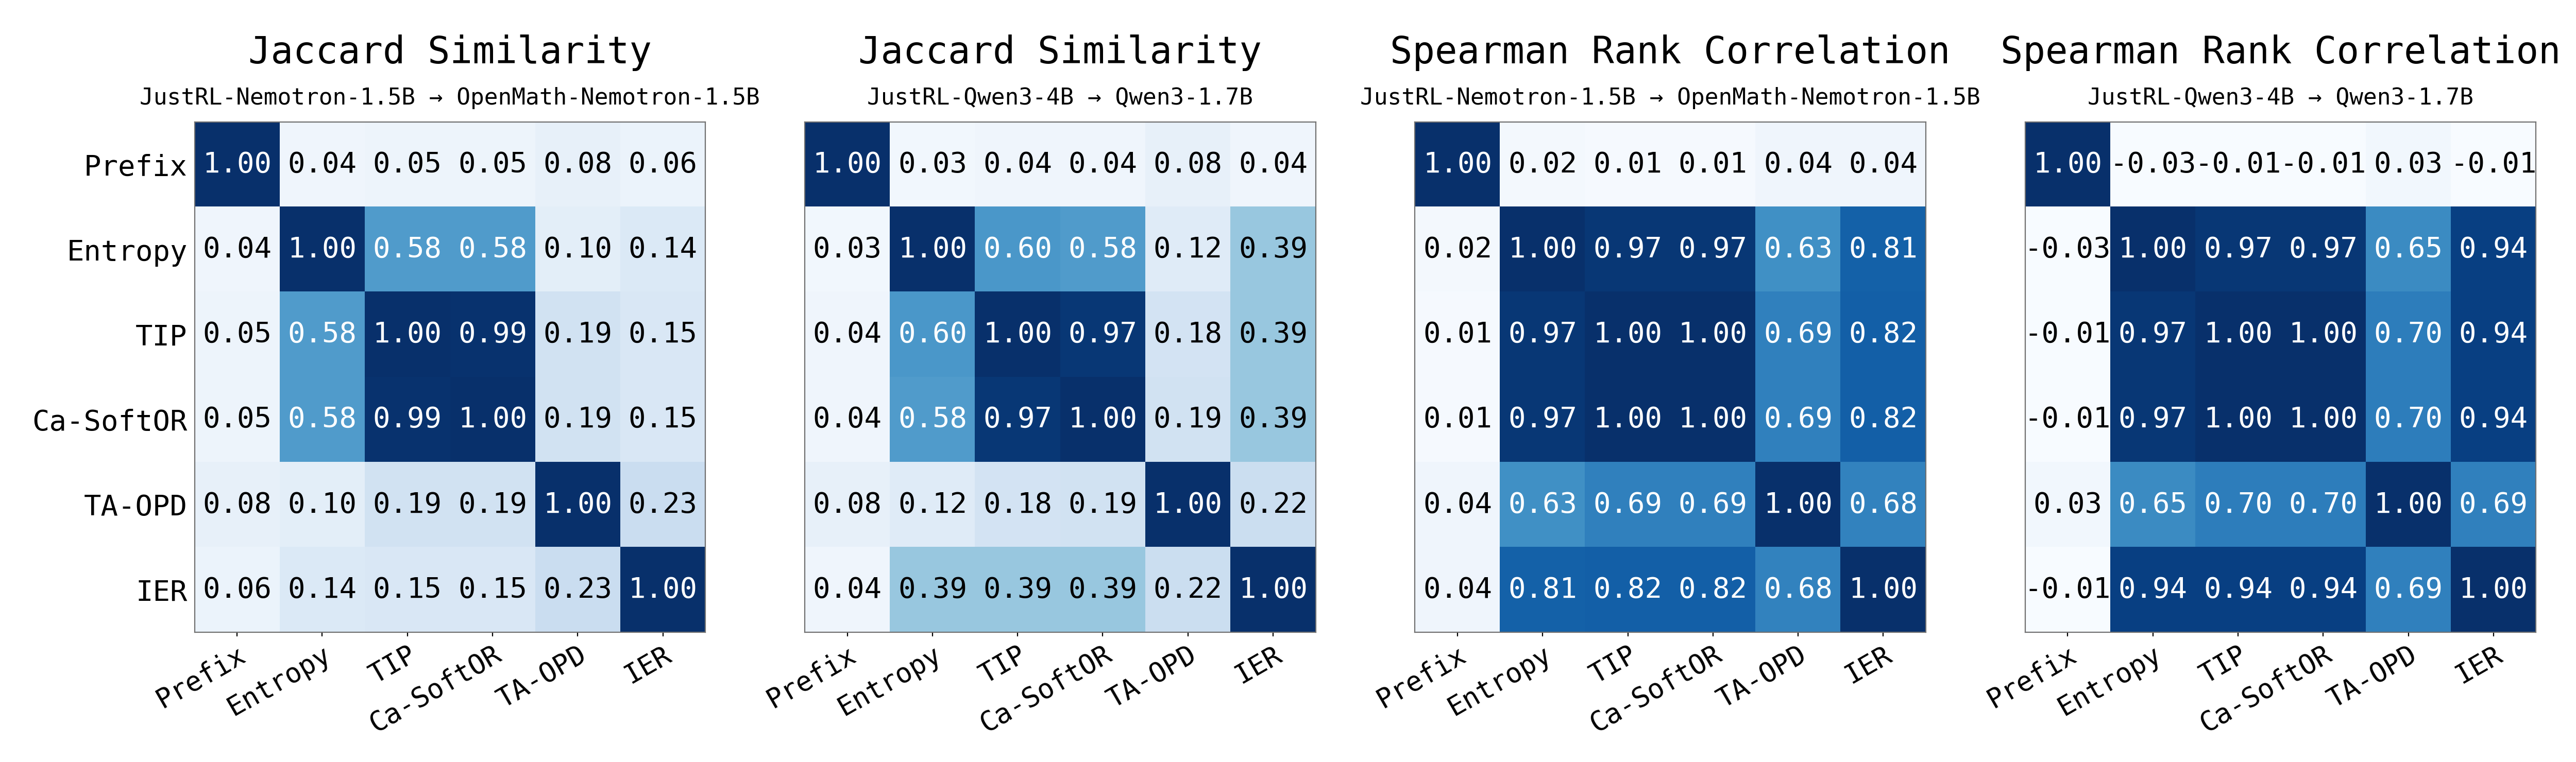
Figure 1 — 토큰 선택기 간의 상관관계 및 유사도
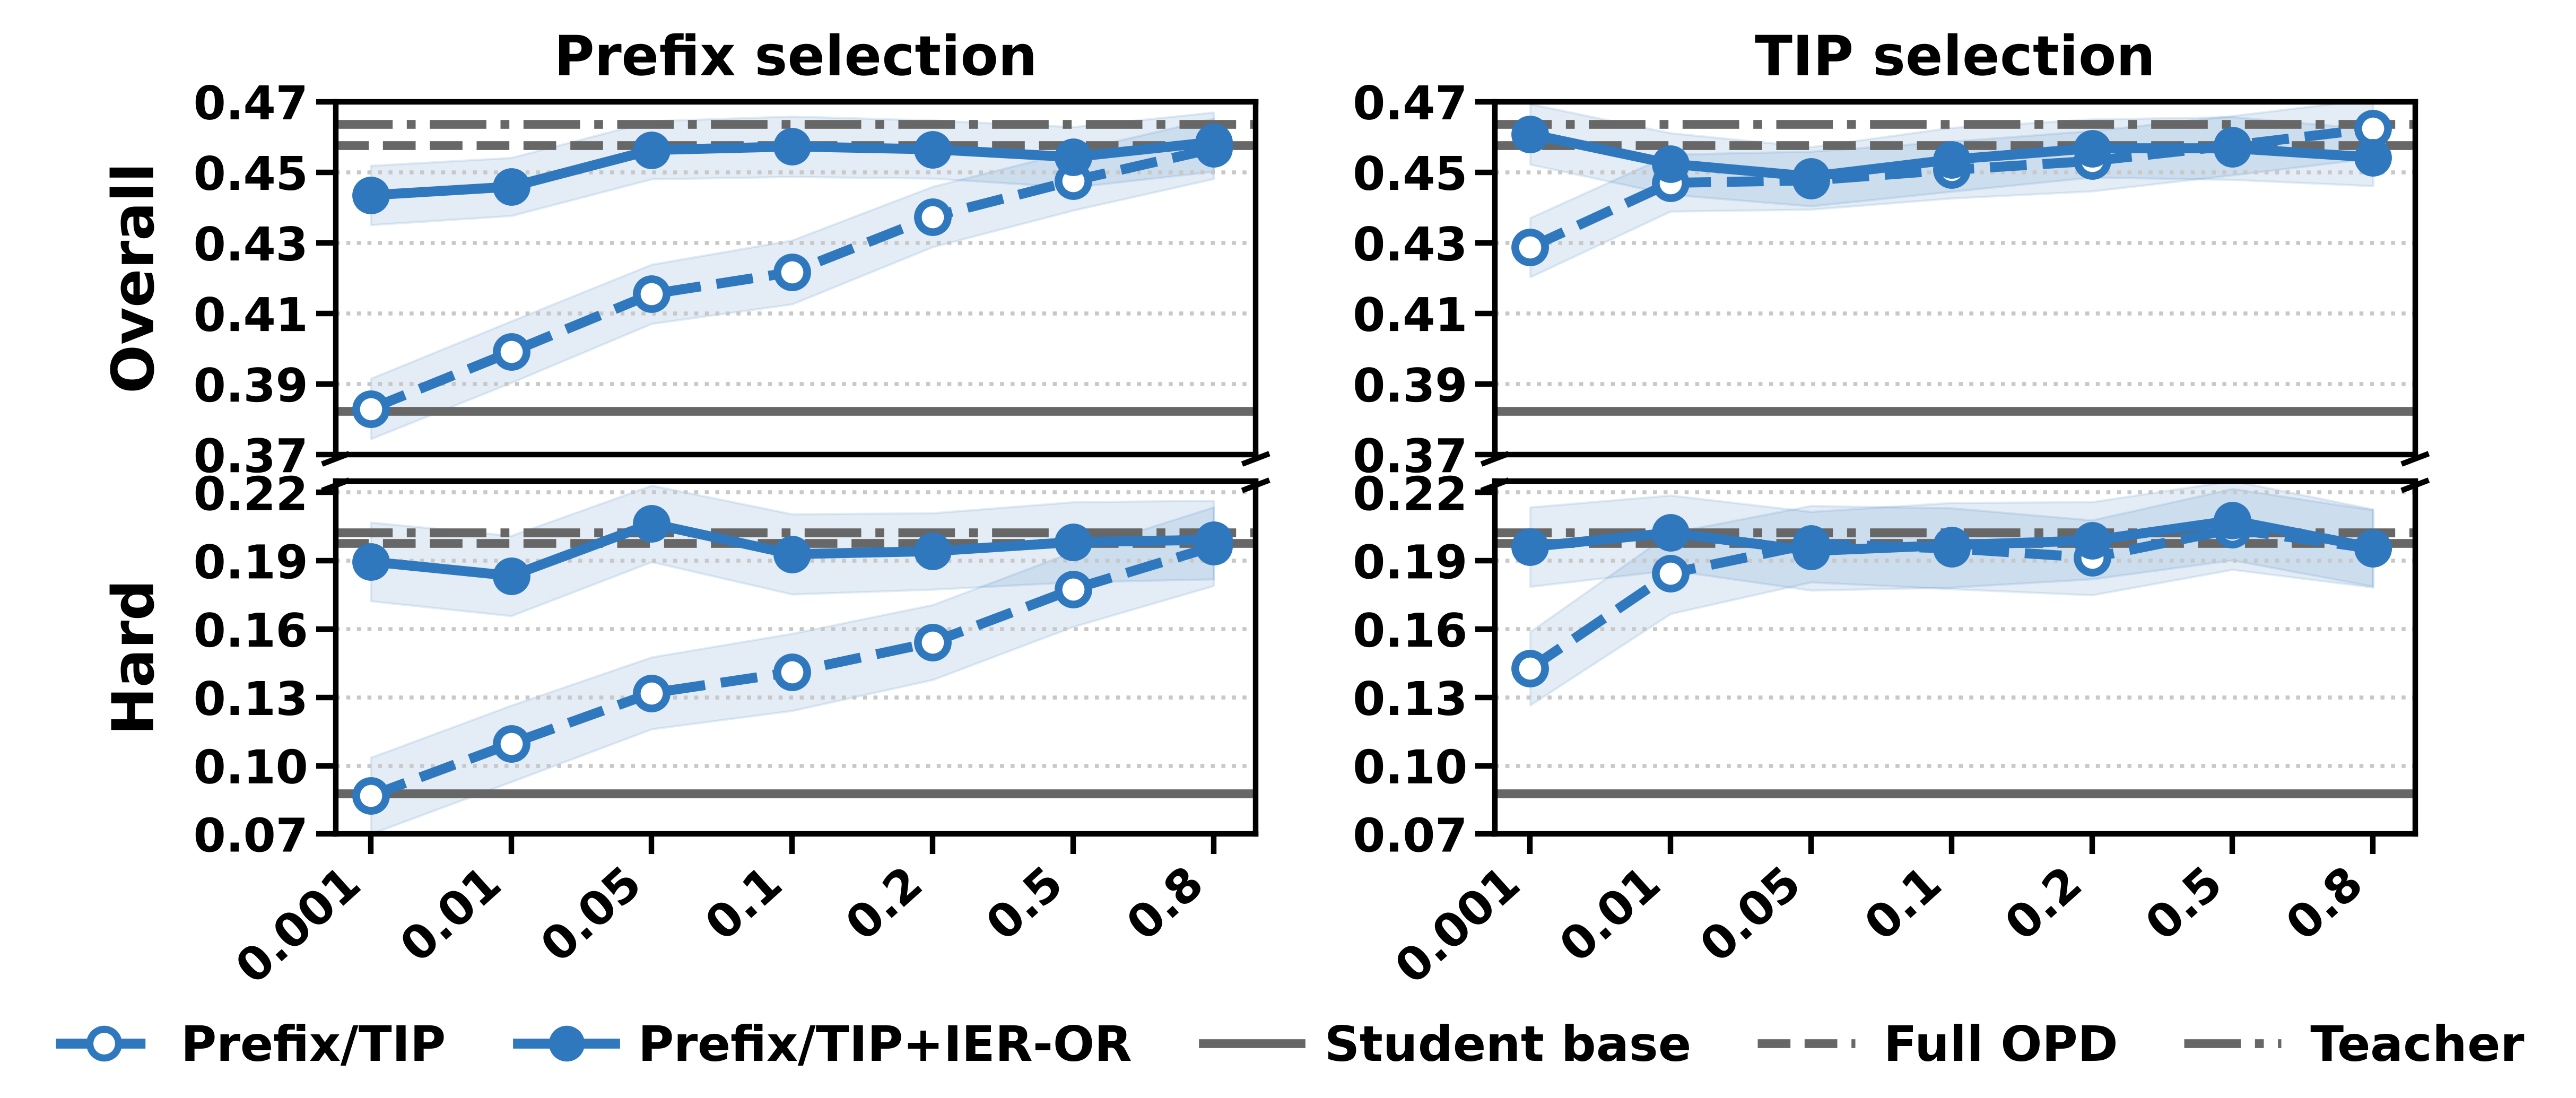
Figure 2 — 다양한 토큰 예산에서의 HealthBench 점수
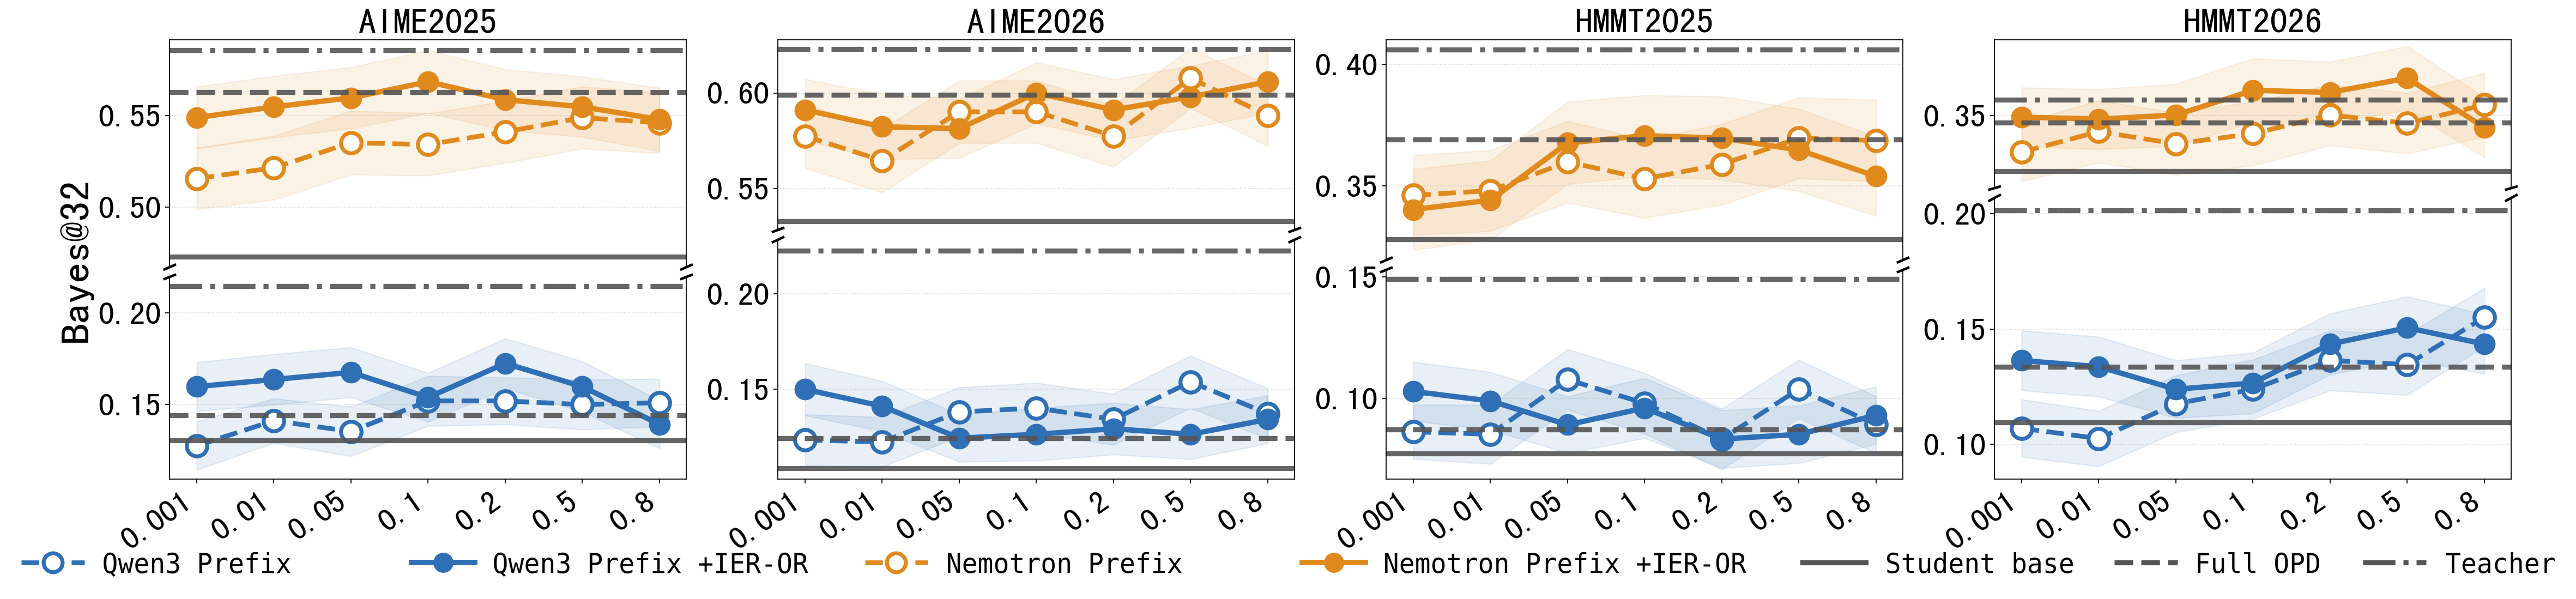
Figure 3 — 수학적 추론에서 IER 변형과 토큰 예산에 따른 Bayes@32
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Rethinking Critic Learning in PPO: Understanding and Mitigating Value Flattening
- [논문리뷰] Reference-Free Post-Training of Open Large Language Models for Multilingual Machine Translation
- [논문리뷰] When Teachers Mislead: Spurious-Signal-Aware On-Policy Distillation
- [논문리뷰] Distill Where You Fail: Recovering Learning Signals of Negative RL-Groups from Adaptive Teacher Guidance
- [논문리뷰] SAF-OPD: Stable Advantage Fusion for On-Policy Distillation
Review 의 다른글
- 이전글 [논문리뷰] When AI Reviews Train AI Reviewers: Scientific-Judgment Collapse and Mitigation
- 현재글 : [논문리뷰] 1% of Tokens Can Be Enough: On Gradient Estimation in On-Policy Distillation
- 다음글 [논문리뷰] A Lie Detector Test for Language Models: Reading Knowledge a Model Won't Reveal
댓글