[논문리뷰] Deep Persona: A Psychologically Grounded Architecture and Evaluation Framework for Role-Playing Agents and Simulations
링크: 논문 PDF로 바로 열기
저자: Rotem Dror, Zohar Elyoseph, Yuval Haber, Elad Refoua, Oshrat Ayalon, Adir Solomon
1. Key Terms & Definitions (핵심 용어 및 정의)
- Deep Persona: 관찰 가능한 표현, 잠재된 신념, 그리고 핵심 동기적 동기의 계층적 수준으로 페르소나를 구성하여 매우 설득력 있는 Role-Playing Agent를 구축하는 심리학적으로 Grounded된 3계층 아키텍처.
- Scripted Determinism: Large Language Models (LLMs)의 행동 일관성을 보장하기 위해 모델을 자율적인 에이전트가 아닌, 엄격하고 정교한 내부 스크립트에 의해 안내되는 확률적 엔진으로 취급하는 원칙.
- Bounded Agency: LLMs의 역할을 반응적이고 제한된 시나리오 내에서 사용자에게 응답하도록 한정하여, Hallucination, Role Drift, 그리고 캐릭터 붕괴를 줄이는 원칙.
- Three Layers of Personality: Persona를 External (Conscious), Middle (Pre-Conscious), Internal (Unconscious)의 세 계층으로 구조화하여, 행동이 심층적인 내부 상태와 일관되게 나타나도록 하는 심리학적 모델 기반의 추상화.
- Dialogue Naturalness Score (DNS): LLM 생성 대화의 자연스러움을 정량화하는 통계적 지표로, Mahalanobis distance를 사용하여 모델의 Scoring Profile을 인간 대화 분포의 multivariate baseline과 비교하여 통계적으로 구분 불가능한지 평가한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Large Language Models (LLMs)를 활용한 기존의 페르소나 시뮬레이션 방식이 피상적인 캐릭터 설명에 의존하여 장기적인 상호작용에서 일관된 캐릭터 행동을 유지하지 못하는 핵심 문제를 다룬다. 대부분의 기존 연구에서 페르소나는 단편적인 프롬프트 기반의 "Flat"한 표현으로 정의되며, 이는 LLM이 Hallucination, 불일치, 그리고 의도된 캐릭터로부터 점진적으로 이탈하는 현상(Character Drift)에 취약하게 만든다. 특히, 대화형 비서, 교육 도구, 엔터테인먼트 플랫폼, 그리고 정신 건강 및 임상 훈련과 같은 민감한 영역에서 LLM 기반 에이전트의 사실성, 일관성 및 안정성에 대한 강력한 요구가 증가함에 따라, 이러한 한계는 더욱 두드러진다. 따라서, 심리학적 깊이와 내부 구조를 도입하여 페르소나를 모델링하고, 대화에서 페르소나 발화의 현실성과 자연스러움을 평가할 수 있는 견고한 프레임워크를 제공하는 새로운 접근 방식이 절실히 필요하다. 이 연구는 "Flat Persona"와 "Deep Persona" 간의 차이를 [Figure 1]을 통해 명확히 보여준다.
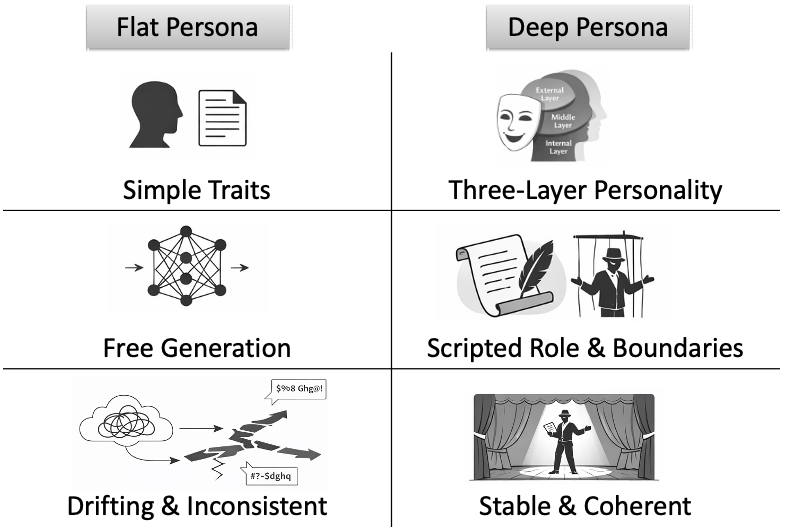
Figure 1 — Deep Persona 프레임워크 개념도
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 일관되고 신뢰할 수 있는 Role-Playing Agent 생성을 위한 심리학적으로 Grounded된 Deep Persona 아키텍처와 이를 평가하기 위한 프레임워크를 제안한다. Deep Persona는 Persona를 External Layer (Conscious), Middle Layer (Pre-Conscious), Internal Layer (Unconscious)의 세 계층으로 구조화하여, 관찰 가능한 행동뿐만 아니라 잠재된 신념과 핵심 동기적 동인이 응답 생성을 지배하도록 설계한다. 이 아키텍처는 Scripted Determinism 및 Bounded Agency 원칙에 따라 LLM을 엄격한 내부 스크립트에 의해 안내되는 반응형 엔진으로 제한하여 행동 일관성을 유지하고 Hallucination을 줄인다. Persona 구성 프로세스는 도메인 전문가와의 Knowledge Elicitation 인터뷰를 통해 캐릭터의 심리적 내러티브와 상호작용 정보를 수집하고, 이를 Persona Prompt Architecture의 여러 기능 모듈(예: Three-Layer Personality Module, Control and Logic Module, Embodied Expression Module)로 인코딩한다.
평가 프레임워크는 ADOS-Inspired Protocol을 통해 Reference-Free Psychological Metrics를 도입한다. 여기에는 Pragmatic Fluidity & Echolalia (언어적 반복성 및 유창성), Joint Attention Capability (대화 초점 추적 능력), Affective Congruence (언어적-비언어적 감정 일치), Emotional Expression Diversity & Intensity (감정 표현의 다양성 및 강도) 네 가지 핵심 지표가 포함된다. 또한, Dialogue Naturalness Score (DNS)는 Mahalanobis distance를 사용하여 모델의 Scoring Profile S_A=[S_pragmatics, S_joint-attention, S_congruence, S_emotion]를 인간 대화 분포의 multivariate baseline과 비교하여 통계적으로 구분 불가능한지 평가한다. 추가적으로, Hallucination Trap, Out-of-Role Request, Ethical Stressors를 포함하는 Stress Test를 통해 Persona의 캐릭터 일관성 유지 능력을 Adversarial Input 하에서 평가한다.
실험 결과, 기존 Human–LLM Datasets는 Pragmatic Fluency에서 0.88–0.97의 높은 성능을 보였으나, Emotional Expression 및 Joint Attention에서는 체계적인 한계를 드러냈다. 특히, ABC-Eval 데이터셋은 Joint Attention에서 0.46으로 낮은 점수를 기록했으며, CounselChat (human–LLM)은 Emotional Expression에서 2.2054로 과도한 감정 증폭을 보였다. 반면, Deep Persona 아키텍처를 사용하여 구축된 임상 시뮬레이션의 두 Persona (Sarah와 Evelyn)는 combined baseline 하에서 기존 평가된 모든 Human–LLM Datasets보다 높은 DNS scores를 달성했으며 (Sarah: 0.9177, Evelyn: 0.8503), 모든 대화에서 인간 상호작용과 통계적으로 구분 불가능한 것으로 나타났다. Sarah Persona는 S_congruence 0.52를, Evelyn Persona는 0.35를 기록하며 Non-verbal Cues와의 Affective Congruence 가능성을 보였다. Stress Test를 통해서도 Sarah와 Evelyn은 캐릭터 붕괴 없이 Adversarial Input에 심리적 프로필에 부합하는 방식으로 반응하여, Control and Logic Module의 효과를 입증했다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 일관되고 신뢰할 수 있는 Role-Playing Agent 구축을 위한 심리학적으로 Grounded된 Deep Persona 아키텍처와 그 행동의 사실성을 측정하는 평가 프레임워크를 제안한다. 이 아키텍처는 캐릭터의 표현을 동기 부여하고 지배하는 내부 구조를 인코딩함으로써 기존의 피상적인 Persona Prompting의 한계를 극복한다. 제안된 프레임워크를 통해 Deep Persona는 기존 Human–LLM Datasets보다 우수한 Dialogue Naturalness Score를 달성하며, 인간과의 상호작용과 통계적으로 구분 불가능한 결과를 보여주었다. 이 연구는 LLM 기반 시뮬레이션 분야, 특히 정신 건강 및 임상 훈련과 같은 고정밀 Persona가 요구되는 분야에서 더욱 사실적이고 신뢰할 수 있는 에이전트 개발을 위한 중요한 기반을 제공한다. 향후 연구는 개별 아키텍처 기여도에 대한 Ablation Studies, 더 많은 언어 및 도메인에서의 유효성 검증, 그리고 Human-in-the-Loop Evaluation을 통해 이 프레임워크의 잠재력을 더욱 확장할 수 있을 것이다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SLCA-GRPO: Resolving Cross-Segment Credit Misattribution in Tool-Calling RL
- [논문리뷰] Evidence-Grounded Auditing of Identification Assumptions in Climate-Policy Causal Evaluations
- [논문리뷰] CARD: Cluster-level Adaptation with Reward-guided Decoding for Personalized Text Generation
- [논문리뷰] Coding Agents for Generalized Task and Motion Planning Problems
- [논문리뷰] Bellman Policy Optimization
Review 의 다른글
- 이전글 [논문리뷰] Complex KDA: Understanding and Enhancing the Expressivity of Kimi Delta Attention
- 현재글 : [논문리뷰] Deep Persona: A Psychologically Grounded Architecture and Evaluation Framework for Role-Playing Agents and Simulations
- 다음글 [논문리뷰] Document Retrieval-Aware Chunking (D-RAC): Universal Retrieval-Aware Ingestion of Enterprise Documents via PDF Normalization and Multimodal Markdown Conversion
댓글