[논문리뷰] Evidence-Grounded Auditing of Identification Assumptions in Climate-Policy Causal Evaluations
링크: 논문 PDF로 바로 열기
저자: Yonghong Zhang, Yong Xie, Isabel M. Parra, Ricardo Correia
1. Key Terms & Definitions (핵심 용어 및 정의)
- Difference-in-differences (DID): 기후 정책 평가를 포함한 다양한 분야에서 인과적 효과를 추정하기 위해 널리 사용되는 준실험(quasi-experimental) 방법론입니다.
- Identification Assumptions:
DID추정치가 유효한 인과적 효과를 반영하기 위해 반드시 충족되어야 하는 근본적인 조건들을 의미하며,parallel trends,no anticipation,staggered adoption처리,limited interference등이 포함됩니다. - ARGUS:
DID연구의identification assumptions에 대한 보고된 증거를 감사하기 위해 제안된 구조화된Large Language Model (LLM)기반 파이프라인입니다. [cite: 1, Figure 1] - Flaw Injection: 감사 도구의 탐지 능력을 평가하기 위한 방법론으로, 알려진
identification flaws를 의도적으로 연구에 삽입하여ARGUS가 이를 감지하고 위치를 파악하는지 테스트합니다. [cite: 1, Figure 2] - Evidence-Grounded Auditing: 특정 기준에 따라 보고된 증거의 적절성을 평가하는 과정으로, 관련 증거를 검색할 수 없을 때는 명시적으로
abstain하는 기능을 포함합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
Difference-in-differences (DID) 연구는 탄소 가격 책정 및 배출권 거래제와 같은 climate policy를 평가하는 데 광범위하게 사용됩니다. 그러나 이러한 평가의 신뢰성은 parallel trends, no anticipation, staggered adoption 처리, limited interference와 같은 identification assumptions에 대한 증거를 평가하는 복잡성 때문에 여전히 도전적입니다. 기존 연구들은 기후 정책의 특성상 정책 중첩, 시간 경과에 따른 단계적 도입, 행정 경계를 넘는 spillover effects, 모델링되거나 원격 감지된 결과에 의존하는 등 복잡한 환경에서 identification assumptions를 평가하기 어렵다는 한계를 가지고 있습니다. 따라서, 약하게 뒷받침되는 assumptions에 기반한 인과적 결론은 잘못된 정책 결정으로 이어질 수 있으며, 이는 경험적 연구 결과의 전반적인 신뢰성에 대한 광범위한 우려의 한 측면입니다. 본 논문은 인과적 효과의 진실성보다는, 연구 내에서 identification credibility가 얼마나 감사 가능한지에 초점을 맞춥니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 climate policy causal evaluations에서 identification assumptions를 감사하기 위한 ARGUS라는 구조화된 Large Language Model (LLM) 파이프라인을 제안합니다. ARGUS는 11가지 차원의 assumption–implication–evidence rubric을 사용하여 DID 연구를 분해하고, bounded retrieval-gated LLM 파이프라인을 통해 관련 증거를 검색, 적절성을 평가하며, 전문가 검토를 위한 evidence-grounded risk report를 생성합니다 [cite: 1, Figure 1]. ARGUS의 감사 파이프라인은 decomposition → extraction → assessment → localization → report의 고정된 결정론적 순서를 따르며, LLM 호출은 extraction 및 assessment 두 단계에만 한정됩니다 [cite: 1, Figure 2].
주요 실험 결과로, ARGUS는 flaw injection 방법론을 통해 평가되었습니다 [cite: 1, Figure 2]. 11가지 flaw 벤치마크에서 ARGUS는 73%의 planted flaws를 탐지하여, keyword-based pipeline의 18% 대비 현저히 높은 성능을 보였습니다. 확장된 33가지 flaw variant 벤치마크에서는 detection이 0.73~0.76, localization이 0.64~0.70 수준으로 나타났습니다. 특히, ARGUS는 commission flaws에 대해 0.86~0.91의 높은 detection rate를 보였으나, omission flaws의 경우 0.45로 낮게 나타났는데, 이는 검색 실패 시 unknown으로 abstain하기 때문입니다 [cite: 1, Table 2]. 26개의 실제 경제학 논문을 대상으로 한 평가에서는 ARGUS가 검색 가능한 증거 부족으로 인해 약 40%의 평가에서 abstain하여, retrieval이 audit coverage를 제한할 수 있음을 보여주었습니다. 또한, 조정된 인간 레이블을 사용한 소규모 파일럿 연구에서 ARGUS는 in-sample에서 over-severity 경향을 보였으나, 사전 정의된 보정 규칙을 적용하여 exact agreement를 0.24에서 0.76로 향상시켰습니다 [cite: 1, Table 14].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 climate policy의 진정한 인과적 효과가 관찰 불가능함에도 불구하고, 연구에서 보고된 증거가 identification assumptions를 얼마나 잘 뒷받침하는지 평가할 수 있음을 ARGUS를 통해 입증합니다. ARGUS는 bounded, evidence-grounded LLM pipeline을 통해 잠재적 약점을 전문가 검토를 위한 evidence-linked risk report로 제시함으로써, 인과적 주장을 판정하기보다 위험을 localize합니다. 이 연구는 LLM 기반 감사 시스템에서 retrieval quality의 중요성과 explicit abstention의 필요성을 강조하며, climate policy causal evaluations의 identification credibility를 감사하는 데 있어 자동화되고 구조화된 접근 방식의 가능성을 제시합니다. 이를 통해 경험적 연구의 reliability를 높이고, identification risk를 식별하여 보다 신뢰할 수 있는 정책 결정을 지원하는 데 기여할 수 있습니다.
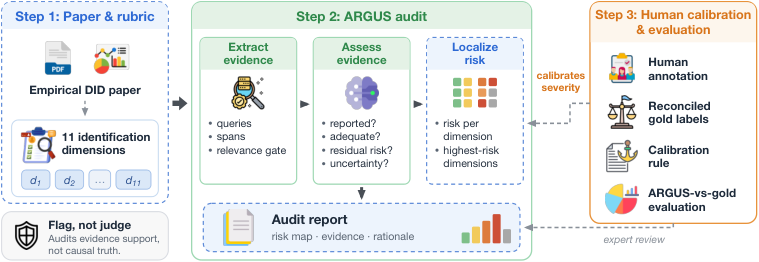
Figure 1 — ARGUS 전체 개요
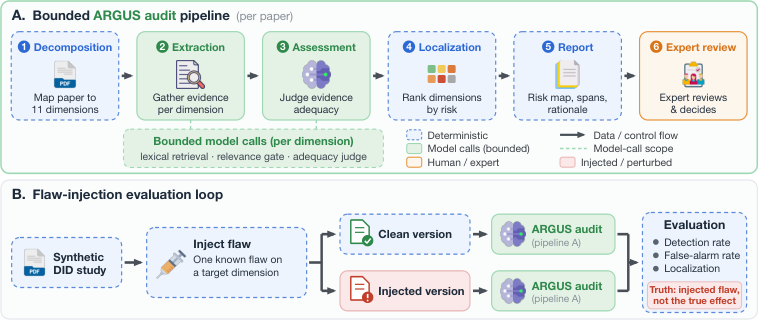
Figure 2 — ARGUS 아키텍처 및 평가 루프
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SLCA-GRPO: Resolving Cross-Segment Credit Misattribution in Tool-Calling RL
- [논문리뷰] CARD: Cluster-level Adaptation with Reward-guided Decoding for Personalized Text Generation
- [논문리뷰] Coding Agents for Generalized Task and Motion Planning Problems
- [논문리뷰] Bellman Policy Optimization
- [논문리뷰] Deep Persona: A Psychologically Grounded Architecture and Evaluation Framework for Role-Playing Agents and Simulations
Review 의 다른글
- 이전글 [논문리뷰] Enhancing Photogrammetric Digital Surface Models with Pretrained Diffusion Models and Multimodal Conditioning
- 현재글 : [논문리뷰] Evidence-Grounded Auditing of Identification Assumptions in Climate-Policy Causal Evaluations
- 다음글 [논문리뷰] FoMo: Forking Moment in Generative Trajectory as a Perceptual Distance
댓글