[논문리뷰] Mira-Scene: Pixel-Aligned Layouts for Generative 3D Scene
링크: 논문 PDF로 바로 열기
저자: Yang-Tian Sun, Tianjia Liu, Zehuan Huang, Yi-Hua Huang, Xiaoyang Lyu, Ziyi Yang, Zi-Xin Zou, Yuan-Chen Guo, Yan-Pei Cao, Xiaojuan Qi
1. Key Terms & Definitions (핵심 용어 및 정의)
- Compositional 3D Scene Reconstruction: 단일 이미지에서 고품질의 3D 객체들을 생성하고, 이들을 일관된 3D Scene Layout에 정확하게 배치하는 작업을 의미합니다.
- Canonical Coordinate Map (CCM): 각 가시적인 객체 픽셀을 해당 객체의 Bounded Canonical Space 내 Surface Coordinate에 매핑하는 Pixel-Aligned Field입니다. 이는 Scene-level Layout Annotation 없이 Scalable Object-level Data로부터 학습될 수 있는 Stable Prediction Target을 제공합니다.
- Point Cloud Map (PCM): Monocular Geometry Estimation을 통해 얻어지는 Scene Space의 Dense Point Map으로, CCM과 함께 객체 변환을 복구하는 데 사용됩니다.
- Rectified Flow Models: 데이터 샘플과 가우시안 노이즈 사이를 선형 보간하는 Forward Process를 사용하는 생성 모델로, Mira-Scene의 Geometry Expert 및 Layout Expert에 활용됩니다.
- Multimodal Diffusion Transformer: 3D Geometry와 2D CCM과 같은 이질적인 Modality들이 Shared Attention을 통해 상호작용하며 공동으로 생성되는 Transformer 기반 모델을 지칭합니다.
- Shared Positional Encoding: Geometry Token과 Layout Token을 공통의 3D Positional Space에 임베딩하여 Cross-modal Interaction 및 Consistency를 향상시키는 전략입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 단일 이미지로부터 Compositional 3D Scene을 재구성하는 과정에서 Object Layout을 정확하게 배치하는 문제를 해결하고자 합니다. 최근 Single-image 3D Object Generation 기술은 고품질의 3D Assets를 생성할 수 있게 되었지만, 이러한 객체들을 일관된 Scene Layout에 정확히 배치하는 것은 여전히 난제로 남아있습니다.
기존 Holistic Methods는 객체 배치를 Scene-level Generation Process에 통합함으로써 객체별 Detail을 희생하는 한계가 있습니다. 반면, Compositional Methods는 객체 Fidelity를 보존하지만, Layout을 Sparse하고 Unbounded한 Pose Variables로 Parameterize하여 학습이 어렵고, 제한된 Scene-level Supervision 하에서는 일반화 성능이 저조하다는 문제가 있습니다. 예를 들어, SAM3D와 같은 데이터 중심 시스템도 Sparse Pose Variable을 사용하며, 데이터 확장만으로는 Layout Prediction의 근본적인 표현 난이도를 완전히 해결하기 어렵습니다. Coord Cube와 같이 Scene-space Prediction을 Dense화하는 시도도 있었지만, 예측 좌표가 여전히 Unbounded Scene-space Quantity로 남아있어 Robustness 향상에 한계가 있었습니다. 이러한 한계점들은 Dense하고 Bounded하며 Scalable한 Layout Representation의 필요성을 제기합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
Mira-Scene은 Sparse Pose Regression 또는 Unbounded Point Prediction을 Dense하고 Bounded Correspondence Recovery로 대체하는 Generative Compositional 3D Reconstruction Framework를 제안합니다. 이 방법론의 핵심은 Canonical Coordinate Map (CCM)으로, 각 가시 객체 픽셀을 해당 객체의 Bounded Canonical Space 내 Surface Coordinate에 매핑하는 Pixel-Aligned Field입니다. CCM은 Monocular Geometry Estimation에서 얻은 Scene-space Point Cloud Map (PCM)과 결합될 때 Dense Canonical-to-Scene Correspondence를 유도하며, 이를 통해 Robust Geometric Alignment를 통해 객체 변환을 복구합니다. [Figure 3]
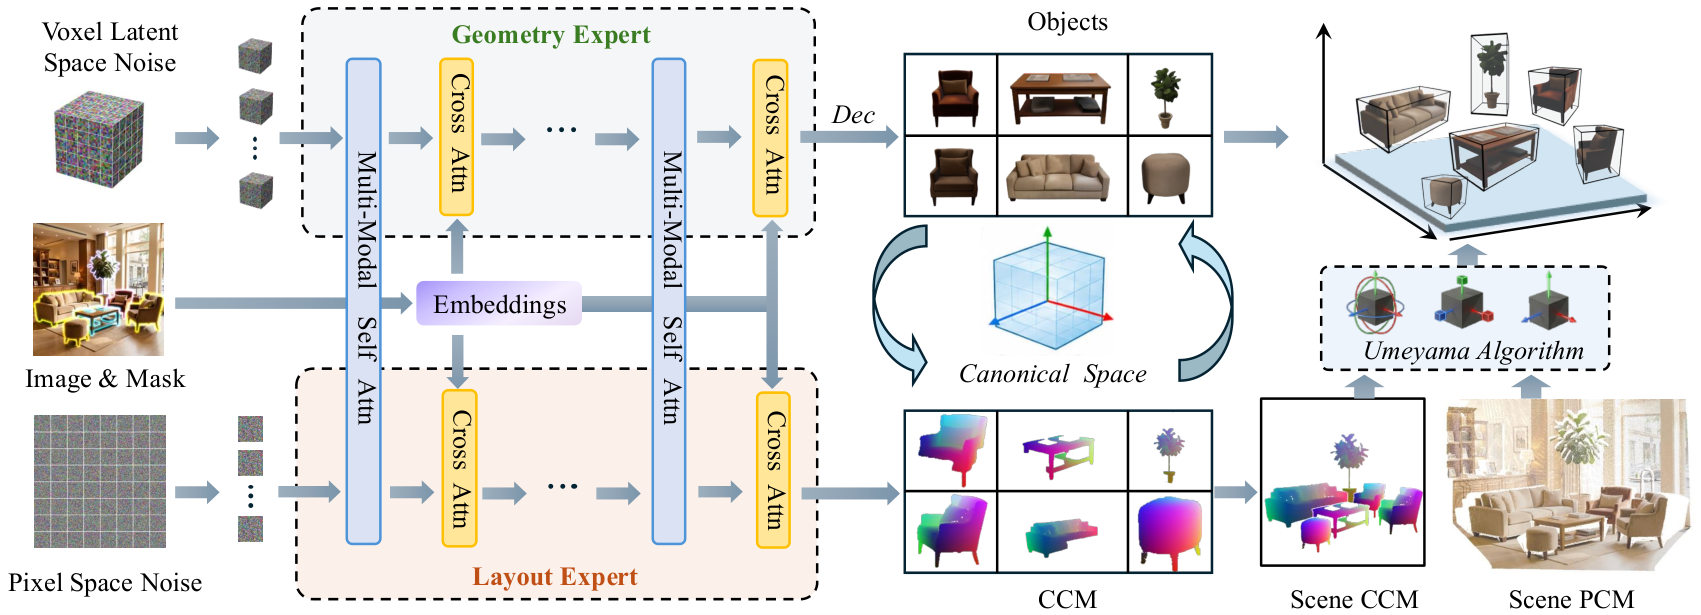
Figure 3 — Mira-Scene의 전체 파이프라인
CCM이 Bounded Canonical Space에서 작동하므로, Scene-level Layout Annotation 없이 Scalable Object-level 3D Data로부터 훈련 가능한 Stable Prediction Target을 제공하여 Object-level Pre-training의 이점을 최대한 활용할 수 있습니다. 또한, Mira-Scene은 Multimodal Diffusion Transformer를 도입하여 Object Geometry와 CCM을 공동으로 생성합니다. 이 모델은 Modality-specific Expert Stream과 Shared Attention, Shared Positional Encoding을 사용하여 3D Geometry와 Pixel-Aligned CCM 간의 Consistency를 촉진합니다. [Figure 4]
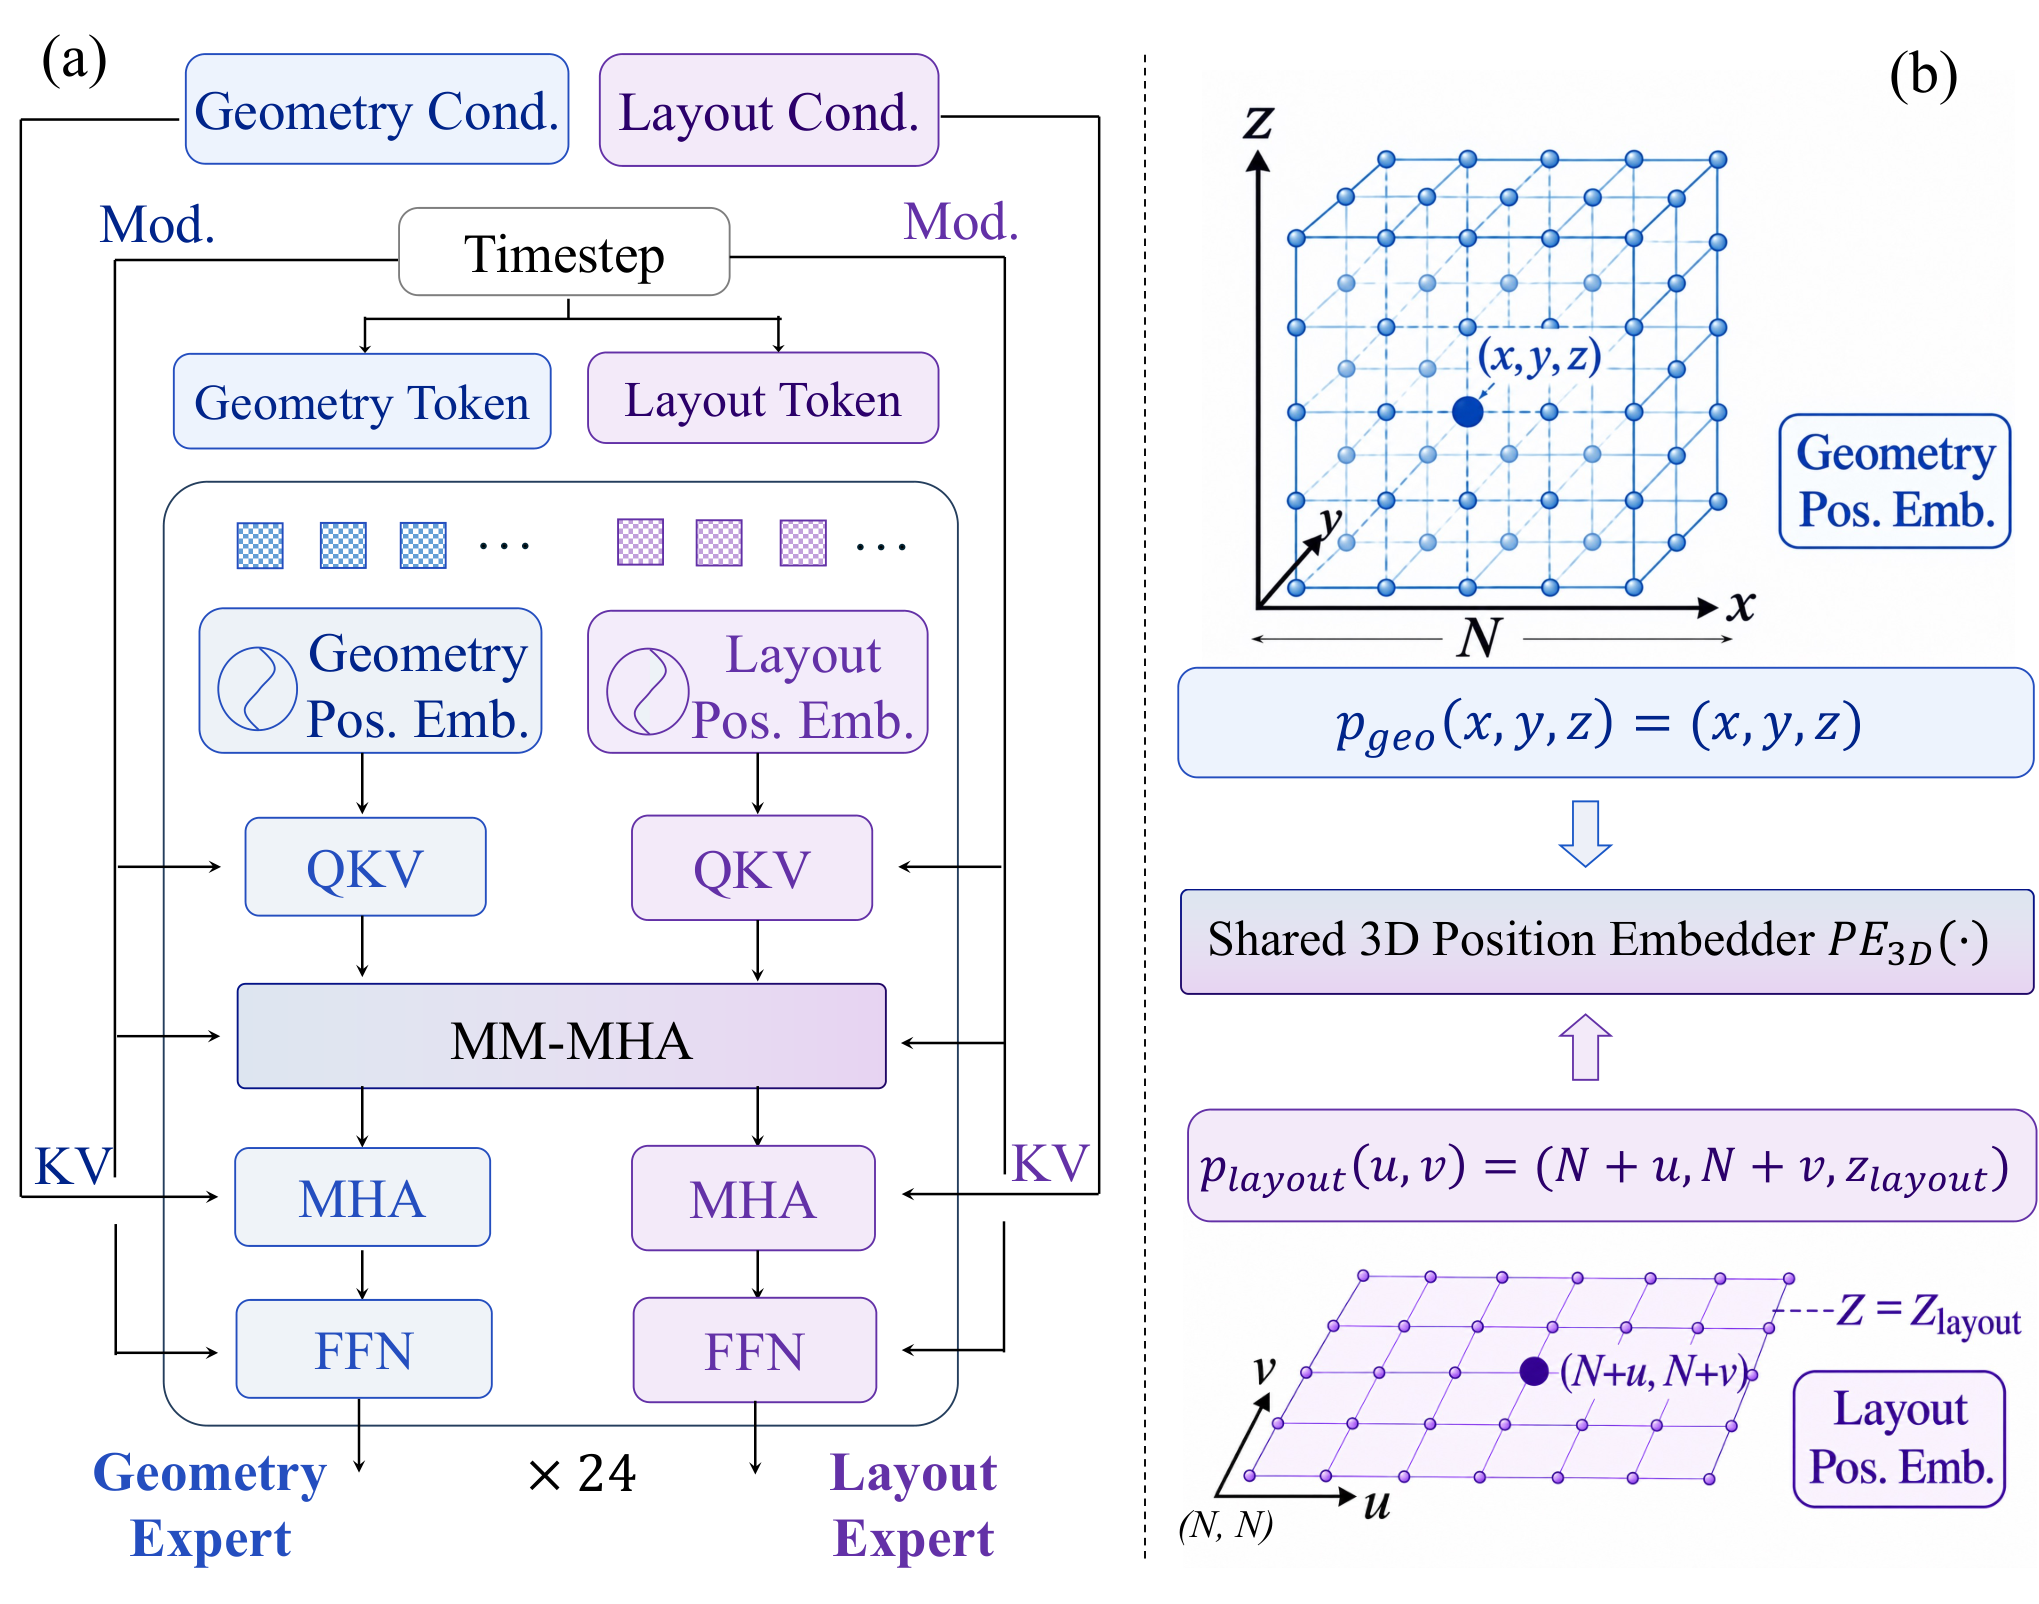
Figure 4 — Co-generation 아키텍처
Mira-Scene의 훈련 파이프라인은 두 단계로 구성됩니다. 첫 번째는 Rendered Isolated Assets와 Background-completed Views를 사용하는 Object-level Pre-training이며, 두 번째는 Occluded Object Instances에 대해 모델을 적응시키는 Scene-level Fine-tuning입니다. 이 접근 방식은 모델이 Isolated Object Observation뿐만 아니라 Partial Visibility, Mutual Occlusion과 같은 Real Scene 현상에 대해서도 Amdoal Object Reasoning을 수행하도록 돕습니다.
실험 결과, Mira-Scene은 다양한 Scene(Indoor, Outdoor, Synthetic, In-the-wild)에서 기존 Baseline 대비 Scene Layout Accuracy에서 상당한 성능 향상을 입증했습니다. BlendSwap 벤치마크에서 Mira-Scene은 SAM3D 대비 3D-IoU에서 39.8% (0.520 → 0.727) 개선되었고, 2D-IoU에서는 16.5% (0.672 → 0.783) 개선을 달성했습니다. 3D-Future Scene 벤치마크에서도 3D-IoU에서 16.4%의 상대적 개선을 보였습니다. 이러한 결과는 Dense CCM-PCM Correspondence가 Sparse Pose Regression보다 더 학습 가능하고 일반화 가능한 Layout Representation임을 지지합니다. Layout Representation Ablation Study에서도 CCM with PCM은 Raw Pose Regression 및 Coord Cube 대비 3D-IoU와 2D-IoU에서 각각 0.379 → 0.727 및 0.381 → 0.783로 크게 우수함을 입증했습니다.
4. Conclusion & Impact (결론 및 시사점)
Mira-Scene은 단일 이미지 Compositional 3D Scene Reconstruction을 위한 새로운 Framework를 제시합니다. 이 연구는 Sparse Object Pose Regression을 Dense하고 Bounded한 Canonical Coordinate Map (CCM) Representation으로 대체하고, CCM과 Point Cloud Map (PCM) 간의 Alignment를 통해 Object Placement를 복구함으로써, 부족한 Scene-level 3D Supervision에 대한 의존도를 크게 줄였습니다.
제안된 Geometry-Layout Co-generation Model은 Shared Attention 및 Shared Positional Basis를 통해 별도의 Geometry 및 Layout Stream을 활용하여, 3D Geometry와 Pixel-Aligned CCMs의 고유한 구조를 유지하면서도 높은 Consistency를 달성합니다. Indoor, Outdoor, Synthetic 및 In-the-wild Inputs에 대한 실험을 통해 Mira-Scene은 경쟁력 있는 Object Geometry와 기존 Baseline보다 훨씬 더 정확한 Scene Layout을 제공함을 입증했습니다. 이 연구는 풍부한 Object-level 3D Assets로부터 학습할 수 있는 강력한 잠재력을 보여주며, 향후 스케일링을 위한 견고한 기반을 마련합니다. 또한, 이러한 Compositional Reconstruction 능력은 Scene Editing, Embodied AI, Physical Simulation과 같은 다양한 Downstream Application을 가능하게 하여 학계 및 산업계에 중요한 시사점을 제공합니다.
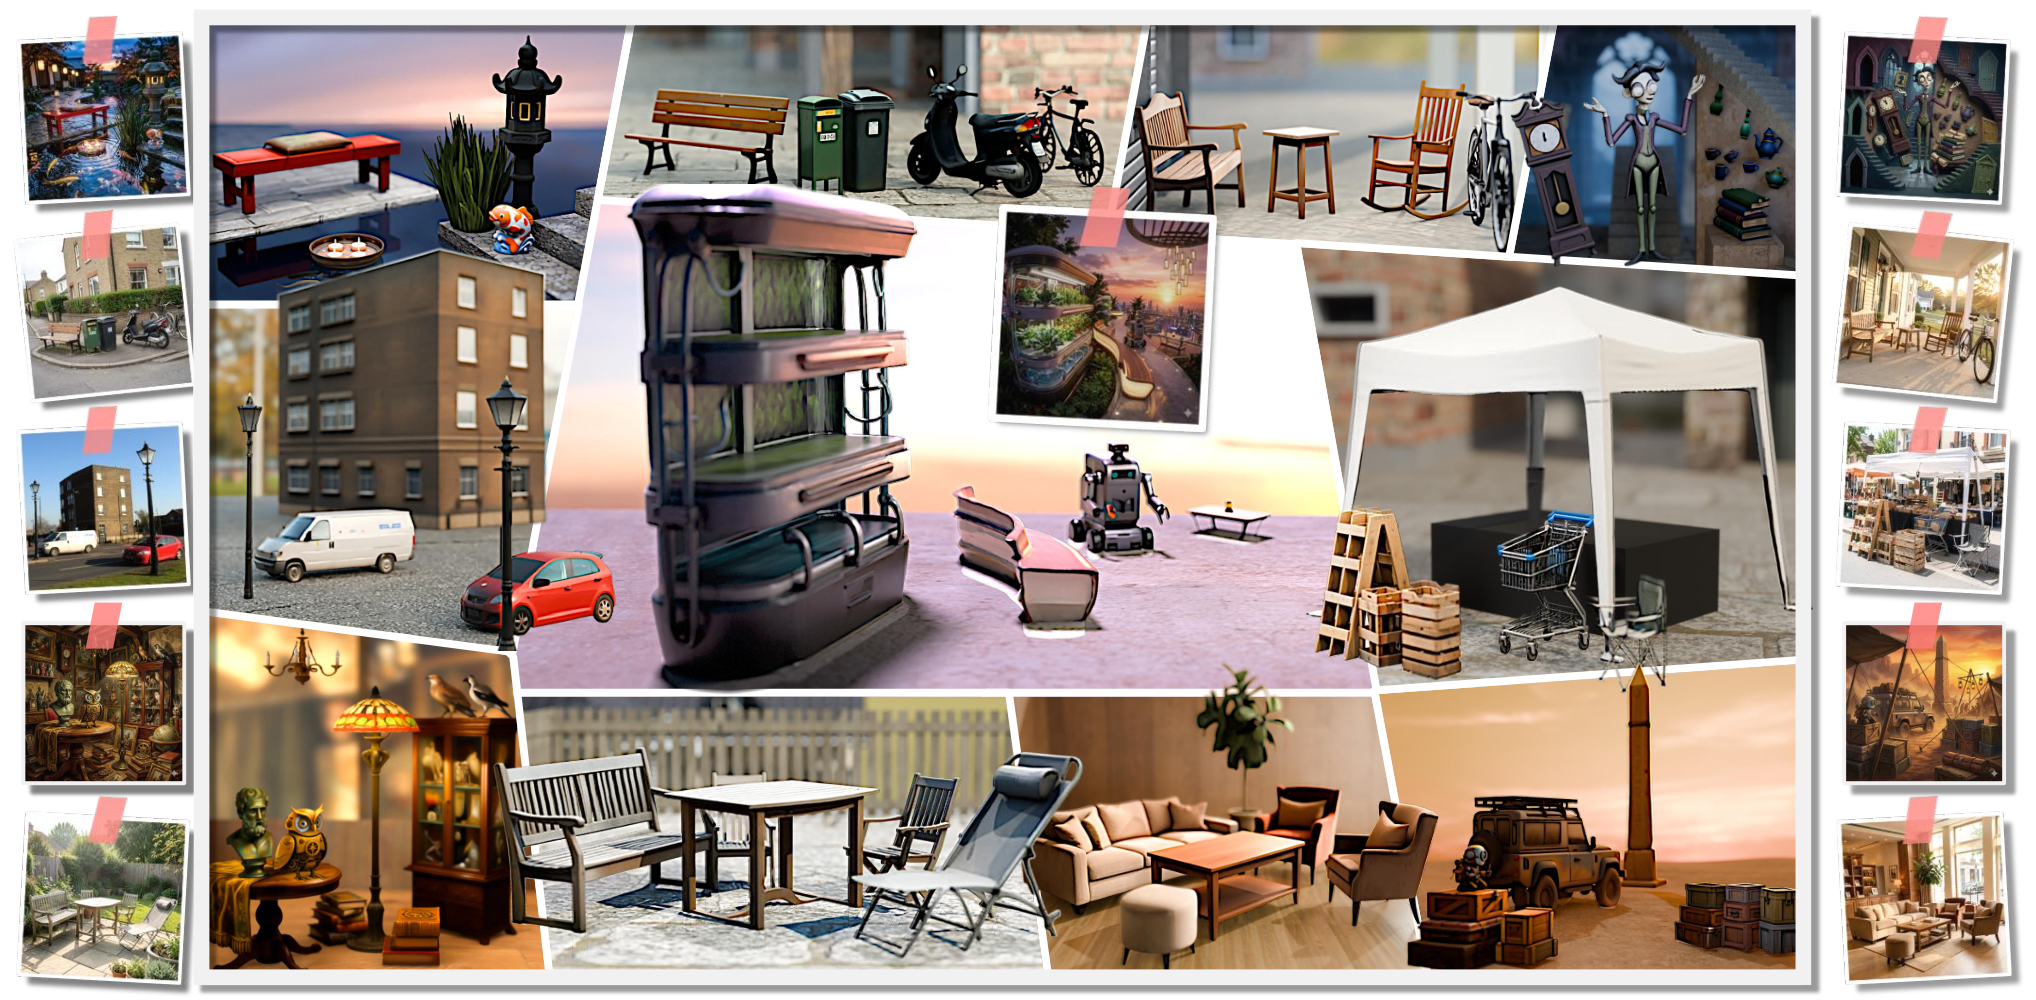
Figure 1 — Mira-Scene의 재구성 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Oxygen-TryOn: Fashion-Native Foundation Model for Any-item Virtual Try-On
- [논문리뷰] SimRecon: SimReady Compositional Scene Reconstruction from Real Videos
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] Qwen-Image Technical Report
- [논문리뷰] ZooWork-ShopRanker: An Open, Preference-Aligned E-Commerce Reranker
Review 의 다른글
- 이전글 [논문리뷰] Measuring the Checker: Mutation Analysis for GPU-Kernel Benchmark Oracles
- 현재글 : [논문리뷰] Mira-Scene: Pixel-Aligned Layouts for Generative 3D Scene
- 다음글 [논문리뷰] OmniEdu: Open Foundation Models for Learning and Teaching
댓글