[논문리뷰] onPanda: Efficient Annotation of On-Policy Alignment Data for LLMs and Agents via Token-Level Correction
링크: 논문 PDF로 바로 열기
저자: Lei Yang, Mengyin Liu, Jia Wang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 다루는 핵심 용어 및 정의는 다음과 같습니다:
- Token-Level Correction: Annotator가 Large Language Model (LLM)의 생성 결과에서 부적절한
token을 식별하고, 제안된candidate tokens중에서 선택하거나 직접 텍스트를 입력하여 수정하는 상호작용 방식입니다. - On-Policy Data:
annotation과정에서rollout model의sampling distribution을 최대한 보존하며 생성된data를 의미합니다.human intervention은 최소화되고 대부분의token은 모델 자체에 의해 생성됩니다. - SFT (Supervised Fine-Tuning) Data:
instruction-response쌍으로 구성되어LLM의 특정task수행 능력을 향상시키기 위해fine-tuning하는 데 사용되는data입니다. - Preference Data: 여러 모델
response에 대해 사람이 선호도를 부여하여reward model또는DPO (Direct Preference Optimization)학습에 사용되는data를 의미합니다. - Annotation Tree:
onPanda시스템에서annotation session을 구성하는data structure로, 모든 중간dialog버전이 자동으로 저장되어data의provenance를 완전하게 추적할 수 있습니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
LLM alignment 및 agent 학습을 위한 고품질 data 확보는 여전히 핵심적인 bottleneck입니다. 기존 data annotation pipeline은 annotation cost, on-policy fidelity, 그리고 supervision granularity 문제를 동시에 해결하는 데 어려움을 겪고 있습니다. 수동으로 response를 작성하거나 post-editing하는 방식은 높은 cost를 요구하며, 결과적으로 off-policy data를 생성하여 모델의 sampling distribution과 괴리가 발생합니다. preference data는 상대적으로 cost가 낮지만 response-level의 coarse supervision만을 제공하며, 모델이 적절한 response를 생성할 수 없을 때는 corrective signal이 부족합니다. 특히 agent trajectory annotation은 multi-step environment interaction을 수반하므로, correction이 실제 tool을 실행하고 feedback을 받아야 하는 등 더욱 복잡한 문제를 가지고 있습니다. 기존 agent annotation tool들은 실시간으로 reasoning과 tool calls를 correct하고 execute하는 interactive한 기능을 제공하지 못하는 한계가 있습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 LLM alignment data와 agent trajectories를 효율적으로 annotate하기 위해 token-level correction을 핵심 interaction으로 채택한 onPanda interactive tool을 제안합니다. onPanda는 annotator가 모델 response를 읽으면서 첫 번째 부적절한 token을 찾아내고, 모델의 candidate tokens 중에서 대체할 token을 선택하거나 free-form editing을 통해 직접 텍스트를 입력하도록 합니다 [Figure 1]. 수정 후 시스템은 해당 지점 이후의 내용을 truncate하고 corrected prefix로부터 generation을 계속하여 locate–correct–continue loop를 반복함으로써 annotator가 최소한의 노력으로 모델 output을 정확하게 제어할 수 있도록 합니다. 이러한 방식은 agentic 및 multimodal annotation에도 확장되어, response template 메커니즘을 통해 structured messages와 native token stream 간의 양방향 변환을 지원하며 external tools 및 harness와 연동하여 실제 환경에서의 interactive trajectory annotation을 가능하게 합니다 [Figure 2].
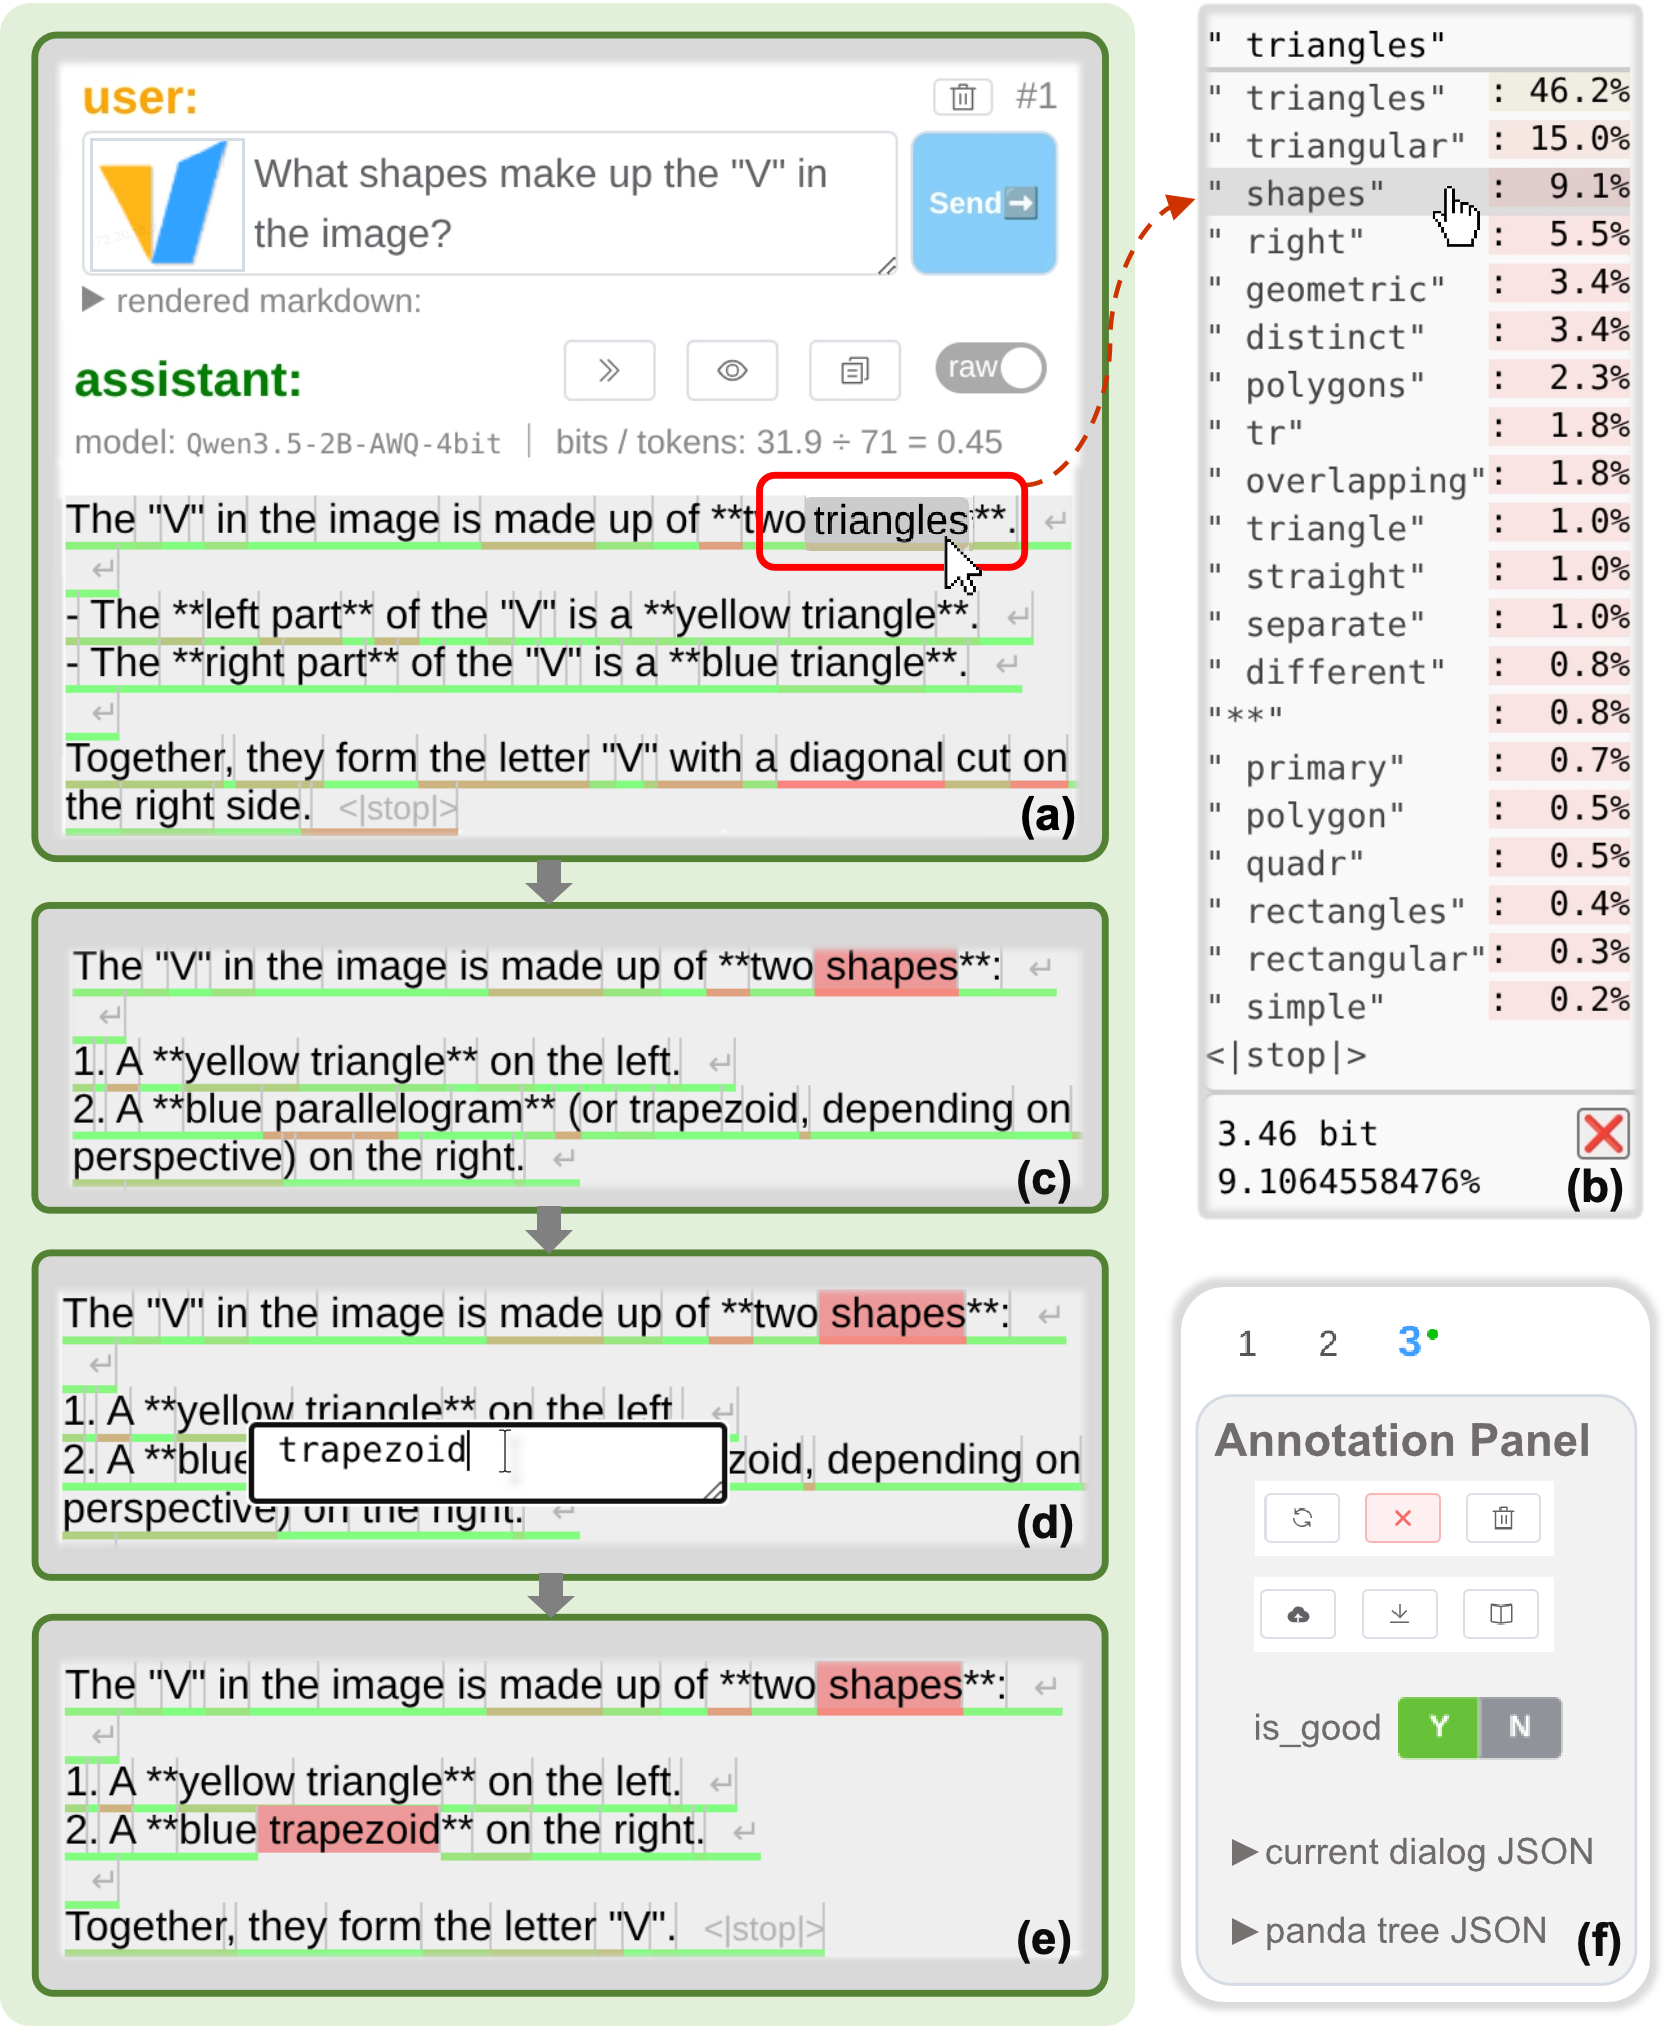
Figure 1 — onPanda의 토큰 수준 보정 인터페이스
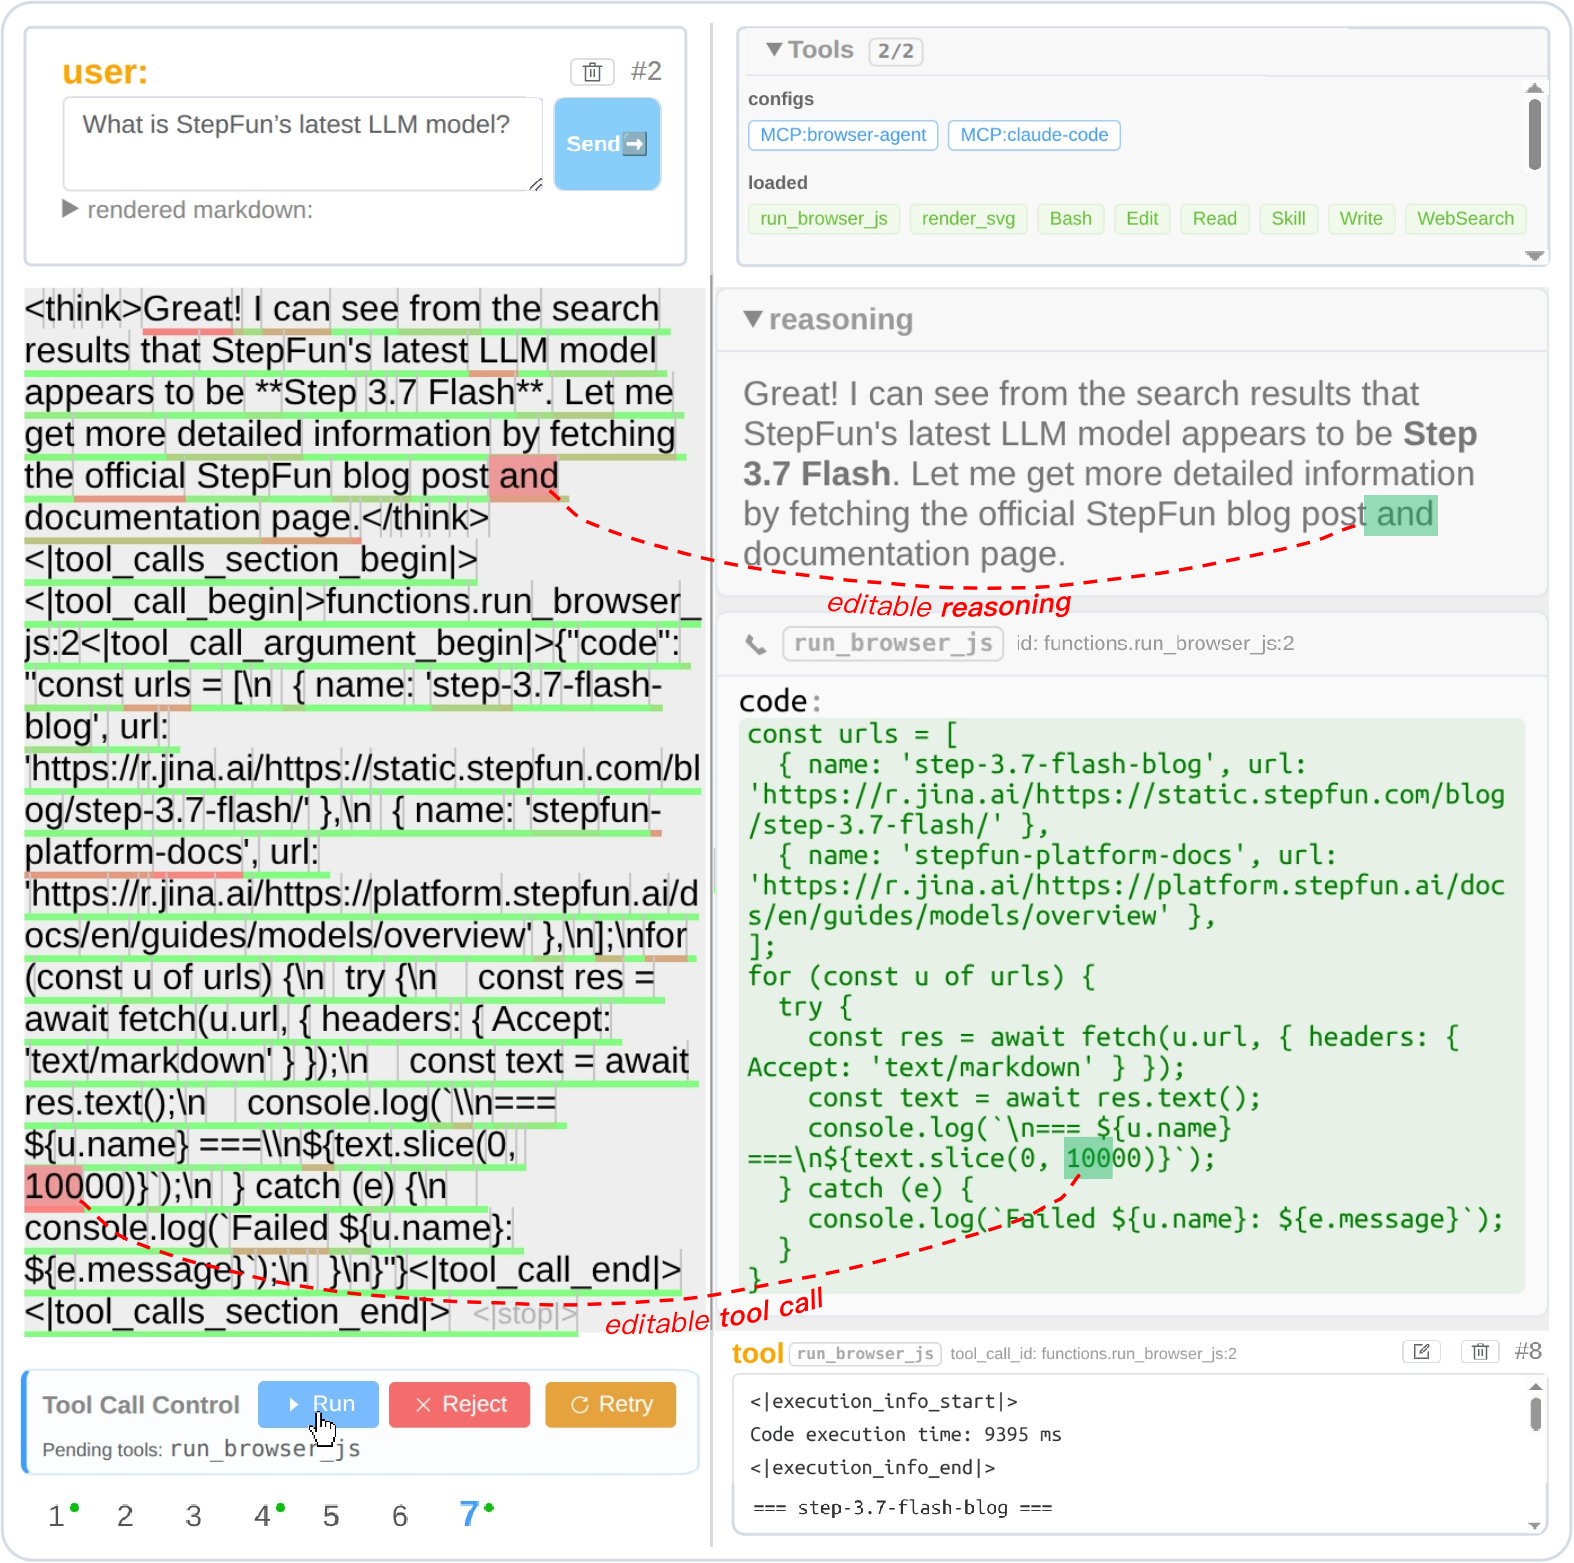
Figure 2 — onPanda를 사용한 에이전트 궤적 주석
실험 결과, onPanda는 annotation efficiency와 on-policy fidelity 측면에서 뛰어난 성능을 보였습니다. 제어된 연구에서 onPanda의 median annotation time은 prompt당 330초로, manual post-editing 방식인 POTATO의 681초 대비 51.5% 감소했으며, preference ranking 방식인 Argilla의 336초와 유사한 수준이었습니다. 또한, GPT-5.5가 평가한 pairwise win rate에서 onPanda는 66.7%로 가장 높은 win rate를 달성하여 data quality 또한 우수함을 입증했습니다. on-policy fidelity 측면에서는 rollout model에 대한 PPL (Perplexity)이 onPanda의 경우 1.181(ΔPPL +0.86%)로, POTATO의 1.596(ΔPPL +36.31%)보다 baseline (1.171)에 훨씬 가까워 rollout model의 sampling distribution을 더 잘 보존함을 보여주었습니다. onPanda는 SFT coverage에서 100%를 달성했으며, annotator의 workload를 평가하는 NASA-TLX 점수에서도 3.1로 가장 낮은 workload를 기록했습니다. 실제 production deployment에서는 qualified responses의 97.0% tokens가 모델 generated였으며, 2.1%가 candidate selected, 0.9%만이 수동 typed되어 production scale에서의 sparse human intervention을 확인했습니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 token-level correction을 기반으로 하는 onPanda annotation tool을 통해 LLM alignment data 및 agent trajectories를 효율적으로 annotate하는 새로운 패러다임을 제시했습니다. locate–correct–continue loop를 통해 annotator는 최소한의 interaction으로 model generation을 정밀하게 제어하며, rollout model의 distribution을 보존하는 on-policy data를 생산할 수 있습니다. 이 과정에서 모든 correction이 fine-grained supervision으로 자동 기록되어 reward model 또는 DPO training을 위한 preference data, 혹은 PRM training을 위한 process reward data로 활용될 수 있습니다.
onPanda의 연구는 LLM 및 agent 학습 data의 bottleneck을 해소하고 post-training method의 효율성을 높이는 데 기여합니다. annotation time 및 workload 감소 효과와 data quality 및 on-policy fidelity 보존 능력은 LLM development workflow의 효율성을 크게 향상시킬 수 있음을 시사합니다. 또한, onPanda의 open-source 공개와 Panda-CVL dataset 및 benchmark의 제공은 token-level correction data를 활용한 커뮤니티 연구를 촉진하고, 새로운 형태의 supervision signal 개발을 위한 기반을 마련할 것으로 기대됩니다. 이 연구는 LLM의 행동을 미세하게 분석하고 수정하는 model inspection 도구로서의 활용 가능성도 열어줍니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Miles v0.1: Production-Level Post-Training
- [논문리뷰] D^3-MOPD: Adaptive Dynamic Domain ScheDuling for Efficient Multi-Teacher Distillation
- [논문리뷰] CLEAR: Continuous Latent Adapter Routing for Utility-Preserving LLM Safety Alignment
- [논문리뷰] FACET: Preserving Source Intent and Executable State in Terminal Task Synthesis
- [논문리뷰] Parameter Exploration for RLVR via Variational Learning
Review 의 다른글
- 이전글 [논문리뷰] WorldCrafter: Consistent Video World Model with Implicit 3D-aware Memory
- 현재글 : [논문리뷰] onPanda: Efficient Annotation of On-Policy Alignment Data for LLMs and Agents via Token-Level Correction
- 다음글 [논문리뷰] ALPINE: Adaptive Localization for Parameter- and Sample-Efficient Few-Shot Learning
댓글