[논문리뷰] ALPINE: Adaptive Localization for Parameter- and Sample-Efficient Few-Shot Learning
링크: 논문 PDF로 바로 열기
저자: Neeraj Yadav
1. Key Terms & Definitions (핵심 용어 및 정의)
- Few-shot Learning: 소수의 labeled examples만으로 novel classes를 인식하는 머신러닝 과제입니다.
- Parameter Efficiency: 주어진 성능 목표를 달성하는 데 필요한 모델의 trainable parameters 수를 최소화하는 척도를 의미합니다.
- Sample Efficiency: 주어진 성능 목표를 달성하는 데 필요한 training episodes 또는 labeled examples의 수를 최소화하는 척도를 의미합니다.
- Adaptive Spatial Localization: 고정된 grid coordinate 대신 이미지 내용에 따라 locally informative regions를 동적으로 식별하고 샘플링하는 메커니즘입니다.
- Gabor Filters: Learnable parameter 없이 고정된 orientation-selective filter bank로, 이미지의 edge energy map을 생성하는 데 사용됩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
Few-shot learning 연구는 주로 accuracy 향상에 초점을 맞추고 있으며, real-world practitioner들에게 중요한 parameter 및 training-sample budgets에는 상대적으로 적은 관심을 기울이고 있습니다. 기존의 Prototypical Networks, Relation Networks, MAML과 같은 baseline 모델들은 수백만 개의 parameter를 사용하거나 수만 개의 meta-training episodes를 필요로 하여, 대규모 compute 자원이 없는 환경에서는 적용하기 어렵다는 한계가 있습니다. 또한, 많은 patch-based few-shot 시스템에서 사용하는 고정된 rectangular patch grid는 의미 있는 visual structure를 임의로 분할할 수 있어, 특히 occlusion이나 translation과 같은 이미지 perturbation 상황에서 비효율적입니다. 본 연구는 이러한 기존 방법론의 한계를 극복하고, 제한된 자원 환경에서도 효율적으로 작동하는 새로운 few-shot learning 아키텍처의 필요성을 제기합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Gabor filter 기반의 edge-energy guidance와 windowed, content-adaptive patch locator를 결합한 ALPINE (Adaptive Localization for Parameter- and Sample-Efficient Few-Shot Learning) 아키텍처를 제안합니다. 제안된 방법론은 입력 이미지에 Gabor pre-filtering을 적용하여 edge-orientation channels를 추가하고, 다섯 개의 patch center를 content-adaptive하게 선택합니다. 각 patch는 CNN을 통해 embedding v_k로 인코딩되며, patch 쌍 간의 relational tokens e_ij와 고정된 boundary tokens가 추가됩니다. 이 모든 tokens는 multi-head self-attention을 통해 정제된 후, gated residual fusion을 거쳐 최종 이미지 embedding을 생성하고, 표준 prototype-distance 규칙으로 분류됩니다.
주요 실험 결과에 따르면, ALPINE의 canonical configuration (EXP-F3, 22,249 parameters)과 wider configuration (EXP-F3-35k, 34,917 parameters)은 5-shot accuracy에서 세 가지 baseline 모델(Prototypical Networks, Relation Networks, MAML*)보다 우수한 성능을 보였습니다 [Table 1]. 예를 들어, EXP-F3-35k는 MiniImageNet에서 53.81%의 5-shot accuracy를 달성하며, 47,630 parameters의 ProtoNet이 달성한 48.82%보다 높고, baseline 대비 27–53% 더 적은 parameter를 사용합니다. 또한, ALPINE은 50% occlusion 및 25% spatial translation 조건에서 모든 baseline보다 훨씬 뛰어난 robustness를 보였으며, MiniImageNet Mask 조건에서 44.87%를 기록하며 ProtoNet의 40.36%를 크게 상회했습니다 [Table 2]. ALPINE은 meta-training episodes 250개 중 첫 50개 에피소드 내에서 baselines와 동등하거나 더 높은 정확도에 도달하며 sample efficiency 측면에서도 우수함을 입증했습니다 [Figure 3]. cross-domain generalization 측면에서도, MiniImageNet으로 훈련된 체크포인트로 unseen fine-grained CUB-200-2011 도메인에서 42.09%의 가장 높은 절대 정확도를 달성했습니다 [Table 3]. Falsification ablations (관계형 토큰 제거 실험) 결과, 본 아키텍처의 성능 향상에 기여하는 주요 요인은 content-adaptive spatial locator이며, pairwise relational computation은 부수적인 역할(0.3-0.9%p)을 하는 것으로 밝혀졌습니다 [Table 4]. Figure 1은 adaptive patch가 mask 및 shift 조건에서 어떻게 적응적으로 움직이는지를 시각적으로 보여줍니다.
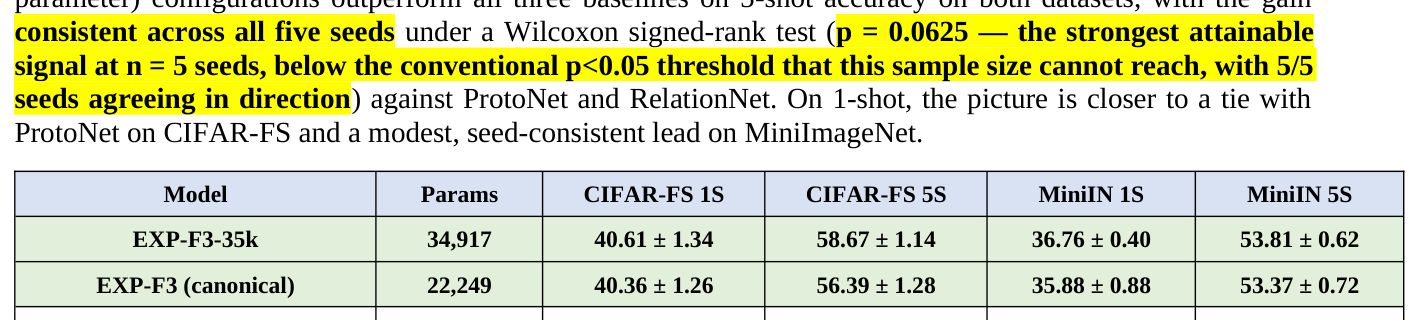
Table 1

Table 2
4. Conclusion & Impact (결론 및 시사점)
본 논문은 parameter 및 sample efficiency에 중점을 둔 few-shot learning을 위한 ultra-lightweight, content-adaptive spatial-relational architecture인 ALPINE을 성공적으로 제안했습니다. ALPINE은 제한된 compute 및 데이터 환경에서 5-shot accuracy를 크게 향상시키고, robustness 및 cross-domain generalization 능력을 개선하면서도, 기존 baseline보다 27-53% 적은 parameter를 사용하고 더 빠르게 수렴합니다. 특히, 자체 falsification testing을 통해 아키텍처의 핵심 성능 드라이버가 content-adaptive spatial localization임을 명확히 밝혀, 초기 가설(relational computation)과는 다른 결론을 정직하게 제시했다는 점에서 연구의 투명성을 높였습니다. 이 연구는 대규모 컴퓨팅 자원 없이 AI를 개발하거나 edge device에 AI를 배포하는 practitioner들에게 실질적인 가치를 제공하며, few-shot learning 분야에서 효율성과 접근성을 높이는 데 중요한 시사점을 줍니다.
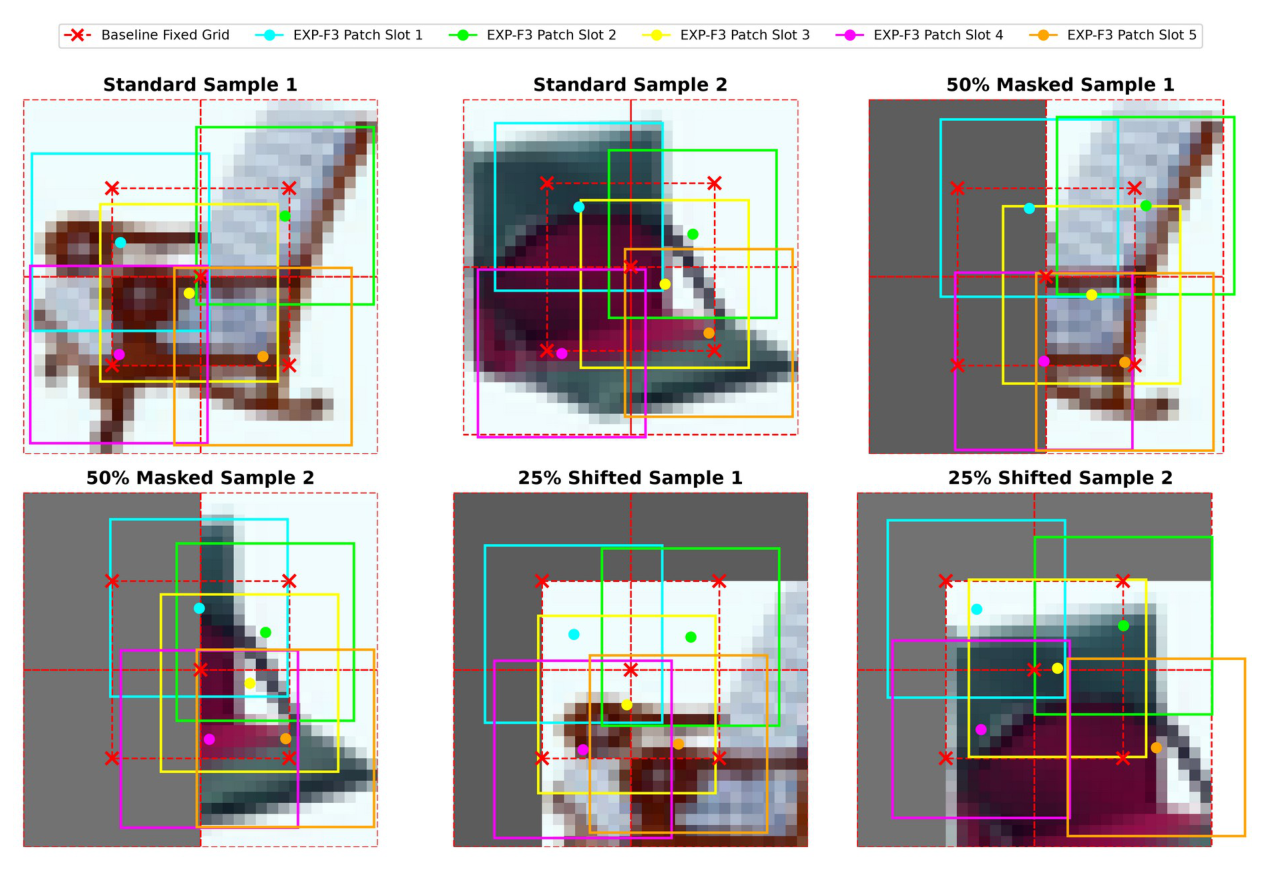
Figure 1
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] ZooWork-ShopRanker: An Open, Preference-Aligned E-Commerce Reranker
- [논문리뷰] VLA-Precision: Asymmetric Co-Bootstrapping for Efficient Real-World Online RL of Vision-Language-Action Models
- [논문리뷰] TrackEverything: Long Horizon Dense Tracking via De-Duplicating 3D Scene Representations
- [논문리뷰] Tactile-JEPA: Topology-Aware Self-Supervised Representation Learning for Distributed Tactile Sensors
Review 의 다른글
- 이전글 [논문리뷰] onPanda: Efficient Annotation of On-Policy Alignment Data for LLMs and Agents via Token-Level Correction
- 현재글 : [논문리뷰] ALPINE: Adaptive Localization for Parameter- and Sample-Efficient Few-Shot Learning
- 다음글 [논문리뷰] Agensh: Scaling Organizational Intelligence to 1,024 Agents
댓글