[논문리뷰] Tactile-JEPA: Topology-Aware Self-Supervised Representation Learning for Distributed Tactile Sensors
링크: 논문 PDF로 바로 열기
저자: Elizaveta Kovtun, Matvey Konovalov, Andrey Sakhovskiy, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Tactile-JEPA: 분산 촉각 센서(distributed tactile sensors)를 위한 효율적인 self-supervised pre-training 방법론으로, 센서의 공간적 배치(spatial arrangement)를 활용하여 topology-aware representations를 학습한다.
- Distributed Tactile Sensors (e-skin): 얇고 유연한 전자 피부 형태로, sensing element (taxels)들이 표면에 희소하고 불규칙하게 배열되어 multivariate time series 출력을 생성한다.
- Taxel Graph: 분산 촉각 센서의 공간 구조를 포착하는 연결 그래프로, taxel들이 노드(nodes)를 구성하고 인접한 taxel 간에 엣지(edges)가 연결된다.
- Multi-scale Masking: Tactile-JEPA에서 사용되는 마스크 샘플링 전략으로, taxel graph 상에서 compact한 영역을 다루는
local마스크와 표면에 분산된 taxel들을 다루는global마스크를 모두 활용하여 다양한 접촉 패턴(contact patterns)을 포착한다. - Joint-Embedding Predictive Architecture (JEPA): 예측 임베딩과 target encoder의 임베딩 간의 mean squared error (MSE)를 최소화하여 표현을 학습하는 self-supervised learning (SSL) 프레임워크로, 직접적인 raw signal 예측을 피한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
로봇이 다양한 작업과 환경에서 일반화(generalization) 능력을 갖추려면 vision-language-action (VLA) 모델이 필수적이지만, 시각 정보만으로는 폐색(occlusion), 정교한 접촉 기반 조작(dexterous contact-rich manipulation), 그리고 취약한 물체와의 상호작용 상황에서 한계가 있다. 이로 인해 tactile sensing이 중요한 양상(modality)으로 부상하지만, 기존 촉각 인코더(tactile encoders)는 종종 raw하고 noisy한 신호로부터 처음부터 학습되어 표현력(expressivity)이 제한적이었다. 특히, 기존 self-supervised learning (SSL) 접근 방식은 주로 이미지 기반(vision-based) 촉각 센서에 초점을 맞춰왔으며, 이 센서들은 이미지 스트림을 출력하므로 시각 기반 SSL 방법론을 직접 적용할 수 있었다. 그러나 distributed electronic skins (e-skins)와 같은 분산 촉각 센서는 sensing element (taxels)들이 희소하고 불규칙하게 배열되어 multivariate time series를 출력하기 때문에, 기존 시각 기반 SSL 방법을 직접 재사용하는 것은 최적의 결과를 얻기 어려웠다. 이전 연구들은 분산 촉각 신호를 이미지 형태로 변환하거나(공간 구조 손실), taxel별 위치 특징만 활용(연결성 무시), 또는 task-specific labels나 시뮬레이션 데이터에 의존하는 한계를 보였다. 따라서, 본 연구는 센서의 알려진 레이아웃(layout) 정보 외에 어떠한 privileged simulation information도 필요로 하지 않으면서 센서의 topology를 명시적으로 나타내는 self-supervised pre-training 방법론의 부재 문제를 해결하고자 한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 분산 촉각 센서에 특화된 self-supervised representation learning 방법인 Tactile-JEPA를 제안한다. 이 방법론은 I-JEPA를 확장하여 마스킹된 taxel들의 임베딩(embeddings)을 가시적인 taxel들로부터 예측하도록 학습한다. Tactile-JEPA의 핵심 혁신은 taxel connectivity graph를 기반으로 하는 multi-scale mask sampling 전략에 있다. 먼저, 센서의 알려진 레이아웃에 따라 인접한 taxel들을 연결하여 taxel graph를 구성하며, 이 그래프는 시간 창(time windows)에 걸쳐 고정된다. 마스크는 픽셀 그리드(pixel grid)가 아닌 이 taxel graph 위에서 샘플링되며, local 마스크는 compact한 센서 영역을 커버하여 지역화된 접촉 패턴(localized contact patterns)을 포착하고, global 마스크는 그래프 전체에 흩어진 taxel들로 구성되어 전체 contact state를 반영한다 [Figure 2]. Pre-training 과정에서는 context encoder가 가시적인 taxel 임베딩을 처리하고, target encoder는 모든 taxel 임베딩을 처리하며 context encoder의 Exponential Moving Average (EMA)로 업데이트된다 [Figure 2]. Predictor는 context 임베딩과 target taxel들의 위치 임베딩을 받아 target taxel들의 임베딩을 추론하며, self-supervised loss는 예측된 임베딩과 stop-gradient가 적용된 target encoder 출력 간의 Mean Squared Error (MSE)로 정의된다 [Figure 2].
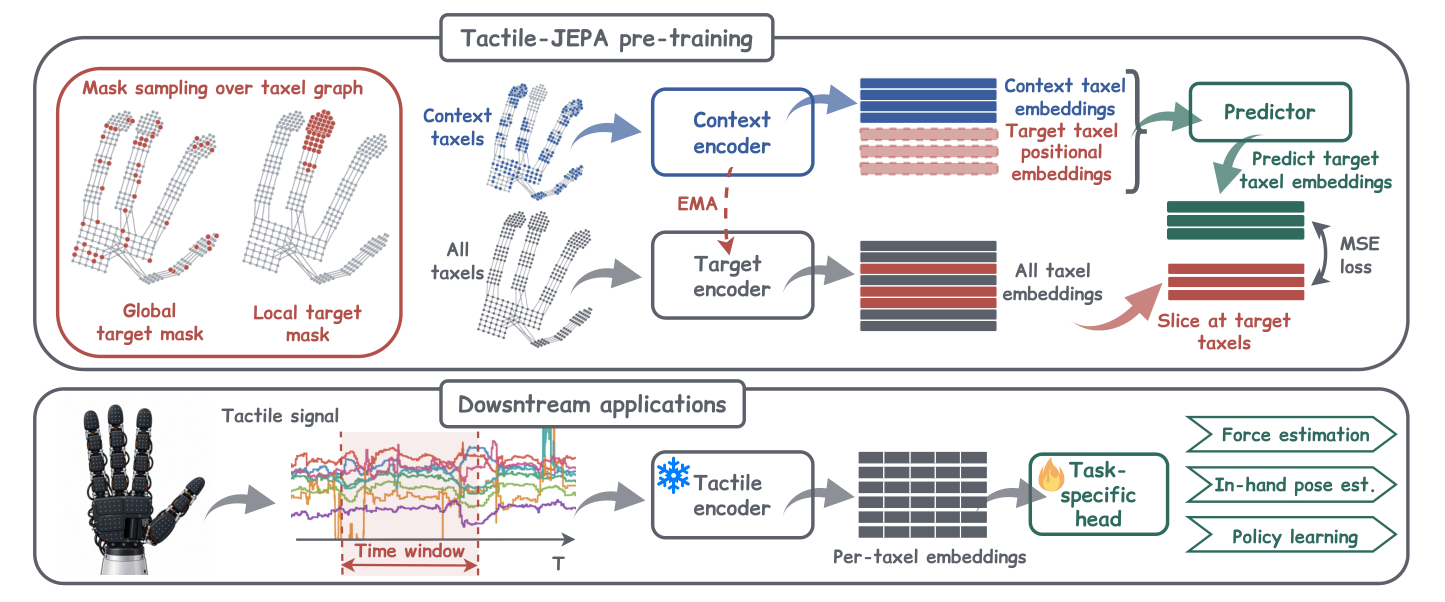
Figure 2 — Tactile-JEPA의 전체 워크플로우
실험 결과, Tactile-JEPA는 Sparsh-skin, Tactile socks, DECO-50의 세 가지 이질적인 데이터셋과 다양한 로봇 구현체(robot embodiments), 센서 유형(magnetic 및 piezoresistive)에 걸쳐 기존 state-of-the-art 방법론 대비 일관된 성능 향상을 입증했다 [Table II, Table III]. 특히, Sparsh-skin 데이터셋에서 force estimation error를 6.3% 감소시키고, in-hand orientation error (θ-RMSE)를 20.8% 감소시켰다 [Table II]. Tactile socks 데이터셋에서는 action classification accuracy를 1.28% 향상시키고, full-body pose estimation RMSE를 2.6% 감소시켰다 [Table II]. Ablation study 결과, graph-based sampling이 image-style blocks 기반 마스킹보다 우수하며, multi-scale targets (local 및 global 마스크 혼합)가 general-purpose pre-training을 위한 강력한 선택임을 확인했다 [Table IV].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 분산 촉각 센서의 taxel 공간 배열을 활용하는 self-supervised pre-training 방법인 Tactile-JEPA를 성공적으로 제안했다. Tactile-JEPA의 핵심은 taxel graph를 기반으로 하는 multi-scale mask sampling 전략에 있으며, 이를 통해 국부적인 촉각 신호와 전체적인 접촉 상태를 모두 인코딩하는 topology-aware representations를 학습한다. 이 연구에서 학습된 임베딩은 다양한 downstream tasks 및 로봇 구현체에 걸쳐 일반화(generalization)될 수 있으며, in-hand orientation estimation에서 20.8%, force estimation에서 6.3%의 오류 감소를 달성하는 등 강력한 baseline 대비 상당한 성능 향상을 가져왔다. 또한, Tactile-JEPA는 모든 센서 유형에서 안정적인 pre-training을 가능하게 한 반면, 일부 경쟁 SSL 방법론은 특정 데이터셋에서 학습 불안정성(training instability)을 보였다. 전반적으로 Tactile-JEPA는 로봇 학습 분야에서 효과적인 넓은 범위의 촉각 감지(wide-coverage tactile sensing)를 실질적으로 구현 가능하게 하며, 로봇의 정교한 조작 능력(dexterous manipulation capabilities)을 향상시키는 데 크게 기여할 것으로 기대된다.
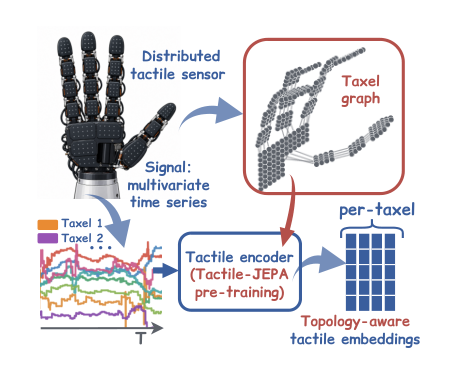
Figure 1 — 제안 모델의 개요
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Embedding Physics Priors in Robot Learning: A Survey
- [논문리뷰] From Pretraining to Proficiency: Real-World Subtask RL for Long-Horizon Manipulation with Minimal Human Intervention
- [논문리뷰] In-Context Robot Learning with VLM Agents
- [논문리뷰] CardioState-JEPA: Delay-Aware Cross-Modal Learning of a Shared Cardiac Representation
- [논문리뷰] H2R-Bench: Benchmarking Human-to-Robot Manipulation Video Generation in World Models
Review 의 다른글
- 이전글 [논문리뷰] TRACE: Temporal Audit and Condition-aware Evaluation of Streaming Video Understanding
- 현재글 : [논문리뷰] Tactile-JEPA: Topology-Aware Self-Supervised Representation Learning for Distributed Tactile Sensors
- 다음글 [논문리뷰] TrackEverything: Long Horizon Dense Tracking via De-Duplicating 3D Scene Representations
댓글