[논문리뷰] From Pretraining to Proficiency: Real-World Subtask RL for Long-Horizon Manipulation with Minimal Human Intervention
링크: 논문 PDF로 바로 열기
저자: Sichang Su, Benjamin Yang, Zhiyun Deng, Boyuan Liang, Yip Fun Yeung, Zelin Wang, Lingfeng Sun
1. Key Terms & Definitions (핵심 용어 및 정의)
- PARTS (Policy Adaptation with RL on Targeted Subtasks): Pretrained policy의 신뢰할 수 있는 동작은 유지하면서, 실패가 잦은 특정 Bottleneck Subtask에 대해서만 Residual RL을 수행하여 성능을 개선하는 프레임워크입니다.
- Residual Policy: Pretrained VLA(Vision-Language-Action) 모델의 reference action chunk에 경량화된 보정값을 더해주는 방식입니다. 전역 정책을 수정하지 않고 특정 subtask의 국소적 개선을 목표로 합니다.
- Agentic Scaffolding: Coding agent가 계약서(Contract)를 기반으로 Policy Selector, Success Verifier, Auto-Reset Policy를 작성하여, 사람의 개입을 최소화하면서 RL 학습 루프를 자동화하는 기법입니다.
- Success-Reweighted Retraining: 성공한 에피소드 데이터의 비중을 높이고 실패한 데이터의 샘플링 비율을 조정한 데이터셋으로 Residual Policy를 주기적으로 재학습하여, 특정 환경에 대한 과적합을 방지하고 일반화 성능을 확보하는 전략입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 긴 호흡의(Long-horizon) 로봇 조작 태스크에서 Pretrained policy가 전반적으로는 유능하지만 특정 핵심 Subtask에서 반복적으로 실패하는 문제를 해결하고자 합니다 [Figure 1]. 기존의 Supervised Fine-Tuning(SFT) 방식은 성공적인 동작까지 반복해서 시연해야 하므로 사람의 노동력이 과도하게 소요되며, 전체 태스크에 대한 RL Fine-tuning은 Sparse reward 문제로 인해 성공적인 학습이 어렵다는 한계가 있습니다. 특히, 모든 Subtask를 성공해야만 보상을 받는 환경에서는 초기 실패로 인해 뒤쪽 Subtask에 대한 연습 기회 자체가 차단됩니다. 따라서 저자들은 사람이 정의한 병목 지점에 학습을 집중시키고, 각 Subtask별 국소적 보상을 통해 학습 효율을 극대화하는 새로운 프레임워크를 제안합니다.
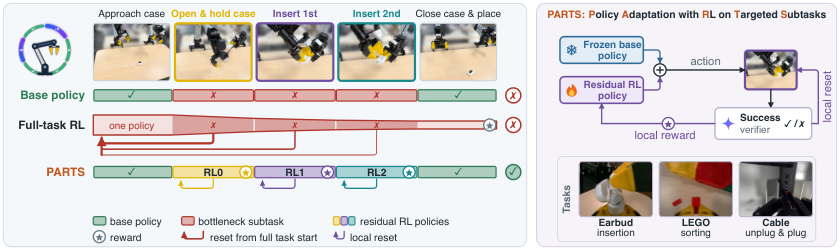
Figure 1 — PARTS의 전체 개념도
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 Pretrained VLA 모델을 고정(Frozen)한 상태에서 Residual Policy를 통해 실패 지점만 수정하는 PARTS 프레임워크를 제안합니다 [Figure 2]. 각 병목 구간에 도달하면 Policy Selector가 이를 감지하여 Residual action을 적용하고, Success Verifier가 매 시도마다 성공 여부를 판단하여 보상을 제공함으로써 학습의 credit-assignment horizon을 획기적으로 단축합니다. 학습 효율을 높이기 위해 주기적으로 성공 데이터를 강조하는 Success-Reweighted Retraining을 수행하며, 이를 통해 재학습된 정책을 다시 배포하는 순환 구조를 갖습니다 [Figure 2].
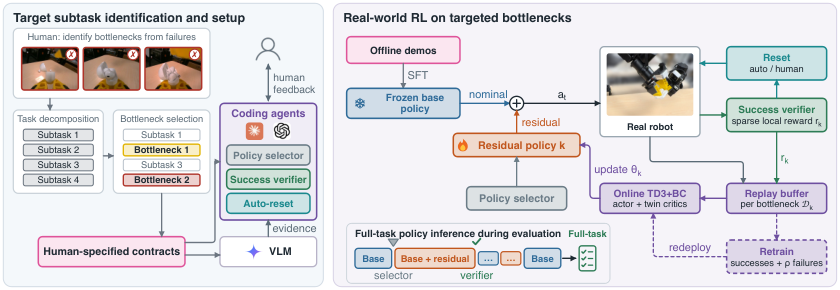
Figure 2 — PARTS 아키텍처 및 학습 루프
실험 결과, PARTS는 bimanual YAM 태스크에서 전체 태스크 성공률을 32%에서 61%로, single-arm Franka 태스크에서는 50%에서 95%로 크게 향상시켰습니다 [Figure 4]. 동일한 로봇 Rollout 예산 하에서 기존 RL 기반 Fine-tuning 기법들 대비 성공률을 25% 이상 높였으며, 특히 실세계 데이터 수집 시간을 대폭 단축하는 성과를 보였습니다. 이러한 결과는 제한된 학습 예산 환경에서도 적재적소에 RL 자원을 집중하는 것이 긴 호흡의 태스크 해결에 결정적임을 입증합니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Pretrained 로봇 정책의 한계를 효과적으로 극복할 수 있는 PARTS 프레임워크를 통해 실세계 로봇 학습의 새로운 가능성을 제시합니다. 특히 인간의 개입을 최소화하면서도 병목 구간에 학습을 집중시키는 Residual RL 전략은 실용적인 로봇 운영 측면에서 매우 높은 효율성을 보입니다. 이 연구는 로봇 학습의 자동화와 더불어, 고난도 긴 호흡 태스크에서 범용 모델의 활용도를 극대화할 수 있는 강력한 방법론적 토대를 마련했다는 평가를 받습니다. 향후 연구에서는 Bottleneck 탐지부터 보상 설계, 복구 동작 학습까지 전 과정을 완전 자동화하는 방향으로 발전할 것으로 기대됩니다.
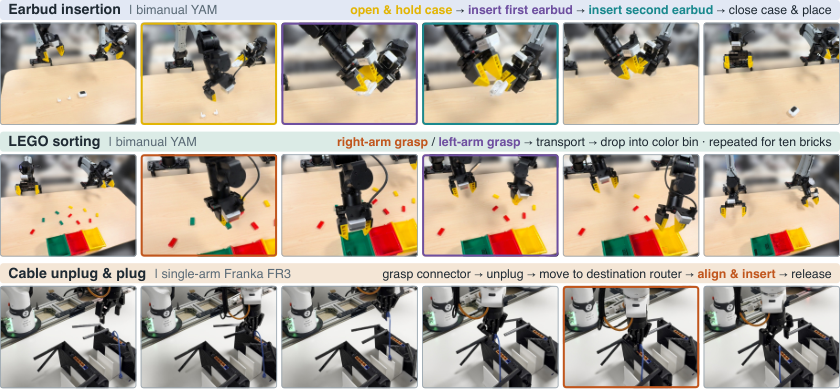
Figure 3 — 실험 대상 롱호라이즌 태스크
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Progress Reward Modeling for Robotic Learning: A Comprehensive Survey
- [논문리뷰] Data Pyramid for Embodied Manipulation
- [논문리뷰] How Post-Training Shapes Biological Reasoning Models
- [논문리뷰] AlloSpatial: Agentic Harness Framework for Spatial Reasoning in Foundation Models
- [논문리뷰] RISE: Self-Improving Robot Policy with Compositional World Model
Review 의 다른글
- 이전글 [논문리뷰] FRAUDSkill: Structured Frozen-Weight Skill Optimization for Audio Anti-Fraud Detection
- 현재글 : [논문리뷰] From Pretraining to Proficiency: Real-World Subtask RL for Long-Horizon Manipulation with Minimal Human Intervention
- 다음글 [논문리뷰] GAVEL: Graph World Models for Verified and Efficient Long-Horizon LLM Task Planning
댓글