[논문리뷰] Ovis-Embedding: Pushing the Frontiers of Universal Omni-Modal Embeddings
링크: 논문 PDF로 바로 열기
저자: Ke Zhu, Yawen Liu, Wenjun Yan, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Ovis-Embedding: 텍스트, 이미지, 비디오, 오디오의 Native 통합을 기반으로 구축된 최첨단 Omni-Modal Embedding Family이다.
- Omni-Modal Embeddings: 텍스트, 이미지, 비디오, 오디오와 같은 다양한 모달리티를 단일의 일관된 Representation Space에 인코딩하는 임베딩을 지칭한다.
- Any-to-Any Retrieval: 쿼리가 여러 모달리티로 구성될 수 있으며, 동일한 인덱스 내에서 다른 모달리티의 후보와 직접 매칭될 수 있는 일반적인 검색 설정을 의미한다.
- Focal-Weighted Contrastive Loss: 현재 검색 난이도에 따라 쿼리의 가중치를 동적으로 재조정하여, 이미 잘 분리된 예시의 기여를 줄이고 미해결 쿼리에 최적화 예산을 집중시키는 기법이다.
- Embedding Distillation: 보완적인 전문가 모델로부터 Fine-Grained 유사성 구조를 전이하기 위해 Similarity Distribution을 활용하는 손실 함수이다.
- Elastic Embedding Inference: Low-Rank Feature Decomposition을 통해 유연한 차원과 최소한의 성능 손실로 Compact Embedding을 가능하게 하는 추론 최적화 방식이다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 현대 정보 저장소가 텍스트, 이미지, 비디오, 오디오 등 다양한 모달리티를 통합함에 따라 발생하는 Any-to-Any Retrieval의 요구사항을 해결하고자 한다. 기존 Multimodal Embedder는 비전-언어 전문 모델이 오디오를 지원하지 않거나, 기존 Omni-Modal 시스템이 오디오를 이미 학습된 텍스트-비전 Geometry에 적응시키는 방식으로 인해 Universal Retrieval을 위한 불완전한 기반을 제공한다. 이러한 접근 방식은 종종 Fine-Grained Alignment를 제한하며, 이질적인 입력을 동일한 크기의 벡터로 단순히 표현하는 것만으로는 충분하지 않아 일관성 있고 정밀하게 Calibration된 Semantic Space의 필요성이 대두된다. 저자들은 기존 연구들의 모달리티 파편화(Modality Fragmentation) 문제를 지적하며, Text, Vision, Audio, Video를 Shared Model로 Native하게 처리하는 통합 인코더의 필요성을 강조한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Qwen-Omni Understanding Model을 기반으로 하는 Ovis-Embedding Family를 제안하며, 이는 Text, Image, Video, Audio의 Native 통합을 통해 Universal Omni-Modal Embeddings를 구현한다. 제안하는 방법론은 세 가지 주요 발전 요소를 포함한다. 첫째, Native Omni-Modal Initialization을 통해 Pretrained Qwen-Omni 모델을 Embedding Backbone으로 채택하고, Low-Rank Initialization과 Contrastive Training을 통해 이를 적응시킨다 [Figure 2]. 이는 모달리티별 Projection Head 없이 공유된 Multi-Modal Backbone을 사용하여 다양한 모달리티를 Common Representation Space에 인코딩한다. 둘째, Data-Centric Omni-Modal Training을 위해 Text, Image, Video, Audio, Interleaved Multi-Modal Data를 아우르는 광범위하고 고품질의 Corpus를 구축하며 [Figure 3], 데이터 효율성을 높이기 위해 Homogeneous-Source Sampling을 도입하여 Task-Consistent Batch를 형성한다. 셋째, Embedding-Specific Training and Inference Optimization을 통해 Hard Example에 중점을 두는 Focal Loss와 보완적인 Expert로부터 Fine-Grained Similarity Structure를 전이하는 Similarity-Based Embedding Distillation을 사용한다 [Figure 5]. 추론 시에는 Low-Rank Feature Decomposition을 통해 유연한 차원의 Compact Embedding을 지원하며, 이는 최소한의 성능 손실로 Index Storage 및 Similarity-Computation Cost를 줄인다.
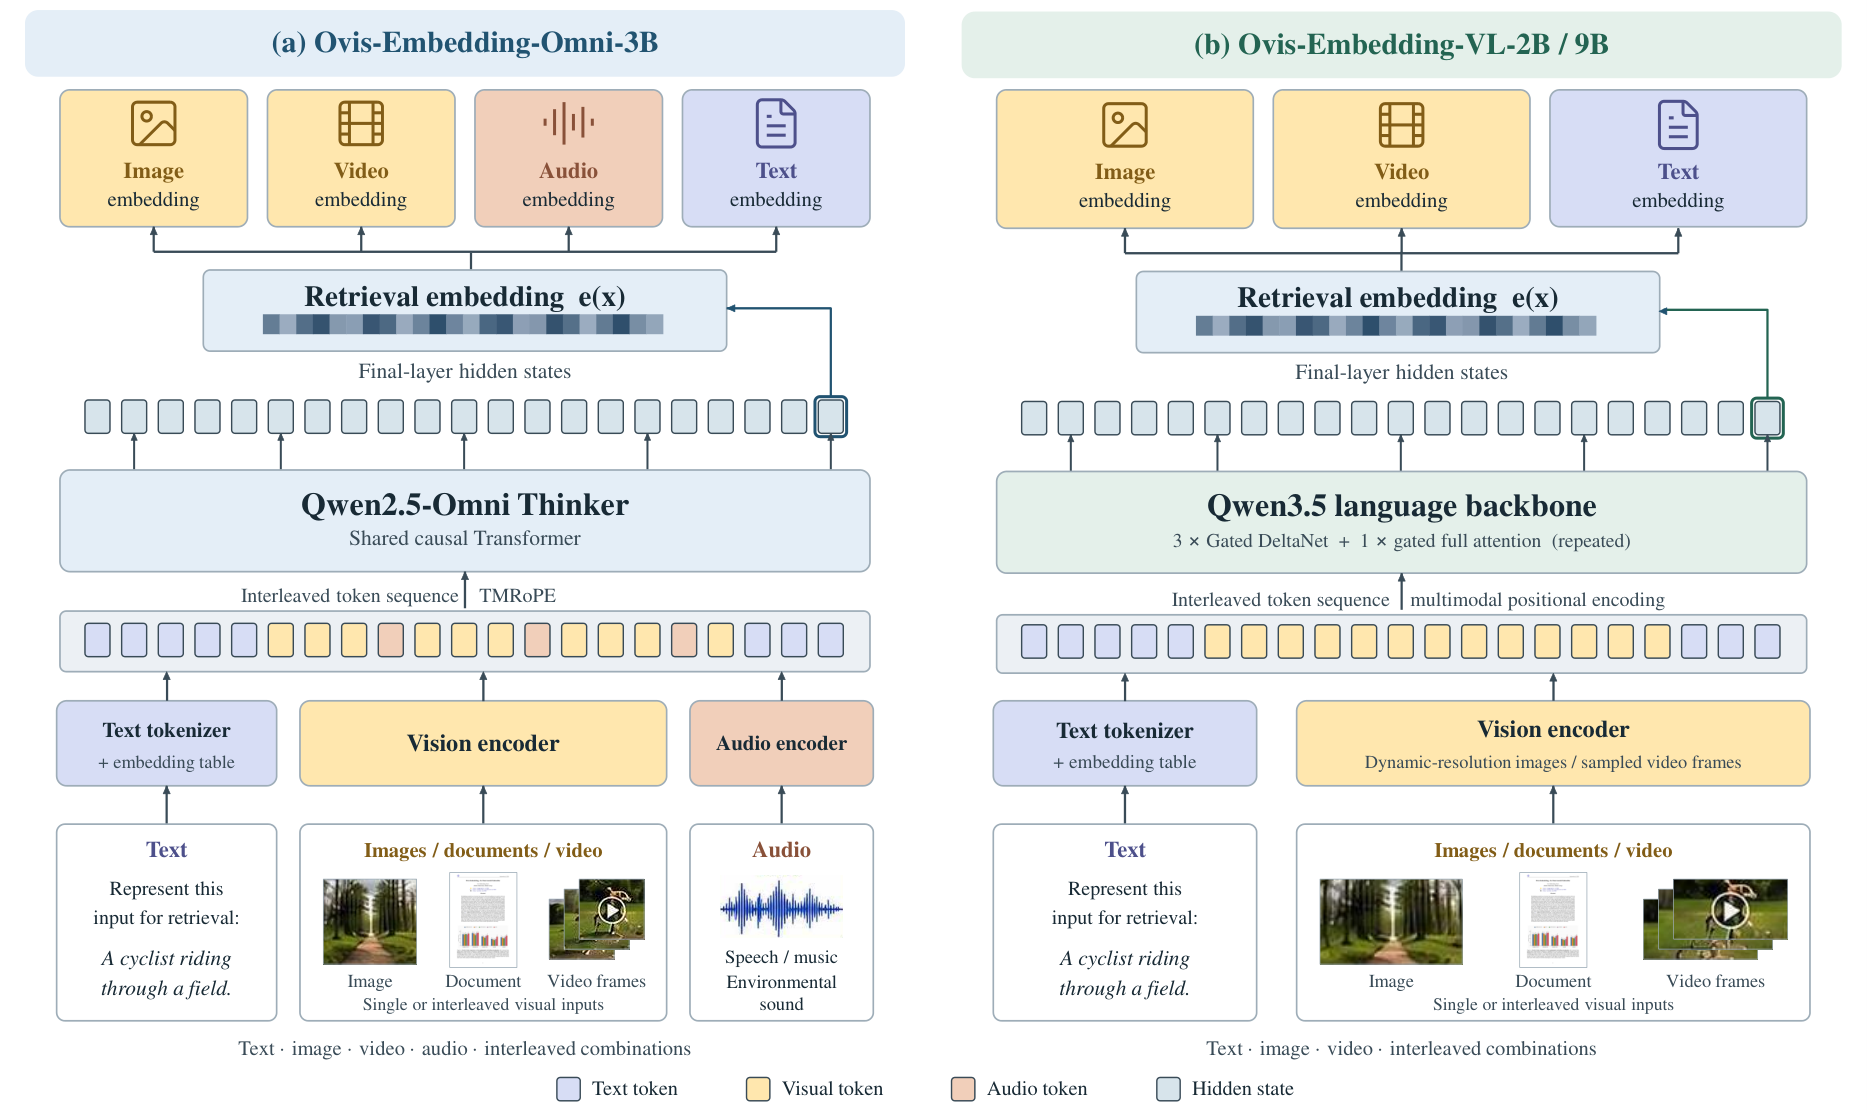
Figure 2 — Ovis-Embedding 아키텍처
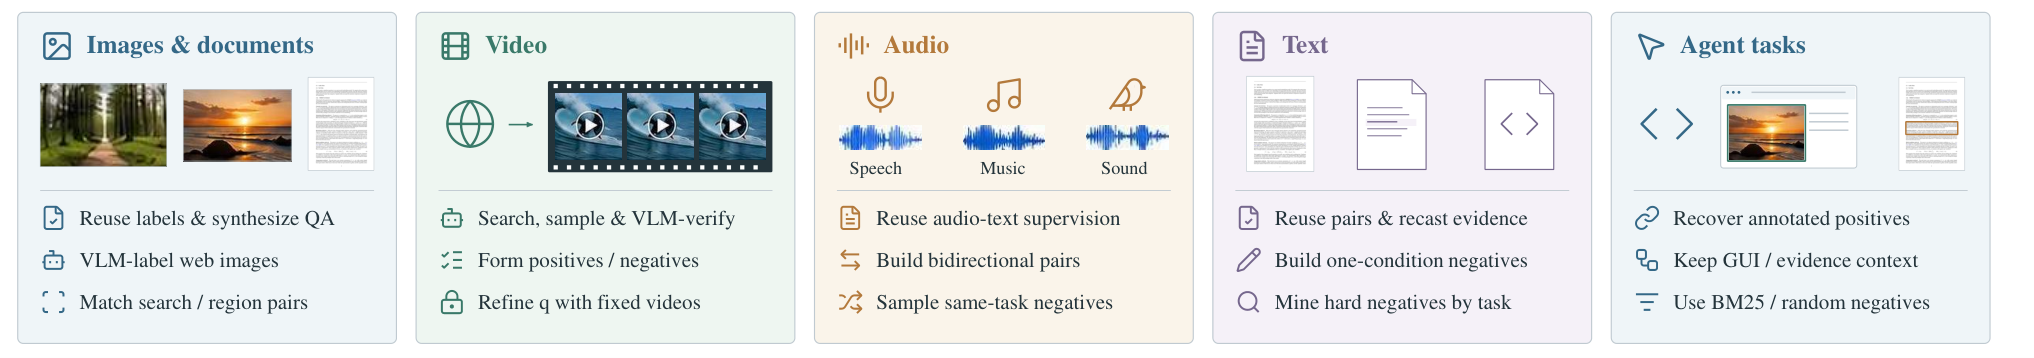
Figure 3 — 모달리티별 데이터 구성
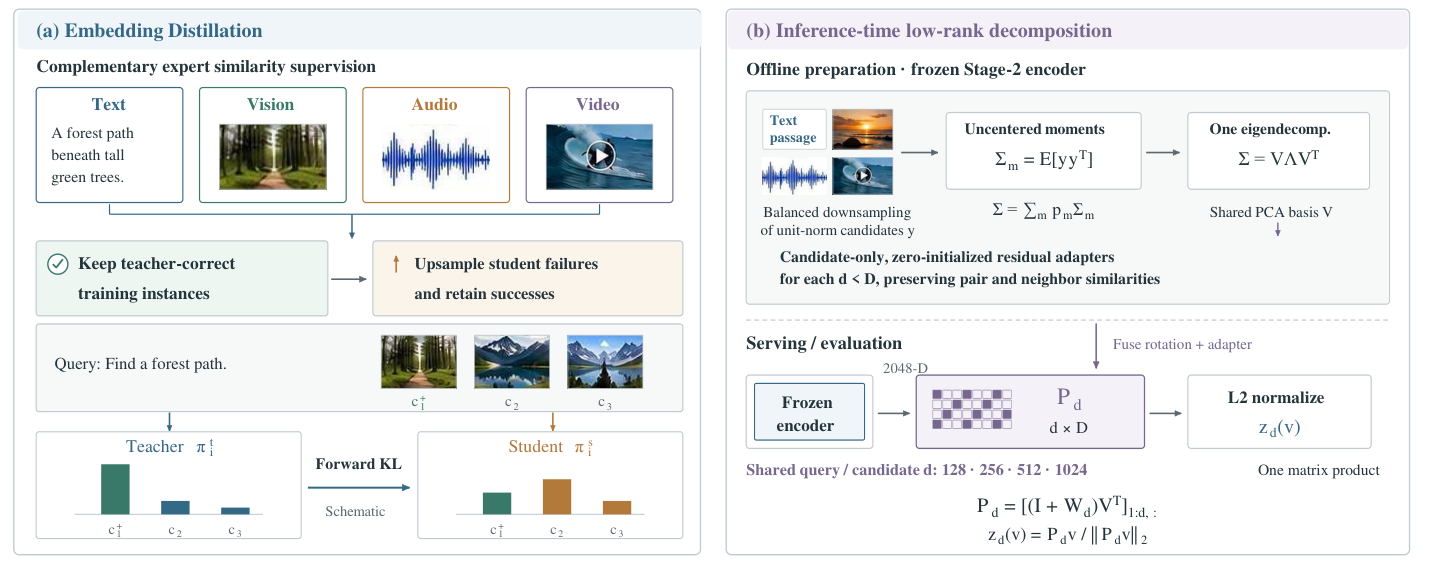
Figure 5 — 학습 및 추론 최적화
실험 결과, Ovis-Embedding Family는 여러 Benchmark에서 최첨단 성능을 달성했다. 특히 Ovis-Embedding-Omni-3B는 MMEB-v3에서 58.46의 Overall Score를 기록하며, 기존 최강 Baseline인 Tianmu-Emb-Uni(53.27)를 5.19점 차이로 앞선다. 또한 MAEB에서 Mean(Task) Score 57.29와 Mean(Type) Score 61.22를 기록하며 각각 3.75점, 4.10점의 차이로 경쟁 모델을 능가했다. MVEB에서도 Mean(Task) 61.77과 Mean(Type) 59.72로 2위 모델보다 각각 4.19점, 3.49점 높은 성능을 보였다. 비전-언어 변형 모델인 Ovis-Embedding-VL-9B는 MMEB-v2에서 Overall Score 81.13을 달성하여 Octen-VL-Embedding-Large를 1.04점 차이로 앞섰으며, Ovis-Embedding-VL-2B는 MMEB-v2에서 77.46을 기록하며 Octen-VL-Embedding보다 2.04점 높은 성능을 보여주었다. Elastic Embedding은 128차원 Embedding(원래 차원의 16배 축소)에서도 전체 성능의 93.2%를 유지하여 효율적인 배포 가능성을 입증했다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Native Multimodal Backbone, Data-Centric Training, Embedding-Specific Optimization을 결합한 Universal Embedding Family인 Ovis-Embedding을 제시한다. 이 모델은 MMEB-v3, MMEB-v2, MAEB, MVEB와 같은 주요 Benchmark에서 최첨단 성능을 달성했으며, 효율적인 배포를 위한 유연한 Embedding Dimension을 지원한다. 이러한 결과는 Omni-Modal Model이 Search, Retrieval-Augmented Generation, Recommendation, Agentic System 등 다양한 분야에서 Universal Retrieval의 핵심 기반이 될 수 있음을 시사한다. 연구팀은 모델 체크포인트, Training 및 Data-Construction Recipes, Inference Code, Unified Evaluation Toolkit을 공개할 예정이며, 이는 Audio, Audio-Video, Any-to-Any Retrieval과 같이 기존 자원으로 부족했던 분야에서 Universal Embedding Model 개발 및 평가를 위한 견고한 기반을 제공할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] QCell: Recombining and Aligning Cell Queries for Overlapping Instance Segmentation
- [논문리뷰] On the Design Fundamentals of Pixel Text Representation Learning
- [논문리뷰] WeMM-Embedding: WeChat Multi-Modal Embedding Technical Report
- [논문리뷰] DiSCO: Defending text-to-image generation through distribution-guided contrastive prompt optimization
- [논문리뷰] FATE: Frame-Level Audio-Visual Temporal Embedding
Review 의 다른글
- 이전글 [논문리뷰] Lean Pool: An AI-Maintained Archive of Formalized Mathematics
- 현재글 : [논문리뷰] Ovis-Embedding: Pushing the Frontiers of Universal Omni-Modal Embeddings
- 다음글 [논문리뷰] RULER: Instance-aware Rubric Rewards for SVG Generation
댓글