[논문리뷰] RULER: Instance-aware Rubric Rewards for SVG Generation
링크: 논문 PDF로 바로 열기

Figure 1 — 평가 지표 및 RULER 루브릭 비교

Figure 2 — RULER 개요

Figure 5 — 정성적 비교 결과
Part 1: 요약 본문
저자: Hangyu Ran, Yuhao Zheng, Yingying Zhang, Kevin Qinghong Lin, Han Peng
1. Key Terms & Definitions (핵심 용어 및 정의)
- SVG (Scalable Vector Graphics): 자연어 지시로부터 생성되는 벡터 그래픽 코드로, 정확한 그래픽을 렌더링하며 구조화되고 실행 가능한 특성을 가진다.
- Instance-aware Rubric: 각 텍스트 명령(instruction)에 대해 의미론적(semantic), 시각적(visual), 스타일적(stylistic) 세 가지 축에 걸쳐 여섯 가지 항목으로 구성된 맞춤형 평가 기준.
- VLM (Vision-Language Model): 렌더링된 SVG를 Instance-aware Rubric에 따라 항목별로 점수를 매기는 데 사용되는 모델.
- Reward Hacking: RL에서 정책이 실제 목표 달성보다는 보상 신호를 쉽게 부풀릴 수 있는 방향으로 최적화되는 현상.
- Group Relative Policy Optimization (GRPO): 동일 그룹 내 출력의 상대적 보상으로부터 이점(advantage)을 추정하여 정책 업데이트를 유도하는 강화 학습 최적화 기법.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Scalable Vector Graphics (SVG) 코드를 자연어 명령으로부터 생성하는 개방형(open-ended) 작업에서 신뢰할 수 없는 평가 지표와 불충분한 훈련 신호 문제를 해결하고자 한다. SVG 생성은 명확한 시각적 Ground Truth가 존재하지 않아 평가 및 정책 최적화에 충실한 신호가 부족하다는 근본적인 어려움이 있다. 기존의 CLIPScore, Aesthetic Classifier, Human Preference Score와 같은 Scalar Metrics는 포토리얼리스틱(photorealistic) 자연 이미지에 맞춰 보정되었기 때문에 Stylized Vector Content에는 잘 적용되지 않으며, 종종 손상된 SVG에 더 높은 점수를 부여하거나 Human Judgment와 약한 상관관계를 보인다 [Figure 1]. 이러한 Scalar Metrics를 강화 학습(RL)의 Reward로 사용할 경우, 정책이 실제 품질 향상 대신 Reward Hacking을 유발하는 경향이 있다. 이로 인해 기존 Supervised Fine-tuning은 데이터셋에 특화된 템플릿의 Behavioral Cloning으로 제한되고 일반화에 실패하며, RL은 Reward 선택에 의해 성능이 좌우되는 문제가 발생한다.
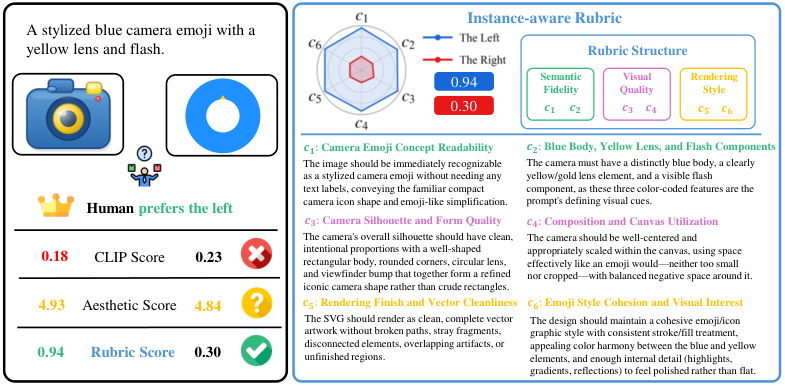
Figure 1 — 평가 지표 및 RULER 루브릭 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 개방형 SVG 생성의 Reward Design 문제를 해결하기 위해 RULER (Instance-aware Rubric Rewards for Reinforcement LEaRning)를 제안한다. RULER는 텍스트 명령으로부터 Semantic Fidelity, Visual Quality, Rendering Style의 세 가지 축을 아우르는 여섯 가지 항목의 Instance-aware Rubric을 생성한다 [Figure 2]. Judge VLM이 렌더링된 SVG Rollout을 이 Rubric에 따라 항목별로 점수화하며, 이 가중치 적용된 만족도(weighted satisfactions)가 미세 조정된 Reward로 사용되어 Group Relative Policy Optimization (GRPO)을 통해 정책을 최적화한다. 이 Rubric은 텍스트만으로 생성되므로, 별도의 SVG Ground Truth나 Human Preference Label이 필요 없다.
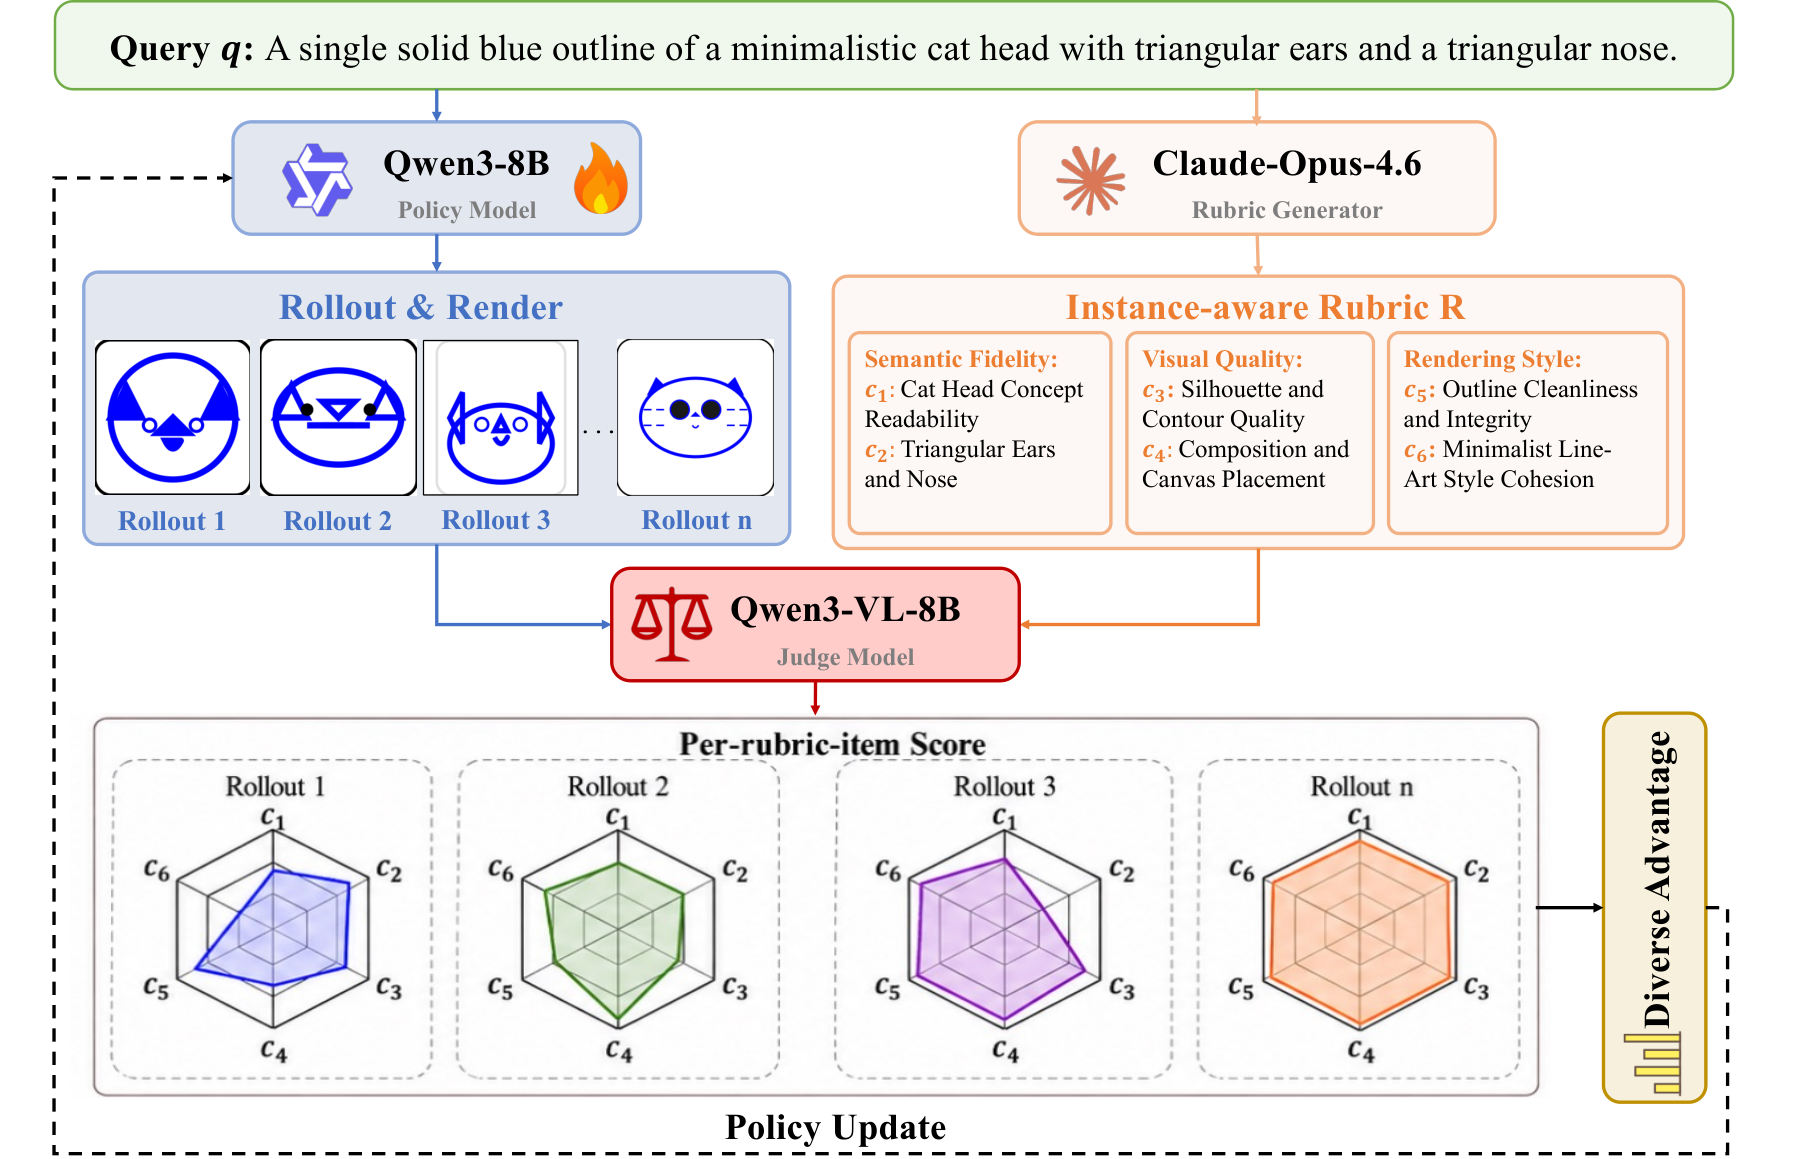
Figure 2 — RULER 개요
실험 결과, RULER는 MMSVG-Illustration 및 MMSVG-Icon 벤치마크에서 기존 SOTA(State-of-the-Art) 모델들을 크게 능가하는 성능을 보였다. 예를 들어, RULER는 Qwen3-8B 백본 모델 대비 Rubric Score를 MMSVG-Illustration에서 0.432에서 0.693으로, MMSVG-Icon에서 0.395에서 0.683으로 크게 향상시켰다. 이는 전용 SVG 전문가 모델들을 능가하며, 훨씬 큰 규모의 DeepSeek-V3와 필적하는 수준이다. 또한, RULER는 VectorFusion 대비 MMSVG-Illustration에서 0.693 대 0.611, MMSVG-Icon에서 0.683 대 0.510의 높은 Rubric Score를 달성했다. Reward Design 분석에서, RULER는 다른 RL Reward 디자인(Zero-Shot, C+A+H RL, Universal Rubric RL) 중 가장 높은 Rubric Score를 기록하여, Instance-aware Rubric이 가장 강력하고 균형 잡힌 성능 향상을 제공함을 입증했다. 특히, C+A+H RL은 Aesthetic Score를 크게 부풀리면서도 Rubric Score는 Zero-Shot보다 낮은 0.262로 하락시켜 Reward Hacking의 실패 사례를 명확히 보여주었다. 인간 평가(Human Preference Study)에서도 RULER는 모든 Baseline 대비 50% 이상의 Non-tie Win Rate를 달성하며 정성적 우수성을 확인했다. 특히, JanusCoder 대비 96.5%의 높은 Win Rate를 기록했다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 다축 Rubric 기반의 SVG 평가 방식이 인간의 판단과 높은 상관관계를 가진다는 것을 실증적으로 확립하였다. 이를 기반으로, 저자들은 Instance-aware Rubric을 조밀한(dense) Reward로 전환하고 Group Relative Policy Optimization (GRPO)을 통해 최적화하는 RULER를 제안했다. RULER는 Reward Hacking 문제를 완화하고, Scalar Reward 기반의 RL Baseline과 전용 SVG 전문가 모델들을 능가하는 SOTA 성능을 달성했으며, 다양한 Base Model과 Rubric Generator에 걸쳐 견고한(robust) 효과를 보였다. 이 연구는 개방형 Visual Code 생성 분야에서 평가 및 훈련 신호의 근본적인 한계를 극복하는 새로운 패러다임을 제시하며, 향후 더욱 정교하고 인간 중심적인 Visual Content 생성 모델 개발에 중요한 시사점을 제공한다. 특히, Ground Truth나 Human Preference Label 없이도 고품질의 Fine-grained Reward를 생성할 수 있는 능력은 대규모 데이터셋 구축의 비용과 복잡성을 줄이는 데 기여할 것으로 예상된다.
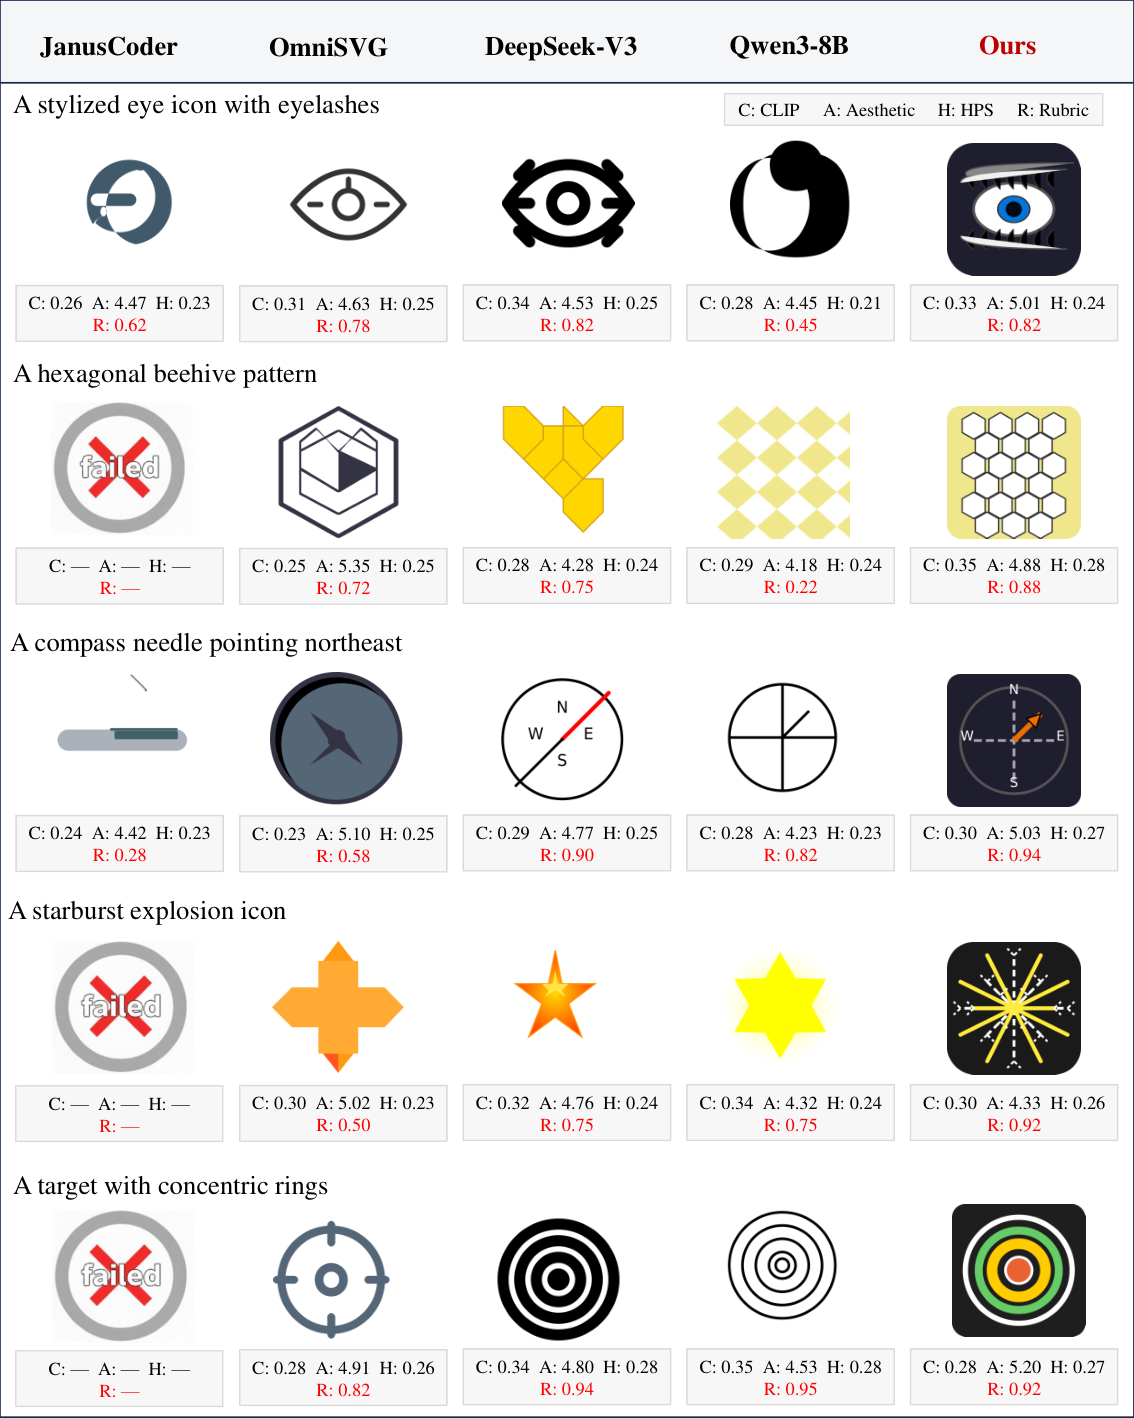
Figure 5 — 정성적 비교 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Stable-Layers: Fine-Tuning Image Layer Decomposition Models with VLM-Scored Reinforcement Learning
- [논문리뷰] Reproducing, Analyzing, and Detecting Reward Hacking in Rubric-Based Reinforcement Learning
- [논문리뷰] SAAS: Self-Aware Reinforcement Learning for Over-Search Mitigation in Agentic Search
- [논문리뷰] VectorGym: A Multitask Benchmark for SVG Code Generation, Sketching, and Editing
- [논문리뷰] UniGRPO: Unified Policy Optimization for Reasoning-Driven Visual Generation
Review 의 다른글
- 이전글 [논문리뷰] Ovis-Embedding: Pushing the Frontiers of Universal Omni-Modal Embeddings
- 현재글 : [논문리뷰] RULER: Instance-aware Rubric Rewards for SVG Generation
- 다음글 [논문리뷰] Recursive self-improvement of AI research agents
댓글