[논문리뷰] IterSynth: Rethinking Deep Search Agents via Role-Decoupled Iterative Synthesis
링크: 논문 PDF로 바로 열기
메타데이터
저자: Xingyu Wu, Yuchen Yan, Zhengxi Lu, Siqi Chen, Xin ZHANG, Aiting Liu, Chao Deng, Jie Liu, Jin Ma, Jian Shao, Jun Xiao, Yongliang Shen
1. Key Terms & Definitions (핵심 용어 및 정의)
- IterSynth: Planner와 Synthesizer라는 두 가지 역할을 하나의 LLM policy로 수행하는 역할 분리(Role-decoupled) 및 요약 기반(Summary-based) 딥 서치 프레임워크입니다.
- Planner: 현재 연구 상태(Global Summary)를 바탕으로 다음 검색 쿼리를 생성하거나 최종 답변을 결정하는 역할을 담당합니다.
- Synthesizer: 검색된 증거를 바탕으로 Global Summary를 업데이트하고, 불필요한 노이즈를 필터링하며 정보의 일관성을 유지하는 역할을 수행합니다.
- RDPO (Role-Decoupled Policy Optimization): 딥 서치 과정에서 Planner와 Synthesizer 각각의 역할에 특화된 피드백을 제공하고, 역할별로 Advantage를 독립적으로 계산하여 학습 효율을 높이는 강화학습 방법론입니다.
- Global Summary (Mt): 검색 과정에서 수집된 정보가 압축되어 저장되는 지속적인 메모리 상태로, 에이전트의 현재 추론 상태를 나타냅니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 ReAct 스타일 딥 서치 에이전트가 겪는 '역할 결합(Role Coupling)'과 '컨텍스트 누적(Context Accumulation)' 문제를 해결하는 것을 목적으로 합니다. 기존 연구들은 단일 정책이 계획, 검색, 증거 활용, 합성이라는 모든 과정을 처리하게 함으로써, 검색 Horizon이 길어질수록 성능이 저하되거나 문맥 과부하(Context Overflow)로 인한 중도 종료 문제가 빈번하게 발생합니다 [Figure 1]. 또한, 단순히 외부 요약 모듈을 사용하는 방식은 추론 과정과 요약 과정이 최적화되지 않아 정보 손실이나 노이즈 보존 문제가 발생합니다. 저자들은 이러한 한계를 극복하기 위해 planning과 synthesis를 명시적으로 분리하고, 이를 하나의 정책으로 최적화할 수 있는 통합 프레임워크가 필요함을 지적합니다.
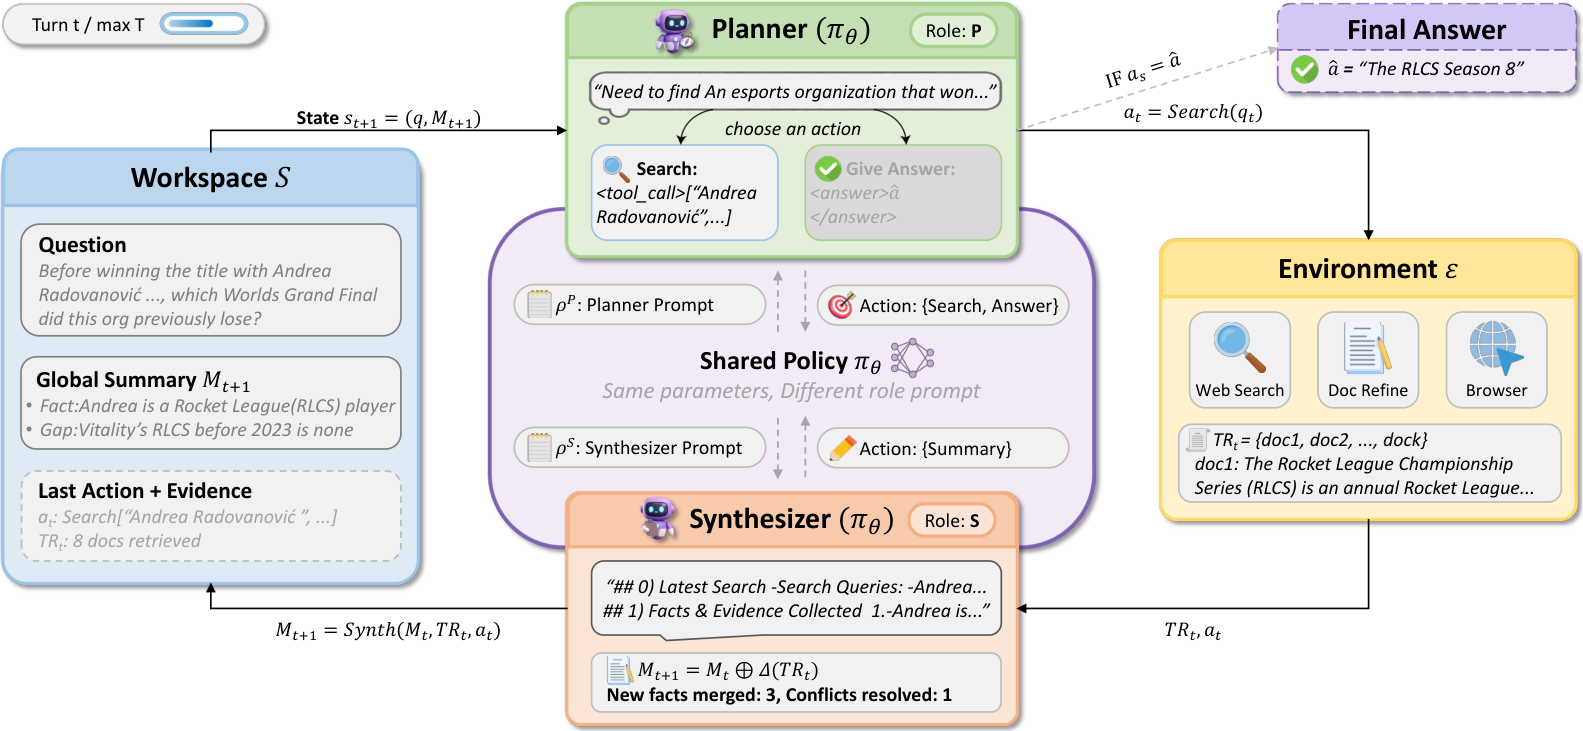
Figure 1 — IterSynth 전체 파이프라인
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Planner와 Synthesizer 역할을 반복적으로 수행하는 IterSynth 워크플로우를 제안하며, 이를 학습시키기 위해 RDPO 알고리즘을 도입합니다 [Figure 1]. RDPO는 최종 결과 보상(Outcome Reward)뿐만 아니라, 각 역할별 턴 단위 루브릭 평가(Rubric Evaluation)를 통합한 복합 보상을 사용하여 더욱 정교한 크레딧 할당을 가능하게 합니다 [Figure 2]. 특히, RDPO는 역할별로 Advantage를 독립적으로 정규화하여 학습의 안정성을 크게 높입니다 [Table 1]. 실험 결과, IterSynth-8B 모델은 BrowseComp, xBench-DS 등 5개의 벤치마크에서 평균 50.7%의 점수를 기록하였습니다. 이는 기존의 가장 강력한 8B 이하 에이전트 대비 4.2% 향상된 수치이며, 30B 급 모델들과 경쟁 가능한 수준의 고성능을 보여줍니다. 또한, Claude-4.5-Opus나 DeepSeek-V3.1 같은 프론티어 모델에 프롬프팅 기법으로 적용했을 때도 기존 ReAct 대비 최대 10.0%의 성능 향상을 기록하며 범용성을 입증했습니다.
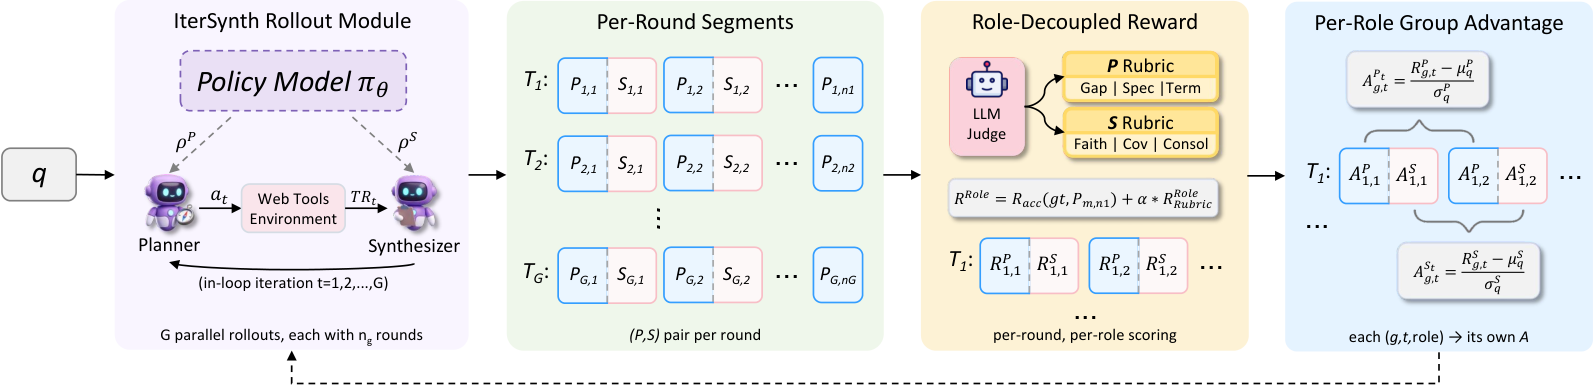
Figure 2 — RDPO 최적화 개요
4. Conclusion & Impact (결론 및 시사점)
본 연구는 역할 분리형 반복 합성(Role-Decoupled Iterative Synthesis) 패러다임이 장기적 딥 서치 성능을 극대화하는 핵심 전략임을 증명합니다. IterSynth는 모델 파라미터 증설 없이도 구조적 효율성을 통해 대형 모델에 준하는 성능을 확보했으며, RDPO를 통해 에이전트의 단계별 행동을 효과적으로 최적화할 수 있는 기반을 마련했습니다. 이 연구는 향후 에이전트 설계 시 복잡한 하드웨어 리소스 없이도 소프트웨어적 구조 개선을 통해 지능적이고 안정적인 자율 검색 에이전트를 구축할 수 있는 중요한 기술적 토대를 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] TREK: Distill to Explore, Reinforce to Refine
- [논문리뷰] Experiential Reinforcement Learning
- [논문리뷰] AV-GRPO: Modality-Anchored Decoupling Diffusion Reinforcement Learning for Joint Audio-Video Generation
- [논문리뷰] Beyond the Stability-Exploration Dilemma: Environmental Regularization for LLM Policy Optimization
- [논문리뷰] AgentMercury: Your Agent Can Synthesize Verifiable Environments for Business Scenarios at scale
Review 의 다른글
- 이전글 [논문리뷰] ExplorationBench: Measuring AI Systems' Exploration in Verifiable Alien Worlds
- 현재글 : [논문리뷰] IterSynth: Rethinking Deep Search Agents via Role-Decoupled Iterative Synthesis
- 다음글 [논문리뷰] Just Ask Jev: Reinforcement Learning for Calibrated Decisions as a Zero-Shot Detector of AI Alignment Failures
댓글