[논문리뷰] AV-GRPO: Modality-Anchored Decoupling Diffusion Reinforcement Learning for Joint Audio-Video Generation
링크: 논문 PDF로 바로 열기
저자: Zhiyu Xu, Weilong Yan, Yufei Shi, Shiyang Li, Yihao Liu, Kin-Man Lam, Yuewen Cao, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- AV-GRPO: Joint Audio-Video Generation을 위한 Modality-Anchored Decoupling Diffusion Reinforcement Learning 프레임워크로, 보상 신호 분리, 훈련 비용 절감, 그리고 모달리티별 동적 적응을 목표로 한다.
- Modality-Anchored Rollouts: AV-GRPO의 핵심 메커니즘으로, 한 모달리티의 궤적(anchor)을 고정하고 다른 모달리티(target)의 궤적들을 독립적으로 샘플링하여, 보상 신호를 분리하고 비교 조건을 제어한다.
- Trajectory Locking and Tower Freezing: 앵커 모달리티의 상태를 고정하고 타겟 모달리티 타워만 최적화하는 방식으로, 훈련 중 메모리 비용을 크게 줄이고 보상 할당(credit assignment)을 해당 타겟 타워로 집중시킨다.
- 5DAV Dataset: AV-GRPO 훈련을 위해 특별히 구축된 데이터셋으로, Semantic Hierarchy, Sound Source Type, Synchronization Difficulty, Temporal Complexity, Instruction Granularity의 다섯 가지 차원을 따라 완전히 분리(decoupled)되어 체계적이고 제어 가능한 Post-training을 지원한다.
- Flow-GRPO: 결정론적 Flow Matching 모델의 샘플러를 확률적 SDE로 변환하여 Online Reinforcement Learning을 적용하는 방법론으로, 각 Denoising Step을 정책으로 보고 최종 샘플의 보상을 활용하여 최적화한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 Joint Audio-Video Generation 모델들이 Per-modality Fidelity 부족, Text-Modality Alignment 미흡, 그리고 Cross-Modal Synchronization의 약점이라는 문제점을 겪고 있음을 지적한다. 이러한 한계점을 해결하기 위해 Reinforcement Learning-based Post-training이 유망한 접근 방식으로 부상했으나, 이를 Multi-modal Joint Generation에 단순히 확장하는 것은 여러 도전 과제를 안고 있다. 첫째, 이질적인 Multi-modal Rewards는 두 모달리티의 학습 신호를 얽히게 하고 보상 할당(credit assignment)을 모호하게 만든다. 둘째, 두 모달리티 타워의 최적화 Dynamics가 다름에도 불구하고 동시 최적화는 상당한 컴퓨팅 비용을 발생시킨다. 셋째, 샘플링된 Counterpart Modality에 따라 동기화 평가의 난이도가 달라져 공정한 보상 비교가 어렵다. 저자들은 이러한 문제들을 해결하기 위해 새로운 접근 방식인 AV-GRPO와 5DAV Dataset의 필요성을 강조한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Modality-Anchored Decoupling Diffusion Reinforcement Learning 프레임워크인 AV-GRPO를 제안한다. 이 방법론은 Audio-Anchored Video Optimization과 Video-Anchored Audio Optimization을 번갈아 수행하며, 이는 보상 분리, 훈련 비용 절감, 그리고 Modality-specific Dynamics에 대한 적응을 가능하게 한다 [Figure 1]. 주요 메커니즘은 다음과 같다: (1) Modality-Anchored Rollouts는 하나의 앵커 Trajectory를 고정하고 타겟 모달리티 Trajectory들을 독립적으로 샘플링하여 보상 목표를 분리하고 동기화 비교 조건을 제어한다. (2) Trajectory Locking and Tower Freezing은 앵커 상태를 고정하고 타겟 타워만 최적화하여 메모리 비용을 줄이고 보상 할당을 타겟 모달리티로 명확하게 유도한다. (3) Hyperparameter Decoupling은 모달리티별로 맞춤형 보상 구성, 노이즈 강도, 손실 가중치를 사용하여 비대칭적인 Audio-Video 학습 Dynamics를 지원한다. 또한, 불안정한 훈련을 방지하기 위해 Adaptive Noise Clipping (ANC)을 적용하고, 비디오 타워의 Over-exposure 문제를 해결하기 위해 LongCat-Video에서 영감을 받은 정책 및 KL 텀 Reweighting을 사용한다.
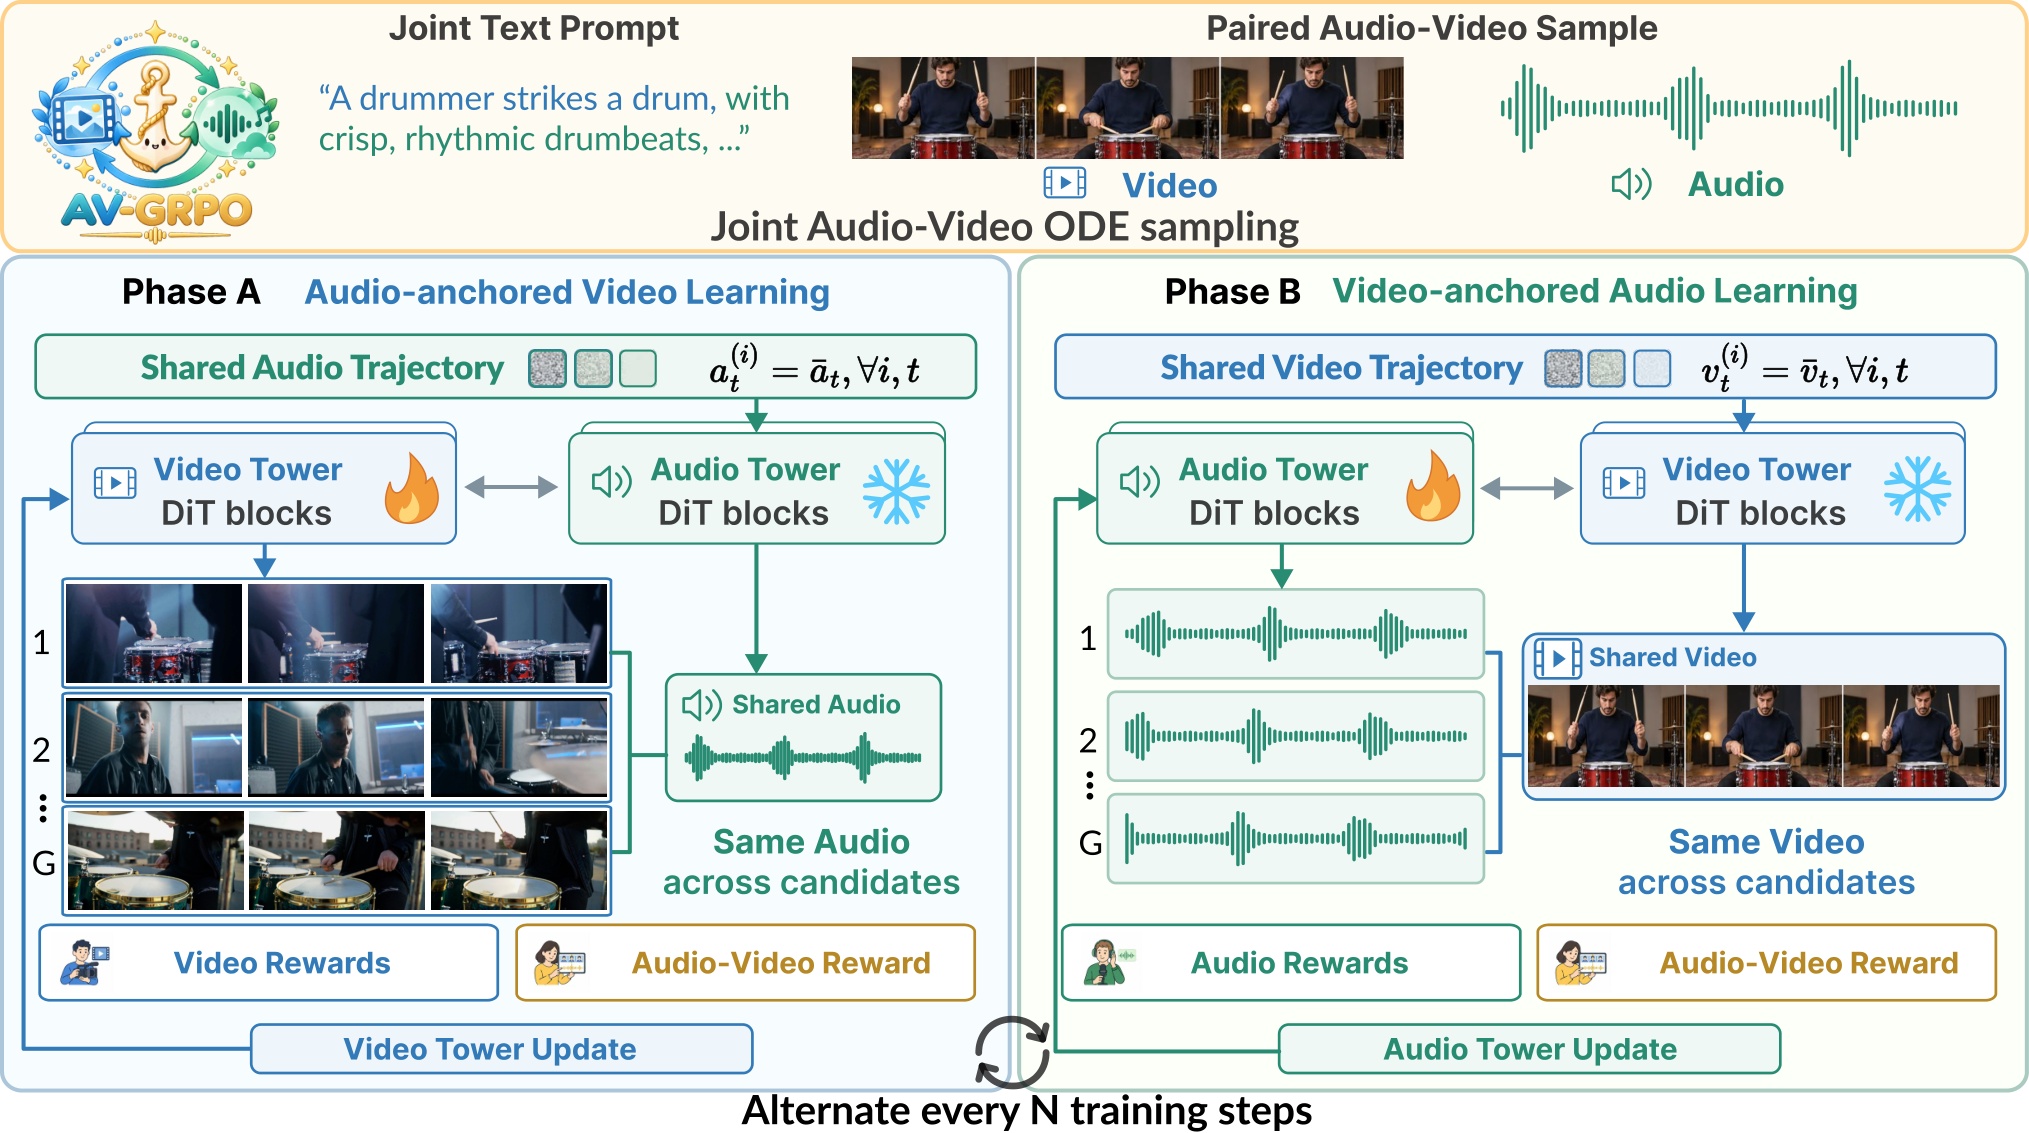
Figure 1 — AV-GRPO 훈련 파이프라인 개요
이러한 제안 방법론과 함께, 저자들은 체계적인 Post-training을 위한 5DAV Dataset을 구축했다. 5,760개의 프롬프트로 구성된 이 데이터셋은 Semantic Hierarchy, Sound Source Type, Synchronization Difficulty, Temporal Complexity, Instruction Granularity의 다섯 가지 독립적인 차원을 따라 De-coupling되어 있다.
실험 결과, AV-GRPO는 JavisBench와 VABench 벤치마크에서 LTX-2.3 (22B) 및 GDPO 대비 일관되게 우수한 성능을 보였다. 특히, Full Fine-tuning 설정에서 AV-GRPO는 JavisBench의 Audio Quality (AQ)를 LTX-2.3의 5.097에서 5.798로, VABench의 Audio Aesthetics를 3.319에서 3.631로 향상시켰다. Semantic Alignment 측면에서는 JavisBench의 CLIP 점수를 0.318에서 0.327로, CLAP 점수를 0.408에서 0.468로 개선했다. Cross-modal Consistency 및 Synchronization 지표에서도 상당한 향상을 보였는데, 예를 들어 GDPO 대비 JavisBench의 AV-IB는 0.224에서 0.247로, DeSync는 0.708에서 0.607로 개선되었다 [Table 1, Table 2]. 이러한 정량적 결과들은 AV-GRPO가 Perceptual Quality, Text Alignment, Cross-modal Coherence 및 Synchronization 전반에 걸쳐 넓은 범위의 이득을 제공함을 입증한다. 정성적 분석 역시 AV-GRPO가 생성된 Audio-Video 콘텐츠의 Fidelity와 동기화 측면에서 원본 모델 대비 개선을 달성했음을 보여준다 [Figure 2]. 어블레이션 연구를 통해 5DAV Dataset의 효과와 Alternating Optimization의 이점 또한 검증되었다 [Figure 3].
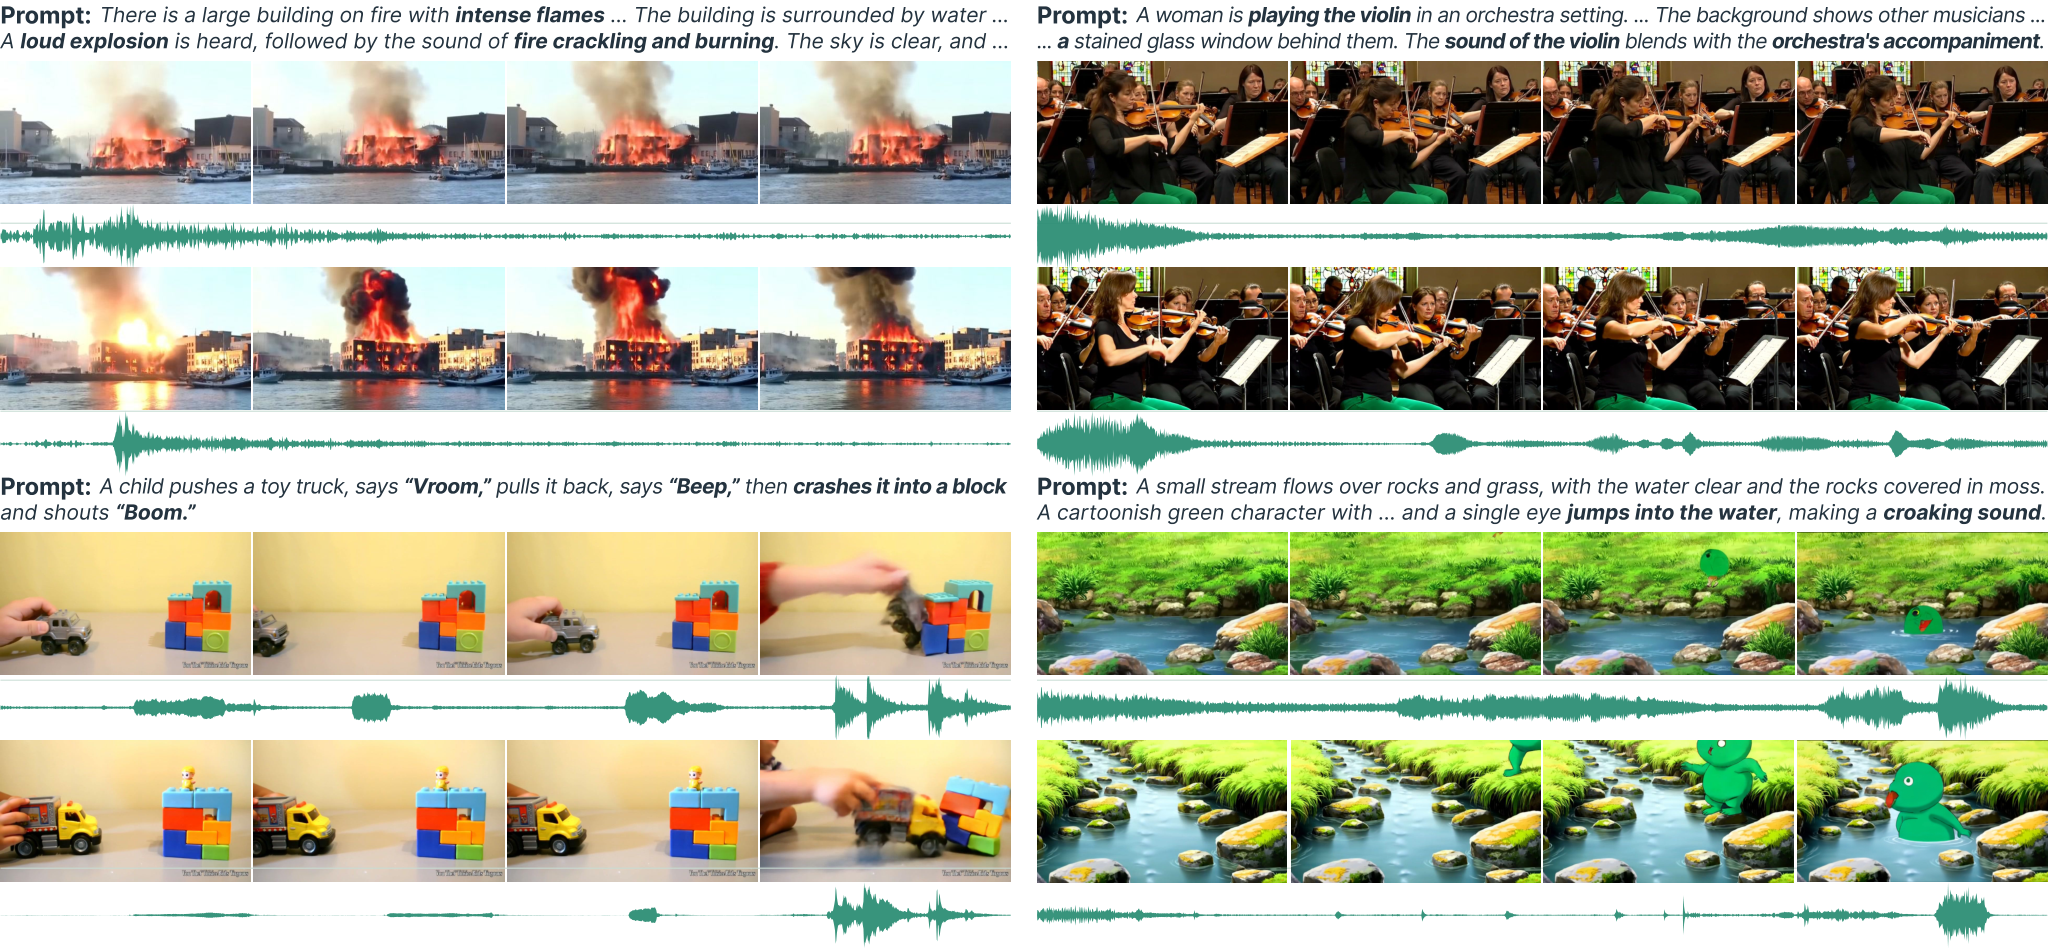
Figure 2 — AV-GRPO 정성적 비교 결과
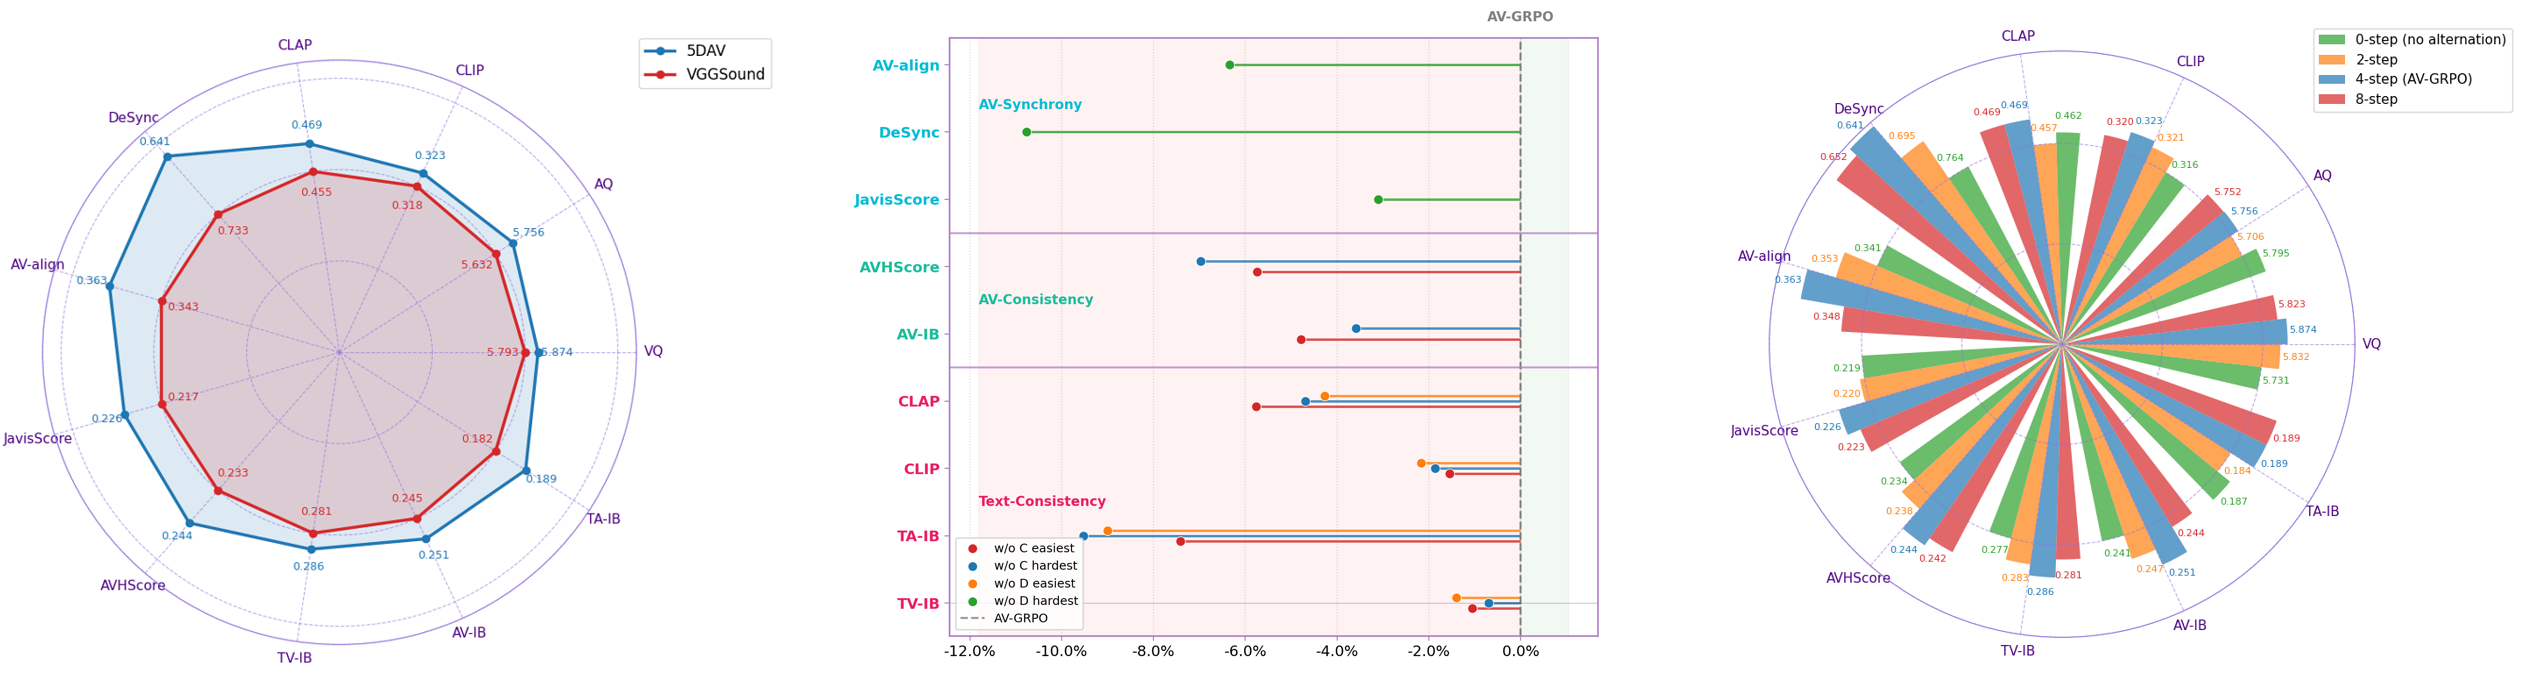
Figure 3 — 어블레이션 연구 결과
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Modality-Anchored Reinforcement Learning 프레임워크인 AV-GRPO를 통해 Joint Audio-Video Post-training의 기존 문제들을 성공적으로 해결했다. Anchored Rollouts와 Alternating Frozen-Tower Optimization을 결합함으로써, AV-GRPO는 보상을 효율적으로 분리하고 비교 조건을 제어하며, 훈련 오버헤드를 줄이고, 보상 할당을 명확히 하며, Modality-specific Dynamics 및 샘플 난이도에 적응할 수 있게 한다. 또한, 저자들은 제어 가능한 Post-training을 위한 Five-dimensionally Decoupled 5DAV Dataset을 도입했다. JavisBench와 VABench에서의 실험 결과는 Perceptual Quality, Text Alignment, Audio-Video Coherence 및 Synchronization 측면에서 LTX-2.3 및 GDPO 대비 일관된 성능 향상을 보여주었다. 이러한 성과는 Audio-Video Generator의 개선을 위한 효과적이고 확장 가능한 접근 방식을 제시하며, 학계 및 산업계 전반에 걸쳐 보다 사실적이고 일관성 있는 Multi-modal 콘텐츠 생성 기술 발전에 크게 기여할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Reinforcement Learning from Rich Feedback with Distributional DAgger
- [논문리뷰] FIPO: Eliciting Deep Reasoning with Future-KL Influenced Policy Optimization
- [논문리뷰] Hindsight Credit Assignment for Long-Horizon LLM Agents
- [논문리뷰] InfoPO: Information-Driven Policy Optimization for User-Centric Agents
- [논문리뷰] Reinforcement Learning via Self-Distillation
Review 의 다른글
- 이전글 [논문리뷰] Tri-PvP: Exposing Modality Bias in Omni-Modal Large Language Models through Perceptual-Propositional Evidence Conflicts
- 현재글 : [논문리뷰] AV-GRPO: Modality-Anchored Decoupling Diffusion Reinforcement Learning for Joint Audio-Video Generation
- 다음글 [논문리뷰] Agent-Editing World Model: Rethinking World Modeling for LLM Agents
댓글