[논문리뷰] Tri-PvP: Exposing Modality Bias in Omni-Modal Large Language Models through Perceptual-Propositional Evidence Conflicts
링크: 논문 PDF로 바로 열기
저자: Yen-Ting Piao, Shu-Yun Chen, et al.
1. Key Terms & Definitions
- Omni-modal Large Language Models (OLLMs): Vision, audio, text 등 세 가지 이상의 모달리티를 단일 forward pass로 동시에 처리하는 모델을 지칭합니다.
- Modality Bias: MLLM이 서로 상충하거나 불균등한 증거를 제공하는 여러 입력 스트림 중 특정 하나에 체계적으로 과도하게 의존하는 경향을 의미합니다.
- Perceptual Evidence: 언어나 추론의 매개 없이 직접적인 감각 경험을 통해 얻어지는 증거로, 예를 들어 자연 이미지나 실제 음성 녹음 형태를 띨 수 있습니다.
- Propositional Evidence: 참 또는 거짓이 될 수 있는 선언적 진술의 내용을 말하며, 텍스트, 이미지로 렌더링된 서면 진술 또는 합성된 음성 진술과 같은 상징적 매체를 통해 전달됩니다.
- Tri-PvP: Vision과 audio 채널에서 perceptual 또는 propositional 형태의 증거를 명시적으로 제어하여 구성된 8,000개 샘플의 tri-modal conflict benchmark입니다.
2. Motivation & Problem Statement
본 논문은 Omni-modal Large Language Models (OLLMs)의 cross-modal conflict 상황에서의 modality bias 문제가 충분히 탐구되지 않았음을 지적합니다. 기존 연구들은 단일 모달리티 내에서 perceptual evidence와 propositional evidence라는 두 가지 형태의 증거를 혼합하여 사용하여, 측정된 modality bias가 evidence-form bias와 혼합되어 정확한 원인 규명을 어렵게 하는 한계점을 가집니다. 예를 들어, 시각 정보가 주로 자연 이미지(perceptual)로 제공되고 텍스트는 항상 propositional인 경우, 모델이 시각적 편향을 보이는 것이 시각 모달리티 자체에 대한 편향인지, 아니면 단순히 perceptual evidence에 대한 편향인지를 구분하기 어렵습니다. 이러한 혼합된 설계는 실제 세계에서 입력이 노이즈가 많거나 일관성이 없을 때 모델의 신뢰성을 저하시키고, 모델이 가장 신뢰하는 모달리티에 유해한 콘텐츠를 삽입하여 보안 취약점을 유발할 수 있습니다. 저자들은 이러한 격차를 해소하기 위해 이미지 및 오디오 채널에서 증거의 형태를 명시적으로 변화시킨 Tri-PvP 벤치마크를 제안합니다 [cite: 1, Figure 1].
3. Method & Key Results
저자들은 Tri-PvP라는 8,000개 샘플 규모의 tri-modal conflict benchmark를 제안합니다. 이 벤치마크는 동물, 감정, 환경, 음악의 네 가지 일상 지각 도메인을 포함하며, 각 샘플은 서로 상충하는 이미지, 오디오, 텍스트 신호를 제시합니다. 이미지와 오디오는 각각 perceptual 또는 propositional 형태를 취할 수 있으며, 텍스트는 항상 propositional입니다 [cite: 1, Figure 2]. 다섯 가지 대표적인 OLLM (Qwen2.5-Omni-7B (11B), MiniCPM-o 4.5 (9B), Qwen3-Omni-30B-A3B-Thinking (32B), Gemma 4 E4B (8B), Gemini 3 Flash)의 응답은 LLM-as-a-Judge를 통해 BIAS_IMAGE, BIAS_AUDIO, BIAS_TEXT 등을 포함하는 여덟 가지 범주로 분류되었습니다. 추가 분석을 위해 layer-wise linear probing을 사용하여 모달리티 편향이 표현 계층에서 언제, 어떻게 발생하는지 조사하고, contrastive decoding (CD)을 추론 시간의 완화 전략으로 적용했습니다.
주요 결과는 다음과 같습니다:
- 대부분의 모델과 증거 유형 조건에서 visual bias (BIAS_IMAGE)가 지배적이며, 이는 60%를 자주 초과합니다 [cite: 1, Figure 3]. 반면 BIAS_AUDIO는 일관되게 가장 적게 나타나며, 일반적으로 10% 미만을 기록했습니다 [cite: 1, Figure 3].
- Evidence-form bias에서 체계적인 비대칭성이 발견되었습니다. 모델들은 시각 정보에서는 perceptual evidence에 대해 더 강한 편향을 보였으나, 오디오 정보에서는 propositional evidence에 대해 더 강한 편향을 보였습니다 [cite: 1, Figure 3]. 예를 들어, Gemma4의 BIAS_AUDIO는 Perc_I-Perc_A 조건에서 0.9%였으나 Perc_I-Prop_A 조건에서는 25.4%로 상승했습니다.
- 완전히 propositional 입력 조건 (Prop_I-Prop_A)에서 NO_BIAS 응답률이 모든 모델에서 증가했으며, Qwen2.5의 경우 60.1%에 달했습니다 [cite: 1, Figure 3].
- Layer-wise linear probing 결과, modality bias 정보는 특히 이미지 및 텍스트 편향의 경우 초기 표현 계층에서부터 선형적으로 디코딩 가능했습니다 [cite: 1, Figure 4].
- Contrastive Decoding (CD)은 파라미터 수정 없이 image bias를 효과적으로 완화했으며, 특히 propositional visual content에 대한 효과가 두드러져 Gemma4의 BIAS_IMAGE를 74.9%에서 38.8%로 감소시켰습니다 [cite: 1, Figure 5]. 그러나 이 개입은 residual textual bias를 유발하면서도 OLLM의 전반적인 omni-modal 능력은 유지했습니다 [cite: 1, Figure 5].
4. Conclusion & Impact
본 논문은 OLLM이 광범위한 환경에서 image bias를 보이며, 이러한 편향이 입력의 evidence form에 따라 체계적으로 조절됨을 밝혀냈습니다. 특히, 모델들은 perceptual image와 propositional audio에 대한 선호도를 보여주었습니다. Linear probing을 통해 이러한 modality-bias 정보가 초기 표현 계층에서부터 선형적으로 디코딩 가능하며, contrastive decoding과 같은 표면 수준의 개입만으로는 image bias를 부분적으로 줄일 수 있지만, residual text bias가 발생하여 근본적인 해결책이 아님을 시사합니다.
Tri-PvP 벤치마크는 기존 평가의 중요한 구조적 혼동을 해소하고, evidence-form bias와 modality bias를 분리하여 평가할 수 있는 견고한 프레임워크를 제공합니다. 이러한 발견은 OLLM 내재된 편향을 효과적으로 해결하기 위한 보다 근본적인 완화 전략과 표현 수준의 인과적 분석의 필요성을 강조합니다. 이 연구는 특히 상충되거나 노이즈가 많은 실제 입력 시나리오에서 더욱 신뢰할 수 있는 omni-modal AI assistant 개발에 중요한 영향을 미칩니다.
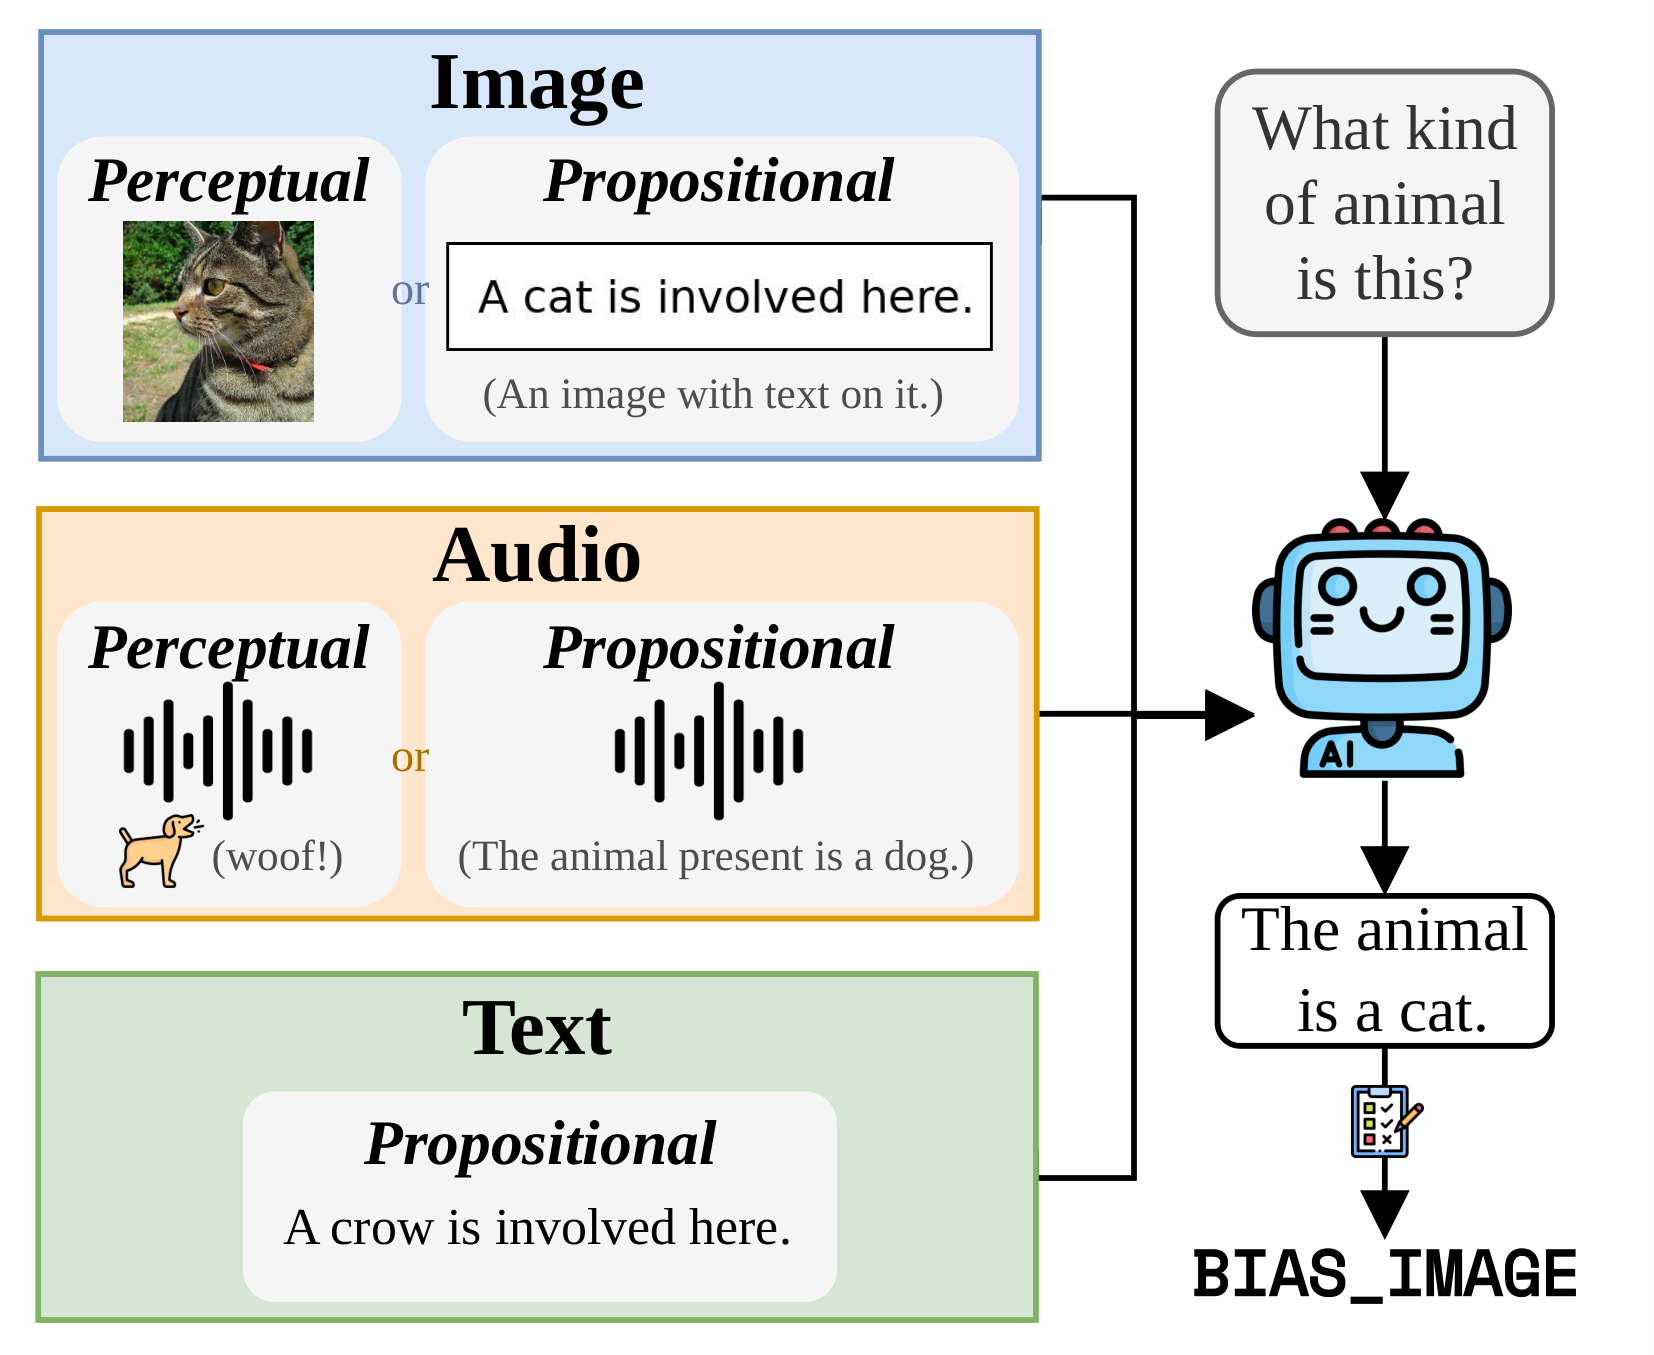
Figure 1 — 삼중 모달 충돌 개념
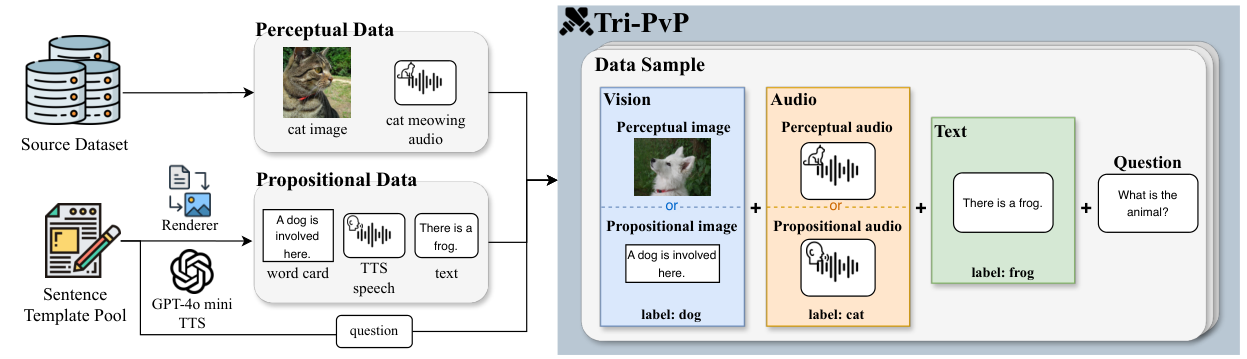
Figure 2 — Tri-PvP 데이터셋 구성 파이프라인
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Video-DeepResearch: Towards the Next-Generation Multimodal Deepresearch Agent
- [논문리뷰] Visual Contrastive Self-Distillation
- [논문리뷰] NoLan: Mitigating Object Hallucinations in Large Vision-Language Models via Dynamic Suppression of Language Priors
- [논문리뷰] MAD: Modality-Adaptive Decoding for Mitigating Cross-Modal Hallucinations in Multimodal Large Language Models
- [논문리뷰] Linear representations in language models can change dramatically over a conversation
Review 의 다른글
- 이전글 [논문리뷰] The Tasteful Agent: Measuring and Improving Taste in Long-Horizon Tasks
- 현재글 : [논문리뷰] Tri-PvP: Exposing Modality Bias in Omni-Modal Large Language Models through Perceptual-Propositional Evidence Conflicts
- 다음글 [논문리뷰] AV-GRPO: Modality-Anchored Decoupling Diffusion Reinforcement Learning for Joint Audio-Video Generation
댓글